2012年11月27日火曜日

CLC Genomics WorkbenchでPacBioデータ

11月はあっという間に過ぎていきました。
サンフランシスコで人類遺伝学会があり、本当はその報告もしたいのですが、日常の仕事に追われ・・・。
PacBioのセミナーは、既に論文やプレゼンで知っている内容だったので、私にとっては驚きは少なかったのも影響してるのかな? 

アカデミックな報告ではありませんが、Linked-Inでつながっていてまだあったことの無かったひとと、会場で会い、ランチをご馳走になりました。
前ブログ「ショートリードの憂鬱」での、PacBioの最初の紹介が、Expression Analysisというボストンの受託会社のウェブセミナーを見たあとだったのですが、当時からその会社の担当者とはLinkedInでやり取りしていて、今回やっと会えました。 CEOにも会ってきました。
そこでの会話の内容はお伝えできませんが、同じPacBioユーザ同士、共感できるものがありました。

また展示会場のCLC-Bio社のブースで、前職にいたとき知り合った、CLCデンマーク本社のひとと1年ぶりくらいに会いました。 懐かしかった。
というわけで今日はCLCの話。

Genomics Workbenchは、使い勝手の良いソフトですが、まだPacBio用の入口がありません。
しかし、諦めるのはまだ早い! 
まず、Pacのリード(filtered_subreads.fastq)は、Import>Illumina ( !! )からインポートします。
Quality value はNCBI/Sanger を選びます。 Paired-endとかのチェックは全て外します。
PacBioのデータはHiSeqとかに比べると桁違いに小さいので、Windows版のDesktop Editionでも十分使えるでしょう。

インポートが無事終わると、このようになります。 シーケンスの塩基数に注目! 10000bp 越えもある!
 
今のはfilterd_subreads、この意味は、SMRT PortalというPac付属のソフトで、
  1. Read長が5000 base 以上
  2. Sub-read長が5000 base以上
  3. Read Qualityが75以上
などという基準でフィルタリングした後のsubreadということです。
まだエラーコレクションも何もしていません。
 
Pacのエラーコレクションで、pacBioToCAというものがあります。 これを流すと、CCSなどのHighクオリティショートリードでCLRの精度が高まります。
こいつのOutputが、fasta + qual ファイルです。
fasta + qual形式ファイルの「エラー修正subread」を取り込むには、Import > Roche 454 ( !! ) 
fasta と qual ファイルを選んだらNextボタンでインポート
というふうにするとちゃんと入ります。 

まあ、fasta と qual があれば、fastqファイルが作れますけどね。
既に誰かが作ったfasta+qual --> fastq converterはいろいろあると思いますが、私はSEQanswersのこのスレッドに出ていた、このスクリプトはいいのでは?と思います。Perlで動きます。
メモリに全部展開するのが嫌?なひともいるでしょうけど。

さて、リードを入れて何が面白いかというと、CLCのGenomics Workbenchはレポート機能が充実しているからそれをやってみると、Pacのデータの特徴が簡単に見えるのです。GCの割合や、リード長の分布、なども1つのレポートにまとまっているから便利。
下図の左はエラーコレクション前、右はエラーコレクション後の、クオリティ(Phredスコア)の分布図です。 例えばこんなグラフを見て、確認しながら、LinuxのPacサーバに戻ってアセンブる。

 
Pacサーバでアセンブるわけは、Genomics Workbenchのアセンブラーが、de Bruijn Graph 式アセンブラーだからです。
ハイスループットのショートリードには向いていますが、長さがバラバラの超ロングリードには向いていないかも(あくまで「かも」ですが)しれません。
現バージョン5.5.1では、k-mer を64以上には増やせないようですので、これ以上のk-mer では試して無いのですが、どうでしょう?
k-mer=64 ではアセンブルの成績は良くありませんでした。


Genomics Workbenchでリードが取り込めれば、リファレンスがあればマッピングも、できます。
上側がエラーコレクション後、下がコレクション前です。E.coliのデータです。
マッピングパラメータはデフォルトでやったのですが、この例では、エラーコレクション前はSubread全体の37%しかマッピングできませんでした。それがエラーコレクションをした後は、99%以上がマッピングされました! 


SMRT Portal/Analysis というPacBio付属のアセンブラーやマッピングツールも勿論よくできています。 Pacデータをガッツリ解析するにはこっちの方が向いているでしょう。
GUI以外にコマンドラインも充実しています。
また、最初のsubreadフィルタリングなどには必須です。

でもCLCのGenomics Workbenchは、レポート機能が充実している、というか、手軽にデータを確認できるという点で優れていると思います。

2012年10月25日木曜日

SMRT Cellに使用期限がある理由


NHKの、「探検バクモン」という番組で、東京国立近代美術館フィルムセンターの潜入をやっていました。 

名画から普通の映画、珍しい映画や成人映画まで、およそ6万5000本の国内映画のマスターフィルムを、国が保存しているそうです。こんな施設があったとは知らなかった!
「仕分け」されなくて良かった。

目からウロコだったのは、フィルムというのは原料にセルロースを含んでいるので、高温多湿に弱く、ほっておくと酸化してしまってすぐにダメになってしまうそうです。
ここでは温度5度、湿度40%の秘密の倉庫で管理しています。
フィルムって、有機物だったんだ、って思いました。

有機物って言えば、SMRT Cellもそうなんです。
PacBioでシーケンスに使われる、あのタテヨコ1cmくらいのチップです。

SMRT Cellにある15万もの穴は、ZMWと呼ばれ、その底でシーケンス反応が進みます。
穴の底にはビオチン分子があらかじめ接着されていて、反応溶液+ライブラリーを入れたときに、ライブラリーに結合しているポリメラーゼがビオチン分子に結合し、底に固定化されるわけです。
Korlach et al., Selective aluminum passivation for targeted immobilization of single DNA polymerase molecules in zero-mode waveguide nanostructures. より

ビオチン分子をZMWの底に接着させる作業は、Cell作製の比較的早い段階で行われます。
かなりシークレットな情報なので大雑把に言うと、半導体のウエハーってわかりますか? 丸い大きな薄い板みたいなやつです。
あれ一枚から数百個のCellができるのですが、最初にZMWという穴をあけて、ビオチン分子を接着させます。 
その後、穴以外を薄いガラスでコーティングしたり、洗浄したり、1個1個にしたり、60以上の工程を経て、晴れてSMRT Cellが完成します。
以上はダストフリーの、本当に半導体工場みたいなところで行われています。

というわけで、SMRT Cellには、出荷段階で各ZMWに、すでにビオチン分子がくっついています。
これは紛れもなく有機物なので、温度と湿度に弱いのです。
使用期限があるのはそのためです。


ところで最近見た映画は何?と聞かれて、
「アベンジャー」と答えるのはダメですか?

ちゃんとフィルム映画をみなきゃいけませんね。

2012年10月21日日曜日

LSC Long-Readのエラーコレクション

秋は学会・展示会シーズンですね。 
私は10月10日のBioJapan、10月15日のCBI、に行きました。 
来週の日本遺伝学会は残念ながら行けないのですが、来月サンフランシスコで行われるアメリカ人類遺伝学会には行く予定です。
今から楽しみです!

10月10日のBioJapanでは、前回のブログでも書きましたが、沖縄県のセミナーでPacBioの発表がありました。
そこでちょっとサプライズゲストとして、PacBioの創始者で現CTO、Steve Turner氏の挨拶を頂きました。
その場にいたひとは聞いたと思いますが、PacBioはこれからも進化します。 
リード長ももっと長くなります。
新酵素の開発、新ケミストリーの開発、Movie開始時期の改良、ソフトウェアの改良・・・。

そこで良く聞かれるのが、「リードは長くなっても、精度は低いままじゃあちょっと・・・」という声。

リード単位の精度はもっと上がるのか? 
リファレンスにアラインしたとき、塩基がリファレンスと異なる(InDelも含め)率が約15%
これが劇的に改善されるか?
本音はというと、ちょっと・・・

そこで、バイオインフォマティクスでエラー率を低くする方法がたくさん開発されているのです。

7月5日のブログにも書きましたが、エラーコレクションといえば、Nature Biotecで発表されたpacBioToCA が有名?でしょうか。 最近のセミナーでも、さかんにこれを使った発表がされています。

そんな中、先週別のアルゴリズムが論文化されました。 これはRNA-Seq用にも適したエラーコレクションアルゴリズムだそうです。

Au et al.,  Improving PacBio Long Read Accuracy by Short Read Alignment
PLoS One 7(10), e46679.

Homopolymer Compression という方法で例えば、GCGAAAATA => GCGATA
に情報を圧縮します。 Pylosequencerなどでのエラーコレクションに使われる手法で、これをPacBioにも応用しています。
情報量は意外と失われないそうで、私も近いうち試してみたくなりました。
 

pacBioToCAと同様、ショートリードでPacのロングリードを「修正」するアルゴリズムですが、Mammalianのトランスクリプトーム用に開発されただけあって、メモリー消費やラン時間に工夫がされているようです。 pacBioToCAは処理時間が長い、LSCよりメモリを食う、と。
LSCというのがこのアルゴリズムの名前です。

軽いなら是非試してみたい!
ツールも公開されていますので。
そのうちこのツールを使用した発表も、学会などで多く見られるようになるでしょう。

そういえば今年の7月くらいにPacBio本社で、cDNA解析のPacでの可能性についてディスカッションをしたとき、マッピングの方法と合わせて、エラーコレクションの話をしたことを思い出しました。 
ちなみにPac社内では、「error correcton」という言葉を嫌うひともいます。
correction = 修正です。 修正するってことは、もとが間違っているということ。 なるほど。
ですので、私は気を利かせて「improve accuracy = 精度の向上」と言うようにしています。
ま、単なる言葉ですけど。

ショートリードでロングリードを「修正」する方法は目新しくなくなりましたが、「修正」すること無しにAccuracyを良くする方法も出てきています。
それがQuiverというツールです。 
これに関してはまた今度。

最後に、精度には2つの意味があります。
リード単位の精度とマッピング精度です!

リード単位の精度ではショートリードの方がずっと良い。 これは認める。 
では、リファレンスやゲノムにマッピングさせたときの、真の場所に正しくマッピングされるという意味での精度は、どうか?
Yes! ロングリードであればある程、良い、でしょう。

本当はリード一本で精度がphred 40 以上くらいあって、かつ数十キロ以上読めれば(+低コストで)、向かうところ敵無しなんでしょうが。
まだ無理かなあ。

2012年9月26日水曜日

PacBioを使った国内での研究

東京大学農学部2号館で開催された、インフォマティクスオープンセミナーに行ってきました。
"Challenge to de novo sequence of relatively large genomes with new sequence technologies"
BGI、東京大学 大学院農学生命科学研究科
アグリバイオインフォマティクス教育研究ユニット
新学術領域「複合適応形質進化の遺伝子基盤解明」共催
http://www.iu.a.u-tokyo.ac.jp/main_event.html

演題は5つあり、そのうち3つにて、PacBio RSのデータを使った話があるとのこと、これは "Must Lissen to" だろうと思っていましたが、まさにその期待通りの内容でした。

de novo Assembly がテーマなので、非モデル生物のゲノムプロジェクトの話、どうやって数ギガのサイズのアセンブリを遂行させるか、PacBioを使ったときの良いところ、改善が必要なところ、エラーコレクションの方法、リピートの処理について …etc.

改めて言うまでもないかもしれませんが、高等生物のゲノムアセンブリの場合、リピートの扱いがとても厄介なんです。 複数の繰り返し配列、segmental duplication などは、ショートリードではちゃんと正確に読むことが難しいかほぼ不可能。

そのためロングリードが救世主となるわけなんですが、Pacといえども短所があります。
長さが一定では無い(例えば出力リードの長さが "平均" 3Kbであること)
シーケンスエラーが他のテクノロジーと比べると高い(15%くらい)
ランコストがまだまだ高価(というと怒られるかもしれませんが)
などです。
そこを考慮しても、他のシーケンサーでは得られない「超ロングリード」という長所が、de novoのアセンブリにはとても魅力的なんですね。

話のほとんどがまだ論文途中のものでした。
ですが皆さん、結構オープンに話していて、会場も質疑応答が絶えませんでした。

知っての通り、PacBioはまだ日本に来て1年も経っていません(2012年9月現在)。 ですから、実際どんなもの何だろう? 本当に使えるのか?と疑問に思っている研究者は多いと思います。

アメリカでは、Early Accessと言って2年以上前から導入されていたところもありますし、現在も多くのユーザーがいて、ノウハウもだいぶ蓄積されつつありますが、なかなか日本には情報が入って来ないと思います。
そんな中、日本のPacBioユーザー、あるいはBGIのような日本のPacBioユーザーの共同研究先が、本音で語ってくれるこのような会はとても貴重でした。
我々メーカーが宣伝するより何倍もインパクトがありますからね。
オーガナイザーの長谷部先生、西山先生、門田先生には感謝です!!


さて、今回の他にも、Pacを使った日本での研究例をもっと知りたい!という方にお勧めのセミナーがあります。

10月10日(水)、パシフィコ横浜で開かれるBio Japan 2012で、「先端シーケンサーが拓く沖縄生物資源」と題したスポンサーセミナーがあります。 詳細プログラム
沖縄工業技術センターの照屋先生の講演がPacBioを使ったゲノム解析についてです。
当日、ちょっとしたサプライズも用意していますので、時間と興味のある方は是非参加したらいかがでしょう?
無料ですが、参加にはBioJapanの公式ホームページから登録する必要があるそうです。

2012年9月25日火曜日

論文紹介:SNP検出のバリデーションに使用!

最近、PacBioを使っての論文がたくさん出ています。
一番最近のは、PacBioの超ロングリードに対応したMappingツール、BLASRのアルゴリズム
Mapping single molecule sequencing reads using Basic Local Alignment with Successive Refinement (BLASR): Theory and Application (PMID: 22988817)
このBLASRというMappingツールは、PacBioの二次解析ソフトウェアについてきます。
もちろんフリーなので、PacBioのユーザー以外でも使うことができます。

このBLASRがまだ前のバージョンだった頃、Broad Instituteでは、既存の有名なMappingツール、BWA-SWを使ってPacBioで読んだターゲットリードをゲノムにMappingし、その後GATKでSNPを検出、既にショートリードシーケンサーで検出したSNPを検証しています。
検証にはPacBioの他にFluidigmも使用しています。

Medulloblastoma exome sequencing uncovers subtype-specific somatic mutations. (PMID: 22820256)

92人の髄芽腫と健常人のサンプルを比較しての変異解析です。
Whole-Exomeキャプチャー法で33Mbの範囲を、HiSeq2000 2x76bpでディープシーケンスし、統計的有意な12の遺伝子変異を見つけています。
この変異遺伝子のコーディング領域をFluidigm Access ArrayとPacBio RS で読んで、検証しています。

髄芽腫の、Whole Genome Amplification サンプル(PCR増幅)と、Native DNAサンプルそれぞれ48ずつ、バーコードシーケンスしています。 ちなみにPacでバーコードはまだ製品になってません。

20ラン行い、フィルタリング後のリードが389,215本、サブリードは 4,367,852本、そのうちサンプル由来だとわかったのは64%の2,834,170本のサブリード

このサブリードを、hg19に対してBWA-SWマッピング、GATKを使ってBase-quality recalibrationとSNP 検出。
検出した変異候補は、IGV上でマニュアルキュレーションし、カバレージが十分にあった19の変異を検証しています。

結果ですが、リードごとのエラー率は高いけれど、カバレージを稼いでコンセンサス配列にするとSNPバリデーションに十分使え、実際に2bp detetion をCTDNEP1遺伝子で確認しています。
他のショートリードテクノロジーは、エラーが起こる場所に配列的特異性があり、ランダムでは無いので、コンセンサスにしてもエラーの高い場所と低い場所ができます。
PacBioのエラーは全くランダムに起こる(と言われている)ので、そのぶん、ショートリードで見つけた変異の検証に向いているということです。
しかし、PCRで十分増幅されなかった他の変異箇所、またGenomc DNAを十分な量得られなかった変異箇所は検証に使用できませんでした。

これの補助的論文として、
Pacific biosciences sequencing technology for genotyping and variation discovery in human data. (PMID: 22863213)

があります。
BWA-SWのパラメータは、
  • Missmatch penalty を3から5へ
  • Gap open penaltyを5から2へ
  • Gap extension penaltyを2から1へ
  • Heuristics (信頼性・精度)を1から20へ (Ampliconは精度が高い)
と工夫しています。こちらの論文はAmpliconを読んでいます。 同じパラメータを髄芽腫論文でも使用しているそうです。
 
この論文の途中、次のような一文があります。
“…Pacific Biosciences does not provide a simple measure of base quality score. Instead the software uses the instrument’s estimated insertion error probability as the base’s quality score.”
疑問に思って著者に聞いてみました。
この論文が書かれた時は、PacBioのSMRT Analysisという二次解析ソフトでBLASRマッピングをしてBAMを出すときに、Qualityがinsertionのエラーだけを基本に算出されていたので、実際の質とかけ離れていると問題だったそうです。
それで彼らもBLASRを使わずにBWA‐SWを使ったわけです。
今のPacBioのソフトは彼らが考えた、"PacBio Processing Pipeline" を取り入れ、Insertion以外のエラーも基本に「ある程度正しい」塩基クオリティを出すようになったそうです。
 
今度は誰かが、そのクオリティはどれくらい確かか、を研究対象にした論文を出しそうな予感が・・・。


2012年8月27日月曜日

DNAはたくさん必要

もうすぐ9月だというのに、まだ暑いですねえ。
私は蚊が嫌いです。 夜中でも殺すまでは寝られません。
書いている今も、どこかに蚊がいるんですよね。 「虫よけ当番」を枕元に置かなきゃ。

ま、それは置いておいて、PacBioは1分子シーケンスを売りにしています。
基本的にPCR増幅はしません。
想像はつくと思いますが、そうするとスタート時にDNAはたくさん必要になるのです。
ちなみに今は、2本鎖のDNAだけ、からスタートできます。

スタート時に必要なDNA量ですが、サイズによっても違いますが、大体、10Kbのライブラリーで読むときは、9μgくらいは必要でしょうか?
と、これはアメリカの受託会社、Expression Analysis (EA)のドキュメントが公開している数値です。
Webで公開しているので書いても良いでしょう。
ドキュメントはここ(http://www.expressionanalysis.com/platforms/category/pacific_biosciences/
のページの、右上の、Comprehensive PacBio RS Overview というところからダウンロードできます。
実は、この会社との出会いが、私をPacBioにのめり込ませたのですが、この会社は、アメリカでマイクロアレイやシーケンサーの実験・解析受託をしています。
昨年の6月に、PacBioのサービスを始めて、安定してビジネスを展開しているそうです。

さて、DNA必要量の話に戻りますが、9 μg という数値はかなり多いでしょう。
シェアリングして、End-repairして、Ampure Washして、…と進めていくと、ライブラリーにするころには、750 ~ 1250 ng が予想される回収量になるそうです。
(なるそうです、と書きました。いえ、私も予想回収率くらい知っているんですよ。でもPacBioのプロトコールはWeb公開されていないので、ブログで書くのはまずいからあくまで第三者のふりしてます。詳しく聞きたい方は別途)
EA社はこの場合、20 ~ 35のSMRT Cellが使用できる、と書いています。

で、データはどれくらい出てくるか、ですが、10Kbで90分Movieで読んだとき、生データで最長20Kb、クオリティフィルタリングした後で14.6Kb
平均リード長は、生データで3.7Kb、フィルタリング後で2.6Kb
フィルタリング後のリード数は44,232本、塩基数は116Mb

このデータは、比較的現実に沿った数値です。
チャンピオンデータではありませんが、いろいろなサンプルをやった経験値でしょう。

フィルタリングの条件は、リードにはそれぞれRead Qualityという精度の指標があるのですが、これが 75/100 以上であることと、クオリティの良い部分のリードの長さが50bp以下ではないこと、です。
これにひっかかるリードは除去されます。
そうして残ったリードの、平均長が 2,600 bp、Maxが14,600 bp ということなんですね。

Read Quality 75以上、リード長50bp以上、というのはデフォルトの値です。
50bpでは短すぎるな、と思うときは私はこれを上げていいと思います。


サンプル調整自体は、私もトレーニングを受けましたが、それほど難しいステップはありません。
シェアリングもCovarisの機械任せだし、精製もマグネットビーズでピペット処理だし、アダプターダイマー(アダプター同士の接着)をこれまたビーズで取り除くだけ。
基本プロトコールは順調です。
でも、裏プロトコール?みたいなトラブルシュート的なプロトコールでやったときはほとんどDNAをロスってしまいました。
ラボを離れて約7年・・・の私には、裏プロトコールは難しかった。
とは言っても、基本プロトコールで作った10Kbのライブラリーの方は、ライブラリーまでの回収率は33%で、Good!
ランの結果も、上記EA社の数値と同じくらいでした。


ところで、より少ないスタートDNA量でランできないものでしょうか。
たくさんDNAがとれないサンプルでも、長く読んでみたいという要望はあります。
この要望に応えるための方法は、・・・
公式にPacのWebSiteで公開されたらここでも書こうかと思います!
まだ書けないーっ!

2012年8月2日木曜日

Base Modification 塩基修飾 (新


気づいたら8月ですね。 7月はブログ、サボっていました。
「最近更新してませんね」って言われるようになり・・・。

全然関係ないですが、西日本では、クマゼミが鳴いていますね。
沖縄からずっと愛知県くらいまではクマゼミ、見ますね。
でも東京(少なくとも私の住んでる板橋区)では見たことありません。
子供の頃から、図鑑でしか見たことのないクマゼミを、大人になって初めて見たのは京都に出張した時でした。 3年前くらいのこと。
今でも出張先で見つけると、「ああ、捕まえたいなあ。東京に持って帰りたいなあ」って思います。


さてさて、今日はBase Modificationの話です。
塩基修飾とも言います。 
Pacの機械はシーケンサーなのに、DNA修飾を検出することができる!というのが売りのひとつです。 
営業的には正しいのですが、過度な期待は禁物、ということで、ここではもう少し正確に書こうと思います。


今まで、「ショートリードの憂鬱」というブログの中で書いたことがあるんですが、
「メチレーションをダイレクトに検出するシーケンサー」
この中に書かれていることをちょっとだけ修正します。 まあ、こちらのブログを書いたときは、私は別の会社にいましたので、情報があまり無かった、という言い訳も成り立ちますよね。

どこを修正するかというと、後半部分に書いた、何百回も読まなくても同じ場所を5回くらい読めばメチル化と非メチル化のDNAを区別できる、という所。 これは人工配列でできた、というレベルのことで、実際にE.coliなどの配列で区別するには、もっともっと深いカバレージが必要です。

ここからが本題!

PacBioに付属する解析専用ソフト、SMRT Analysisの最近のバージョンに、新しくBase Modification 検出機能がつきました!
って言うと格好いいんですが、正確には、Base Modが起こったかも知れない場所の検出機能がつきました! というのが正しい。

どんな種類の塩基修飾なの? どれくらいの信頼性で? というところは次バージョンに期待してください。

先のブログにも書いていますが、メチル化サンプルと非メチル化サンプルとを両方持っていて、それぞれPacBioで読んだ場合、これら2つのサンプルの塩基のIPDを比較します。
IPDというのは、Inter Pulse Duration の略で、ある塩基が読まれたあと次の塩基が読まれるまでの間の時間と同じ意味です。
メチル化された塩基がテンプレートにあると、Polymeraseがポージング(ちょっと止まる・スピードが落ちる)を起こし、塩基取り込みまでに時間がかかります。

挿絵は Flusberg et al. (2010) Nature Methods 7: 461-465
例えば6mAの場合、テンプレートがmAのとき、Tが結合するまでの時間は、テンプレートがただのAの時と比べて平均5~6倍長い。その比(IPD-Ratio)を見ることで、ここに修飾が起きていそうだな、と予測できるのです。
これも同じ論文から。 6mAの場合です。 IPD-Ratioが縦軸で、横軸は塩基の場所です。
このピークの高さと並び方をシグナチャーと呼んでいます。
必ずしもメチル化されている箇所でPolymeraseがポージングするわけではなく、メチル化箇所の周囲の塩基でもポージングされることがわかっています。
そしてそのパターンが、塩基修飾の種類によって、様々に異なることもわかってきました。

PacBioでは、色々なタイプの塩基修飾、DNAダメージのIPD-Ratioシグナチャーを集めています。
(ブログでは明らかにできませんが、プレゼンでなら紹介できますので興味あるかたはお知らせ下さい)
この情報を使えば、配列を読んだだけで、IPD-Ratioのパターンから、どんなタイプの塩基修飾が起こっているのか、予測できる、というわけです。
と言っても、現バージョン(2012年8月現在)ではそこまではできません。 


では、今は何ができるか!
  1. 読まれた部分の配列の全IPD-Ratioの情報を使って、バックグラウンドから有意なIPD-Ratioを見つける (ここに塩基修飾が起こってたかも?と期待させる)
  2. IPD-Ratioのコントロールは無くても良い。コンピュータで求めたin silico コントロールを使うことが可能 (これは約12塩基の長さで、全塩基組み合わせのIPDをあらかじめシュミレートしたもので、生物種を問わず使うことができる)
  3. 意味ありげなIPD-Ratioの場所をリストしてくれる
  4. そのリストは、Viewerでも表示できるし、前後20塩基の配列とともにGFFファイル、塩基単位のCSVファイルで出力
  5. GFFからはモチーフを見つけたりできる

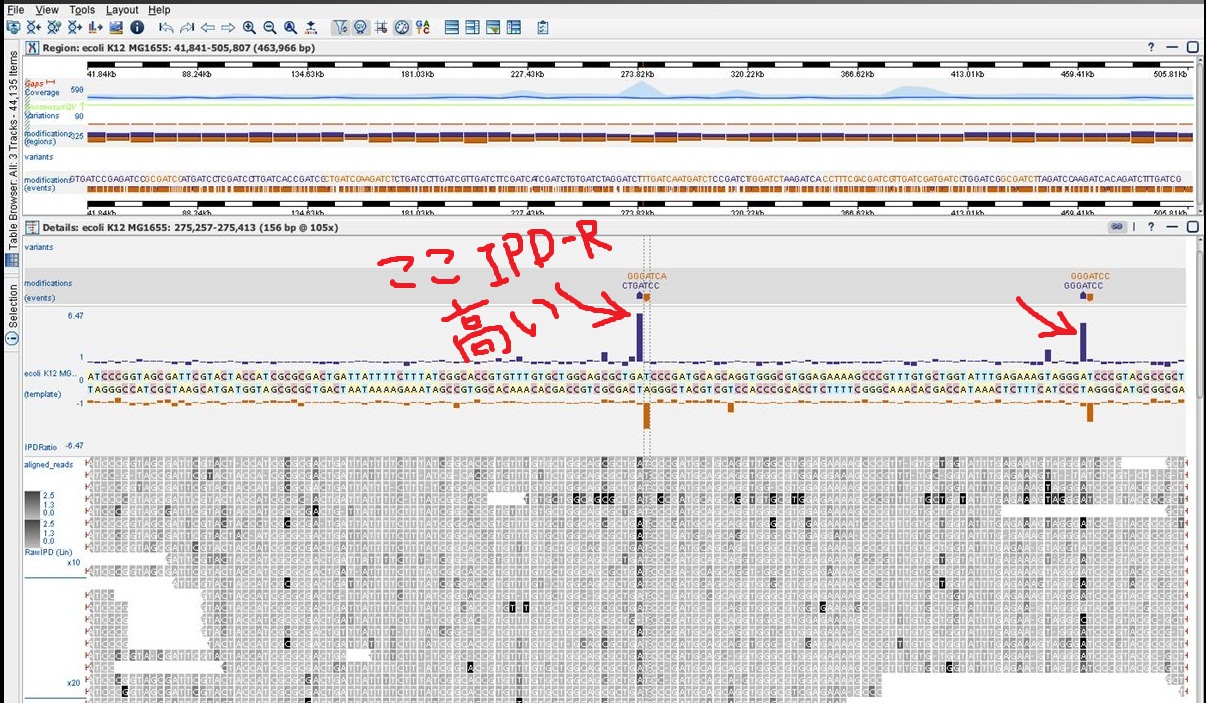
真ん中の青と赤の棒がIPD-Ratioです。 ここに塩基修飾があったかもしれない。
他の場所と比べて抜きん出ていますね。
実際このIPD‐Rが周りと比べて有意かどうかは、IPD‐Rの高さだけでなく、Coverageの深さも問題になります。

そこでCoverageについて
IPD-Rシグナチャーの種類によって大きく異なります。
はっきりしているシグナチャーを持つ塩基修飾タイプ(先の6mAなど、5-6倍のRatioを持つもの)については、15-20xが最低必要で、Pacでは50xを勧めています。

IPD-Rが2くらいの、ゆるーいシグナチャーを持つタイプは、最低200xは必要です。


ではでは、はっきりしたシグナチャーを持つ6mAを読み取ろうとした場合、どれくらいのSMRT Cellが必要なのか?

ターゲットサイズが5Mbだとします。
+/-両方のストランドを読みますから 5Mb x 2 = 10 Mb
50カバレージ必要だとすると、10Mb x 50 = 500Mb
1 SMRT Cellで100MbのMappableなシーケンスが出てくると仮定すると、500Mb / 100Mb = 5 個のSMRT Cell が必要という計算になります。
(大体1kb前後のライブラリーを作成して読むことを想定)

無論、Mappableなシーケンスの数は生物種によって様々なので、最初に1個か2個ランして確かめる必要はあります。
+/ - それぞれのストランドで50x必要、というのが忘れがちですが大事ですね。

5個だとすると、SMRT Cellは1連8個入りですから一回のランで済みます。
45分x2回のムービーでシーケンスするとして、90分 x 5 = 7.5時間
機械にセットしてからのロボットによる試薬調整、ベースコールや転送に+2時間として、ランにかかる時間は、合計10時間弱
オーバーナイトで行う感じでしょうか。


解析には2、3時間くらいかかります。