ラベル 技術 の投稿を表示しています。 すべての投稿を表示

2018年3月20日火曜日

PacBio Sequel v.5.1  ~もうバージョン5.1になってました、、、

装置やソフトウェア、試薬のバージョンアップは、この業界では頻繁にあることです。
今のSequelでは、装置ソフトウェアと解析ソフトウェアが同じバージョンでそろっていて、試薬やケミストリーが別のバージョン番号で管理しているのです。
ちょっとややこしいですが、試薬・ケミストリーが v.2.1で、ソフトウェアが v.5.0 という感じだったんですね。
解析ソフトウェアSMRT Link(SMRT Analysisを含む)のバージョンが、装置ソフトウェアと同じバージョンです。

そこで今回、新たなバージョンアップ!

ソフトウェアが v.5.1になり、ケミストリーが 2.1 version 2 に!
ん? v.2.1 のさらに v.2 って・・・ と思う方もいるでしょうが、そこは気にしないでください。

装置&ソフトウェアの v.5.1と、試薬 v.2.1(v2)を使った場合のスループットがこちら。
ロングライブラリ(35kb)を10時間読んだとき

ショートライブラリ、5kbアンプリコンを20時間で読んだとき

そう、v.5.1から、10時間ムービーと20時間ムービーが選べます。
20時間で読む場合は、LRという別のSMRT Cellを使う必要があります。
(因みにスタンダードのセルよりもLRセルの方が若干高価)

どう使い分けるのか?ですが、今のところ、
  • ゲノムアセンブリのような長いインサートライブラリは10時間
  • PCRアンプリコンやIso-Seqのような短いライブラリは20時間
をお勧めしています。将来的には変わるかもしれませんが、今はこのように、長いライブラリは今まで通りの10時間で読み、短いライブラリは、もちろん10時間でも良いけれど20時間で読むこともお勧め、ということです。
もちろん、20時間で読んだ方がロングライブラリでも長く読めるのでは?という疑問が出てくると思いますが、今のところ、ロングライブラリを20時間で読んでも、10時間で読んだときと平均リード長はほぼ同じ(最長リードは長いが)。というデータが出ています。
LRセルの方が高価だということを考えると、10時間でも費用対効果は良い。

ところが短いライブラリで、主にCCSを作ることを目的としたシークエンスでは、20時間は生きてくるのです。
先のデータによると、

35kbライブラリの場合、10時間で読んだとき
  • データの半分以上は、30kb以上の長さのリード(ポリメラーゼリードとサブリードはほぼ同じ長さとみて良い)
  • 最長リードは90kb超え
  • 1セルあたりの出力塩基数は 10Gb
  • 出力リード数は40万

5kbアンプリコンライブラリの場合、20時間で読んだとき
  • データの半分以上は、70kb以上の長さのリード(アンプリコンサイズが5kbだから何度もインサートを繰り返し読むことのできるポリメラーゼリード、が多く出力される)
  • 最長ポリメラーゼリードは180kb超え
  • 1セルあたりの出力塩基数は20Gb
  • 出力リード数(この場合出力CCS数と言っても良い)は40万

アプリケーションごとのSequel v5.1パフォーマンス(1 SMRT Cell あたりの出力)は以下のようになっています(v5.1 Software Upgrade and Performance Overview - Customer Training より引用)

Whole Genome Sequencing for De Novo Assembly
-Up to 10 Gb:サイズセレクション済の 40kb以上のロングライブラリの場合
-Up to ~7-10 Gb:サイズセレクション済の 15-40 kbロングライブラリの場合

Iso-Seq 完全長 cDNAシークエンス
-Up to 20 Gb
-Up to 250,000-350,000本の full-length non-chimeric (FLNC) reads

Targeted Sequencing (アンプリコンシークエンス)
-Up to 20 Gb
-Up to 300,000 CCS reads:2.5 kb アンプリコンの場合
-Up to 200,000 CCS reads:5 kb アンプリコンの場合
-P1リードのうち 40% 以上は QV 30 のCCSを作成可能:5 kb アンプリコンの場合

Structural Variation Calling (構造変異解析)
-Up to ~7.5 Gb: サイズセレクション済の 15kb ロングライブラリの場合

「Up to」と書かれていますね。これは、そういう意味です。
必ず出る保証はないけれども、うまくいけばこのくらいの塩基は読めるという。

と書いていて自分で言うのも何ですが、数字ばかり並べてもあまり説得力がないと思います。
それぞれ、研究にどれだけ使えるのかを具体的に示せなければ意味が無い。
これについては次に書く予定です。

お知らせ:
3/25-26 日本育種学会総会
3/27-28 日本細菌学会総会
にそれぞれ出展します。どちらも福岡での開催です!

2018年1月12日金曜日

平均リード長20kb越えって、もう珍しくない?

今年もニュースになりました、JP Morgan Healthcare Conference
英語のサイトでいろいろ書かれていますが、まとめサイト的には
1日目はここ
2日目はここ
3日目はここ
がわかりやすいか。

さて、そんな中PacBioの発表は、iSeqのような新製品ではないものの、これまでの常識を遥かに超えるものでした。CEOによると、
新しいケミストリーとソフトウェアが2月を目標にリリースされます。
今のベータテスターの結果によると、次のような結果が既に出ているとのことです。

【ゲノムシークエンス用のラージサイズライブラリの場合】
1セルあたりのスループット:12Gb
平均リード長:25kb
最長リード長:100kb

【ターゲットアンプリコンシークエンスの場合】
1セルあたりのスループット:16.5Gb
平均リード長:33.5kb
最長リード長:135kb

【Iso-Seq(完全長cDNAシークエンス)の場合】
1セルあたりのスループット:22Gb
平均リード長:37kb
最長リード長:200kb

PCR産物の場合はDNAのクオリティがゲノムDNAと比べて高いので、全体的なスループットが高くなる傾向にあります。
それにしてもゲノムDNAのライブラリで平均リード長が25kbとは、もう、昨年作ったカタログをまた作り変えないと。

さらに、2018年末に予定しているスループット8倍のセル、についてもマイク(CEOの愛称です)は触れています。
これはちょっと、私も間違ったうわさを聞いたことがあるので正確にお伝えしておきますね。

スループット8倍のセルとは、ZMWの数が今の100万から、800万になるSMRT Cellのことです。価格ではありません。
800万個のZMWでシークエンスを行い、DNA合成反応から塩基を検出するには、今よりも格段に優れた光学系部品とベースコール計算機が必要になります。
そのため、単純に新しいセルが発売されるのではなく、それに伴い装置内部のアップグレードも必要になります。これは有償になる予定です。金額は現段階では未定です。

PacBioではこの800万ZMWセルについて、アップグレードパスが用意されている、という言い方をしています。
アップグレードへの道がある、という感じでしょうか。
しかし、800万ZMWのセルが出たら、ロングリードの新しい世界が次のステージに行くでしょう。
1セルでヒトゲノムアセンブリ程度のデータが、20kb以上のロングリードで出てくるのですから。
それが後1年で可能になります(I hope)

これに備えて、今から新サービスやソフトウェア開発を始めている企業も、あるかもしれませんね。

2017年9月13日水曜日

ナノポアZMWって何?

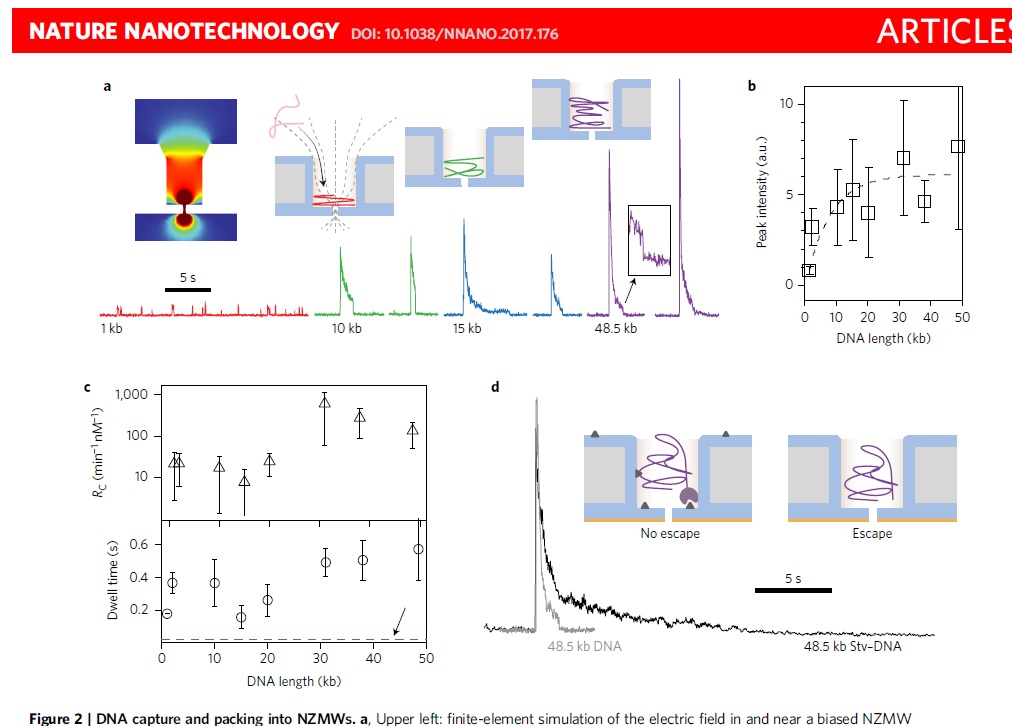
Twitterやその他SNSで知った人もいるかと思いますが、こんな論文がNature Nanotechnologyから出ています↓
"Length-independent DNA packing into nanopore zero-mode waveguides for low-input DNA sequencing"
はて、ナノポア? ZMW? そしてオーサーの一人はPacBioのCSO(最高科学責任者)?
そうです。これはナノポアとPacBioのSMRT Sequencingの両方の技術を組み合わせた新しい技術です。
どんなものかというと、今のPacBioのSMRT CellにはZMWという微小ウェルがありますね。
PacBio・SMRTシークエンスの良いところはたくさんありますが、唯一の欠点はDNA量。
ナノグラム単位のDNA(ライブラリ)をアプライする必要があります。
これをピコグラム単位にすることは、裏プロトコルはあるにはあるのですが、結構難しい。

単純に言うと、ZMWのウェルの中にDNA‐ポリメラーゼの複合体をロードする効率が悪いからです。
長いライブラリ(例えば20kb)は短いライブラリ(例えば1kb)よりもウェルに入りにくい。これをローディングバイアスという。
マグネティックビーズを使って物理的にロードする方法はRSIIの時代に確立されましたが、それでも効率よくライブラリをウェルに入れるのは今でも難しいものです。

ONTのナノポアには、ポアにDNAを通すため、ガイドプロテインをいうものを使います。
この論文にあるナノポアZMW(NZMW)は、ZMWの底にナノポア(穴)を開け、電圧を使ってDNAをZMWにガイドするそうです。

これによるとかなり効率よくDNAライブラリをローディングできるらしい。
10ピコグラムのDNAでも1分以内にローディングできるとのこと。
20kbライブラリの場合、2秒の電圧パルスの結果、DNAをNZMWに吸着できた。
ローディングバイアスも見られず、1kb~48.5kbまでのライブラリをローディングできたとのこと。
Larkin et al., Fig 2

そこまで言うと、じゃあこれが次のPacBioのバージョンアップ技術になるの?
と思うでしょう?
残念ながらこれはまだPOP (proof of principle)の段階で、すぐに商品化されるわけではありません。と、CSOのJonas Korlachも言っています。
でも実現されれば面白い。装置の改良も必要かもしれませんが。
詳しくはNature Nanotechの論文

またはGenomewebのこの記事を参照ください。

有料記事なので詳細は書きませんでした。ご了承下さいまし・・・
個別にディスカッションしましょうね

2017年8月4日金曜日

PacBio 2017年後半戦が見通し明るいそのわけとは?

これを書いている今日は8月4日、昨日のPacBioの株価は前日比で14%も上昇しました。
こういう時は何かニュースがあったのでとりあえず本社のサイトやSNSをチェック!

アメリカ時間で8月2日に第二四半期の発表がありました。
CEO自らが投資家向けにプレゼンする場で、これは録音されて、翌日には誰でも聞くことができます。 一応、視聴するには登録が必要

数字については、私はその辺(アメリカ企業の経営に関する数字)は詳しく無いので評価できません。
でも、悲観的か楽観的かというと、明らかに楽観的な見通しでした。
このプレゼン時間の半分以上が投資家からの質疑応答になるのですが、厳しくは無かったです。

で、良いニュース(これが今回の株価14%UPにつながっているかは不明)はこちらです。

  • 装置の売り上げは顧客のバジェットタイミングによるので不安定だが、試薬売り上げはSequel台数が増えるにしたがって着実に増えている
  • 中国のNovogeneがSequelを10台追加で注文(これで20台購入!)するなど、中国の売り上げが堅調
  • Sequelの新ソフトウェア version 5 のアップデートが始まり、テストデータはとても良い
全世界でRSIIとSequelを合わせると、現在300台以上が導入されています。
この数字は5月のものなので、最新ではもっと行っているはず。
装置が増えればそれに伴い試薬の購入も増えるわけですが、この傾向はシークエンスラボで顕著だそうです。

どういうことかというと、一般のアカデミアは、プロジェクト単位でシークエンスが行われるので、プロジェクトが終わると一息つくことが多いですね。
日本以外でもこれは同じで、プロジェクトごとに予算が付く。そうすると、それが終わったとたんにシークエンスしなくなる。

ところが、営利企業やシークエンスコアラボでは、ひとつのプロジェクトに左右されないので通年シークエンスされるとのこと。
日本でもまあ、そんな感じでしょうか。年度末は忙しい、というバラつきは多少あるでしょうが。

中国のNovogeneという会社、これは世界最大のシークエンスラボのひとつです。
ここ2年くらいで、PacBioの最大の顧客になりました。
Sequelを10台保有し、さらにこの度もう10台の購入を決定! 世界一、Sequelを保有する機関になりました。
彼らがなんでこんなに(20台も)Sequelを買ったのかというと、ロングリードに積極的に投資しているからです。ちなみにここには政府系の投資会社もお金を出しているそうです。
Novogeneでは、中国人ゲノムを1000人分読み、構造変異を解析し、世界初の構造変異データベースを完成させる、という壮大な計画があります。
ここに、Sequelが使われるのです。
さらに、Novogeneはシークエンス受託解析企業なので、世界中から顧客を集め、世界一のシークエンス受託会社になることを目指しています。
そんなこんなで今、PacBioのRevenueの25%は中国から得ているそうです。

中国だけでなく、世界の営利企業は積極的にSequelに投資する傾向にあるそうです。

HistogeneticsというアメリカのHLAタイピング企業は、ショートリード数十台に加えてRSIIが動いています。もちろんSequelも。
これは、HLA遺伝子の完全シークエンス(ショートリードでどうしても型が判定できないような難しいローカスのシークエンス)のためにPacBioのロングリードが絶対必要だ!ということで、アグレッシブにRSII、Sequelが使われているそうです。


これらの発表がもしかすると、昨日の株価14%アップに影響したのかな?

PacBioは、先月Sequel用に、これは解析ソフトと装置のソフトの両方で新しいソフトウェアをリリースしました。
昨日のCEOのプレゼンでは、このソフトが順調に動いていて、ある顧客では平均リード長33kb、またある顧客では1セルあたりの出力が15Gbに達したと言っていました。
まあ、これは極端な例でしょう。
実際は、良くて平均12kb、N50 で20kb、塩基出力も良くて10Gb くらいかな、という感じです。
でも2017年の末には、わかりませんよ。

CEOははっきり言っていました。
2018年末までには、今の8倍のウェルを持ったセルが登場し、新試薬などで今よりスループットが30倍Upすると。

2017年3月6日月曜日

サイズセレクション無しのISO-SEQ Sequel向け


Iso-Seqというのはアイソフォームシークエンス。
数年前から(もちろんそのときはRSIIで)、完全長 cRNAをシークエンスすることで、スプライシングのバリエーションを一気に、連続配列情報として得ることが出来る。
これがIso-Seq です。
最近ではここに書きました
Iso-Seq アイソフォームシークエンスアップデート 植物

RSIIでのIso-Seqは、サイズセレクションといって、1kb、2kb、3kbなど、サイズごとに分けてライブラリを作製、別々のセルでシークエンスしていました。
と・こ・ろ・が・!


このたび正式にリリースされたSequel用のプロトコルでは、サイズセレクションしません。
というのも、Sequel用のケミストリーでは、ローディングバイアス(短いライブラリが優先的にZMWに入る、というバイアス)が、あまり影響しないらしいことが経験的にわかってきたからです。
RSIIとSequel、サイズセレクション無しのとき
Sequelのランはバイオアナライザで測ったときの波形に似ている

サイズセレクションせずに、Iso-Seqの同じライブラリをRSIIとSequelでランしたとき、RSIIは1kb程度のフラグメントがもっとも多く検出されます。
でも、Sequelでランすると2kbあたりに最頻値が現れる。
これはバイオアナライザで測ったときの形に似ているぞ。
ちなみにAMPureは1Xで行なっています。

というわけですが、マグビーズは推奨されています。
また、4kb以上の長い転写産物の出力を増やしたい場合は、4.5kb以上でサイズセレクションをしたほうが良いらしいです

そのたの目新しいこと・・・

  • AMPure精製は、0.40Xと1Xの2通り別々に行い、あとでモル比を合わせて混ぜます
  • PrimeSTAR GXLポリメラーゼを長鎖PCRに使います
  • P1を50%目指します(50%のZMWから使えるデータを出す)
  • 6時間Movieまたは10時間Movieで読みます(時間かかっても精度良いデータをたくさん出したければ10時間)
  • Movieをとる前に2時間シークエンスさせます(Pre-extensionと呼ぶ)
このような変更点があって、プロトコルもだいぶ変わりました。

Sequel では、RSIIで複数個のセルを使っていたIsoSeqが、1個か2個のセルで可能になりました。
今度のAACR(4/1~5)で発表があるかな。
注目してます。


Iso-Seqの新しいプロトコルはこちらから!


2017年2月23日木曜日

バクテリアマルチプレックスシークエンス


Sequel のスループットは、RSII より多いです。
Movie時間やライブラリの種類によって変わりますが、一般的にRSIIでも1セルあたり550Mb~1Gb のデータは出てきます。
一方Sequelは、3Gb~7Gb のデータが出ます。
ポリメラーゼリードの分布はこのような感じ。
1セルで7Gbものデータが出ると、高等真核生物のような大型ゲノムのアセンブリには向いているんですが、バクテリアサイズのゲノムにはそのままではオーバースペックなんですね。

そこで誰もが思いつくのがマルチプレックス。
バーコードをつけて、多検体を一度にシークエンスし、解析のところでバーコードごとに振り分けて検体ごとにHGAPする方法です。

その公式プロトコルができあがりました。解析ワークフローはこちらにあります。

この方法を簡単にまとめると
  • 10kbライブラリをつくる(ゲノムを切るとき10kbをターゲットにする)
  • ゲノムを切った後はExo VII酵素で切れ端一本鎖を処理する
  • バーコード付きのダンベルアダプターをDNAの両端にライゲーションする
  • ライゲーションした後複数サンプルを混ぜる
  • 5Mbゲノムなら12サンプルまで、2Mbゲノムなら16サンプルまで一度に混ぜることができる(Sequelのとき)
  • サイズセレクションにBlue Pippin は使わないで、0.45X AMPure PBを使用する
  • 解析はSMRT Link4.0 以降のソフトウェアで行なう
なぜ20kbでなく10kbライブラリを作るのか?
バーコードはインサートDNAの両側のアダプターについています。
そのアダプター配列を正しく読むためには、10kbくらいがちょうど良い長さなのです。
もちろんもっと短くても、ほとんどのポリメラーゼが端っこのアダプターまで到達するでしょうが、あまり短いとデノボアセンブリに向きませんね。
20kb のインサートだと、端っこのアダプターまで到達するポリメラーゼの数は半分以下か、もっと少なくなります。
それでは得られるデータが少なくなるのでマルチプレックスする意味が無い。
バーコードを認識するにはアダプターまで読みぬかないとダメ

ライブラリの長さとバーコード認識の比率はトレードオフの関係なんです。
ということは、ですね、とても長いリピート配列を含むゲノムには向いていないのです。
30kbのリピートが存在するゲノムをつなげるには、30kb 以上のライブラリが必要。
それだとバーコードまで届かない・・・。ジレンマ

でも、そこまで長いリピートを持たないバクテリア、または染色体を完全につなげなくても良い場合などはマルチプレックスをすることでコストを大きく引き下げることができます。

必要ゲノムDNAの量は?
DNAシェアリング(切断)した後のステップは、Exo VII酵素処理です。
ここで必要な検体あたりのDNA量は、
4マルチプレックスの場合:250ng
8マルチプレックスの場合:125ng
10マルチプレックスの場合:100ng
12マルチプレックスの場合:83ng
全体量で1μgがあれば良いのです

バーコード付きのアダプターは自分で作るの?
売ってます。PacBio Barcoded Adapter Complete Prep Kit.という名前で。
お勧め配列があるのでそれをつかいます

混ぜるときの注意点は?
DNA切ったときの切れ具合が、混ぜるサンプル間で似ていることが重要!
10kb狙って切ったとして、Bioanalyzerで確認して、もしも大きく切れかたが違った場合、DNA濃度をもとにして均等に混ぜるよりも、モル数を同じにして混ぜないと、均等にならない恐れがあります。注意しましょう。


ランニングコストはいくらになる?
12種類のバクテリア(ゲノムサイズ5Mb)を、この方法でバーコード付けてマルチプレックスで読んだときの、1株あたりのコストは、55,000円(2017年2月現在・Sequelの1セル使用時)


2017年2月3日金曜日

PAG報告 パート7 最終回 プレゼン録画のお知らせ

国際学会の醍醐味は、海外でどんなことをやっているかを知ることだと思います。
必ずしも最先端とは限らないけれど、日本であまり聞かない話や、逆に日本の研究が世界でこんなつながりがあるんだ、と気づくことがあります、
私自身、国内でも育種学会や、農学中手の会や、アグリゲノム産業研究会などを通じて植物のゲノムを再勉強しています。
そんなこんなでPAGはとても面白い勉強の場でもありました。

さて、今回はPAG報告の最終回。
PacBio関係のセミナープレゼン録画やスライド、ポスターなどの情報がネットにアップされましたのでお知らせします。

ぜひこれを見て、PacBioのSMRT Sequencing がいかにゲノムアセンブリやトランスクリプトーム研究に貢献しているか、を実感して下さい。


尚、上記セミナースピーカーのうち、ErichさんはBird 10K プロジェクトのリーダーで、PacBioのカスタマーイベント(という名の飲み会)で近くのテーブルにいたからしばらく話したひと。
Benさんは、知り合いと待ち合わせていたホテルのバーで偶然隣に座っていて友達になったひと。

こういう出会いも海外学会の醍醐味ですかねえ。

上記のビデオ、プレゼンファイルのダウンロードはこちらから。


2017年1月27日金曜日

PAG報告 パート6 DovetailやNRGeneなど(その2)

前回、NRGeneの話ができなかったので、本日はそれ。
この会社は、イスラエルにあります。
ラボは無く、解析だけを行うドライのスペシャリストの会社です。

彼らのサービスはゲノムアセンブリ。その名も、DeNovoMAGIC
お客さんはアメリカにあるNRGene提携先サービスプロバイダーに、サンプル(組織とか)を送ります。
アメリカでシークエンスをして、データが出たらイスラエルのNRGene社がこれを解析します。

前回紹介したDovetail 社はシカゴライブラリとかHi-Cとか、すごく長い距離をカバーするライブラリ(シカゴの場合は100kb, 200kb それ以上、Hi-Cの場合はMb単位)を作るのに対し、NRGene は他社のライブラリー技術をうまく組み合わせます。
例えば、数種類のペアエンド、数種類(3,000~9,000bp)のメイトペア、そして10X Genomicsの Linked-read,これらをそれぞれゲノムサイズの数十カバレッジかそれ以上読みます。
そしてNRGene独自の解析技術でアセンブルを行ないます。

これは私の主観ですが、DovetailのChicagoやHi-Cは、スキャフォルドをできるだけ長く作るのに優れていて、NRGeneは長さよりもハプロタイプごとのフェージングにより力を入れている気がしました。
あくまで私がPAGでそれぞれの結果の発表を聞いた限りの印象です。

どちらの会社も、「自分たちのほうが精度が高い。アセンブリ結果は良い」と言うので、メーカーの話を鵜呑みにはせずに、ユーザの声を聞いたほうが良いですよね。

但し、Dovetailの技術が論文でも公開されているのに対し、NRGeneのアセンブリ技術はブラックボックスです。
ここを気にするお客さんはいるかもしれません。

PAGではどちらの会社のひとたちとも会って話したり食事もしましたが、どちらも感じ良い雰囲気でした。皆さん楽しんで仕事しているんでしょうね。
社員さんはカリフォルニア(Dovetail)とイスラエル(NRGene)の国民性がはっきり出ていましたよ。

そんなNRGeneですが、日本では代理店がまもなく決まります。
ですのでその会社のビジネスの邪魔にならないよう、これ以上はブログでは控えます。


でも私は断然、Dovetail 押し!
価格もDovetail の方が安いですよ。
Dovetailの方が、アセンブリの経験も多いし、これまで行なった生物種の数も多いし、実験から解析の方法が論文で公開されているし。そういったところが評価されると思います。
PacBioとも相性いいですからね。

2016年11月10日木曜日

10X Genomics のデータだけに頼ってはいけない理由

 10X Genomics (10XG)という会社をご存知ですか?
Synthetic Long Read、またの名をLinked Read と呼ばれるデータを出力し、Scaffoldを作ります。
Synthetic Long Readというのは訳すと、合成ロングリード?擬似的ロングリード?でしょうか。
でも、これは本当の意味でロングリードじゃない! という意見があったのか、最近は Linked Read、リンクしたリード?、という呼び方がされるようです。
http://www.10xgenomics.com/products/より

バンクーバーのASHGでも、ランチョンやその他のワークショップでも存在感を出していた10XGですが、この会社の対象マーケットは、大きく、1)デノボアセンブリ、2)シングルセル発現解析、の2つがメインだと言えます。
シングルセル発現解析のほうは既存の技術に比べて何十倍ものハイスループット解析ができる、といった優位性があると思います。
ですが、もうひとつのデノボアセンブリは、どうかなあ・・・
10XGに頼って解析を進めていると、大きな情報を見落としていることに気づかないことがあるでしょう。今日はそういう話。

ここから先は、PacBioのJasonさん(Falconなどの開発者)が解析してくれた結果。
彼はバイアスをかけない解析をしますので、私は、とても客観的なデータだと思います。


まず、NA19240サンプルを、PacBioでアセンブルした結果と、10XG v.1.3 でアセンブルした結果があります。
Contiguityを比較するのは大人気ない、というかそもそもContigとScaffoldを比較するのはあまり意味が無い。
そこで、アセンブルした後の結果の、構造変異を検出した場所(Segmental Duplication以外の場所で)を見てみます。


  • 10xGアセンブリ、PacBioアセンブリ共に、数千~1万強の、挿入、欠損部位を検出した
  • 10xGアセンブリの方が多くの欠損変異を検出し、5,573個は、PacBioアセンブリでは検出していなかった
  • 反対に、2,693個の欠損変異は、PacBioアセンブリでは検出され、10xGアセンブリでは検出されなかった


【欠損:10XGで検出されたがPacBioで検出されなかった5,573のうちの1例】
これは、10XGのアセンブリでは176bpの欠損を示していた箇所。
リファレンスには確かに176bpあり、PacBioのアセンブリでも、アセンブリ前の補正後リード(p-reads)でも、確かに176bpがあった例。
この箇所は、GCの連続配列で、10xGが使用しているショートリードでは読めない。
なので間違ってコールされてしまった例。

ほかランダムに抽出した9例

最初の1例を合わせた10例のうち、8例は擬陽性だった。

【欠損:PacBioアセンブリでは検出されたが、10xGでは検出されなかった2,693例のうちの1例】
この配列も、GCが多い場所で、10xGでは読めていない。しかし、この場所には、リファレンスには無い58塩基の欠損領域が、PacBioアセンブリから検出できている。
しかもそれは、ヘテロ欠損。
研究者なら、このようなヘテロな場所の変異に、より興味が湧くのでは深いのでは?

ほかにランダムに抽出した9例
先の1例を除き、全てで10xGのアセンブリでは、読めていない箇所に、実際は欠損変異が存在した。

ということで結論、
読めない配列が原因でコールされた変異は擬陽性の可能性が高い
読めない場所から変異をコールするのは不可能
10xGのデータだけに頼って解析していては、重要な変異を取りこぼすことになる

今回は欠損変異だけに注目しました。(スライドはJasonさん作)

どんな技術もそうですが、それだけに頼って解析していては、見落とすものは必ずあります。 なのでバリデーションは大事。
特に、比較的新しい技術に関しては、一見素晴らしいように見えても、欠点もちゃんと意識して使わないと、レビューワーから突っ込みを受けることになりますね。

10xGユーザの方は、上記のような擬陽性の可能性もあることを考えて、一度、PacBioで読んでバリデートしましょう!!

2016年8月22日月曜日

ヒトゲノムとPacBioロングリード 国内シンポジウムのお知らせ

前回のブログにも、Precision Medicineとヒトゲノムシークエンスについて書きましたが、アメリカ人類遺伝学会に行かないかたでも、東京&沖縄で、来月シンポジウムがあります。
今日はそのお知らせです。

主催はPacBio RSII のスーパーヘビーユーザーさんでもある、一般社団法人 沖縄綜合科学研究所。
9月7日(水)は那覇市、パシフィックホテル沖縄にて
9月9日(金)は東京浜松町の世界貿易センタービルにて

どちらもこちらのウェブサイトから詳細が確認でき、参加登録もできます。

日本語の発表と英語の発表が半々くらいで予定され、どれもPacBioを使った最先端の研究の発表になると思います。
台湾からのDr. Meiyeh Luは、アジアユーザーミーティングでも発表されました。エネルギッシュな女性でとにかく話すのが好きな感じでした。そのときは感染症バクテリアなどのゲノムシークエンスがテーマでしたが、今度はどうでしょう。

PacBioからはDr. Meredith H. Ashby 彼女もまた、話すのが好きな女性です。ま、女性はたいてい皆そうですかね。
Meredithとは何度かPacBioの本社で会って話したことがありますが、大学時代に日本語を取っていたそうです。でも日本に来るのは今回が初めてだそうで、楽しみにしていました。
なので今回の発表も期待できますよ。

アメリカからのゲストスピーカーは、Dr. Robert P. Sebra 彼は何度か日本にも来ていますし、私たちが主催した「PacBio現場の会1&2」でも発表してくれましたので、覚えているかたもいるのでは?
恐らく世界で一番、PacBioの装置を動かしているし経験もあるグループでしょう。
所長さんは元PacBioのCSO(最高科学責任者)で、Robertさんもまた元PacBio社員、他のラボのPIにも元PacBioがいるそうですから。
こちらの発表も期待できます。


どちらも午後1時半から夕方5時くらいまでの半日セミナーで、参加も無料だそうです。
PacBioに関する情報収集にはとても良い場だと思います。
シンポジウムやセミナーを企画して、会場手配して、演者のスケジュールを確保して、段取り決めて、って、いろいろ結構大変なんですよね。
だからこういう機会は、とっても貴重ですよ。

できるだけ事前参加登録をお願いしているようです。

と、ここまで言っておきながら、残念ながら、私は別の予定があって、参加できないんですよ。
行きたかったですが・・・。

2016年8月18日木曜日

Precision Medicine (プレシジョンメディシン) とロングリード

皆さん、Precision Medicineという言葉、聞いたことあると思います。
これが何を指すのかというと、「現在のゲノム解析技術と知をフルに活用して、個人に合ったオーダーメイド医療、予防医学も含めて、実現しよう!」というものではないでしょうか?
私の理解はそんなところです。皆さんそれぞれ少しずつ違った解釈をされているかもしれませんね。

しかーし、ここで英語の問題を1問。
「PrecisionとAccuracyの意味の違いを述べよ(PreciseとAccurateの違いでも良い)」

さあ、わかりますか?
普通に辞書引くと、どちらも正確性あるいは精度とか書いてあるかもしれません。でも、厳密には違いますよ。

答え:
Precisionとは精度。何回も測定してどれも近い数値が出た場合、精度が高いといい、再現性が高い、とも言う。
Accuracyとは正確度。測定結果が真の値に近い場合、正確度が高いといい、確度が高いとも言う。
なので、いくらPrecisionが良くても(同じゲノムを何回解析してほぼ同じSNVが測定されても)Accurateで無い場合(真の変異では無い)もある
(ググれば例が出てきますが、私がわかりやすいと思ったのはここ)


イルミナ社の超並列高速シークエンサーによって出される膨大なデータは、ゲノム解析を革命的に進歩させ、ある種、Precision Medicineをリードさせたと思います。
でも、Preciseではあるかもしれないけれど、真の変異をコールできていないかもしれない、というところがネックでした。

スタンフォード大のDr. Deweyらが、JAMAに2014年に発表した論文、「Clinical Interpretation and Implications of Whole-Genome Sequencin, JAMA. 2014;311(10):1035-1045」によると、56の重要疾患遺伝子について、ショートリードで30X読んでも、10本未満のリードしかマップされなかった(読まれなかった)遺伝子は結構多かったらしいです(下図)。
JAMA. 2014;311(10):1035-1045

また、想像つくかもしれませんが、ショートリードだけに頼るゲノムリシークエンスでは、

  1. リードより長いリピート配列は検出できない(3塩基繰り返しリピートなどは検出不可)
  2. 多型性が高い配列(HLAなど)で数キロに及ぶハプロタイプを求めるのは困難
  3. 大きな(1000bp以上の)構造変異を検出するのは困難

です。

そこで、ロングリードで、低カバレッジで、正確に変異を検出することが大事になってくるわけですね。

先の論文の著者でもある、Dr. Euan Ashleyは、先日Nature Reviews Geneticsにレビューを発表しました。
リンク先はこちらです
パーソナルゲノム、クリニカルゲノムシークエンス、などの分野に携わるひと、これからやろうと思っているひとは、このレビューを読むことをお勧めします!

ちなみにAshley博士は、Personalis社の創始者でもあるのです。Precision Medicine のまさにオピニオンリーダーですね。

またこのレビューの内容の一部は、YouTubeでも公開されているので興味のあるかたはこちらもどうぞ

最後に、Ashley博士は、今年のASHGでも、PacBioのワークショップで講演します!
行くひとは是非チェック!!


2016年8月16日火曜日

ハイブリッドアセンブリ 悩みどころとそのヒント

リオオリンピック、日本選手の活躍が目立っていますね。
ところで皆さんはどの競技が好きですか? 水泳?マラソン?陸上?

私はやっぱり陸上ですね。
ボルトの100mもすごかったですが、見入ってしまうのは普段あまり目にしない、ハンマー投げとか、円盤投げとか、3000m障害とかですよ。
投げ系は単純に飛距離を競うところがわかりやすいし、投げた後の雄たけびで、こっちも力が入る。
障害はもはや、何でもありでしょう。飛んだり跳ねたり、水辺に入ったり、誰がこんなルール作ったのか。
最初はみんな一緒にスタートするのに、途中で離されたり、転んだり、抜き返したり、ドラマがありますね。

さて、ドラマがあるといえば「ハイブリッドアセンブリ」
使うツールとデータ量のサジ加減で結果がずいぶん違ってくる=ドラマがある


ハイブリッドアセンブリとは、異なる技術のシークエンサーデータを組み合わせてアセンブルすることです。
7年前くらいは、ハイブリッドといえば、数十bpのイルミナリードと、数百bpの454リードを合わせてアセンブルする、ということを良く聞きました、が、
PacBioの登場で、ハイブリッドアセンブリは大きく2つの意味に分かれました
  1. PacBioロングリードを、イルミナショートリードでエラー補正してからアセンブリする(2012年ごろ登場したPacBioToCA, ECToolsでは主にこの意味)
  2. イルミナショートリードで作ったContigを、PacBioロングリードでScaffoldする(2013年ごろのPBJellyの登場からはこの意味も加わる)
厳密には、2はアセンブリというよりScaffoldingですが、これもハイブリッドアセンブリと呼ばれることが多いです。
ちなみに研究者のひとと話をするとき、どちらの意味でハイブリッドと呼んでいるのか、最初に確認するようにします。でないと、話がすれ違いになってしまう!

では、最近多い、2の意味でハイブリッドアセンブルするとして、どのデータをどれくらい用意して、どのツールでアセンブルしたら良いのでしょうね?

で、ちょうど良い論文があります!


この論文は、PacBioリードのアセンブリ戦略をこれから検討するかたに、いくつかヒントを与えてくれます。
彼らはショウジョウバエのゲノムをサンプルにして、PacBioとイルミナのシークエンスをおのおのどの程度(ゲノムカバレッジ)読んで、どのツールで解析すれば良い結果(ContiguityやCompleteness)を得られるか調べています。

ハイブリッドアセンブリの方は、いろいろ試した結果、DBG2OLCを採用。
Platanusを使って67.4xのイルミナデータ(DPGPプロジェクトデータを拝借)をアセンブリし、そのContigとPacBioロングリード(様々なカバレッジ量)をハイブリッドアセンブリするパイプライン。

比較としてPacBioのみのアセンブリは、PBcRを採用(注:いまはCanuというツールになっています)

ま、詳しくは論文を参照して頂くとして、ネタばれします。(先入観持たずに論文読みたいひとはここから先は読まないで)

---------------------------------------------------------------------------

M&Mの最初に、ショウジョウバエのゲノムを抽出して、サイズセレクションして・・・って書いてあるけど、シークエンスしたデータはこのアセンブル解析には使っていない、ってはっきり書いてある! え?
全ての解析データはpublicly availableのものだって!?
ま、それはみんなが試せるから良いとして、ここはスルー

NG50のグラフ(論文中Fig 5)を見ると、PacBioリード40x、53xまでは、ハイブリッドアセンブリの結果の方がNG50が長い(下のほうの3本はハイブリッド、真ん中の青はPacオンリー、一番上の赤線は両方のマージ)
でもその上、62x、77x、99x、121xのPacBioリードでアセンブリすると、NG50は一気に長くなる!

Chakraborty et al. Fig 5

だからPacデータを使うなら、Pacオンリーデータでアセンブリしたほうが良い!

と、言ってもやっぱりハイブリッドは、需要があるわけです。
理由はコストとサンプル量の制限です。

ほぼ無制限に予算があって、ほぼ無制限にDNAが取れれば、Pacだけでアセンブリしたほうが良いに決まってますが、普通そうはいかない。
この論文でも言っていますが、PacBioを30x程度と、イルミナを70x程度用意できれば、そこそこリーズナブルな結果は得られるでしょう。
この論文の例では、Pacデータ30xと、イルミナデータ70xのハイブリッドの結果のNG50は、Pacオンリーの50xアセンブリのときより長かった、そうです。
もちろんゲノムの複雑さによっては、Pacデータは30xでは足りない、なんてこともあるでしょうが、最初のステップとして、30xはお勧めできます(10xは少ないだろうなあ)。

最後に、必要DNAですが、これは結構盲点かもしれませんね。
マイクログラムオーダーのゲノムDNAを用意して、ようやく数個のSMRT Cellを流せるのですから。必要カバレッジのデータ量を得るために、どれくらいのゲノムDNAを抽出する必要があるのか、これを逆算したら結構な量になるかもしれません。
抽出できるDNA量から、カバレッジの限界を計算して、ハイブリッドを選択するケースもあると思います。

2016年6月21日火曜日

Dovetail - de novo Assembly 専門のテクノロジー(2)


カリフォルニア州サンタクルーズ市は、「サーフィン発祥の地」とも言われているそうです。僕はサーフィンしませんけど。
海岸線を通るHW1号線を北上すると、ザ・カリフォルニア、って感じの素晴らしい景色が見えてきます。

天気がいいとドライブに最高!
そのまま北上するとサンフランシスコに行くことができますよ。

ああ、そうそうDovetail社です。
看板は控えめな感じ
いかにもベンチャー
サンタクルーズの市内、大きな倉庫みたいな建物にこの会社はあります。
ベンチャーらしい雰囲気の、活気のある会社です。
彼らの提供するサービスは、ずばり、「デノボアセンブリのトータル受託」
ゲノム抽出からアセンブリまで

顧客はDNAではなく、組織を送ります。
100 kb以上の、高分子DNAを抽出する技術が必要だからです。
輸送中にDNAが壊れて短くなってしまうことを防ぐのも理由らしいです。

DNAを抽出後は、2つのワークフローに分かれます。
  1. HiSeqを使ったショットガンシークエンス→アセンブリ
  2. Chicagoライブラリ作成→シークエンス(HiSeq)

1のアセンブリ結果のContigを、2のシークエンスでScaffoldして、最終的にまとまったScaffold 配列を顧客に返却
という流れ。
Dovetail社のウェブサイトから

彼らのChicagoライブラリ原理をまとめました。
(詳しくは彼らのウェブサイトまたは論文
Putnam et al.,
Chromosome-scale shotgun assembly using an in vitro method for long-range linkage
Genome Res. 2016. 26: 342-350を参照)

Dovetail 社のウェブサイトから
  • まず最初に100 kb ~ 150 kb 以上の長いDNAフラグメントを抽出する(A)
  • ヒストンを追加し反応を与え、Naked DNAをクロマチン構造に再構成させる(普通クロマチン構造をとらないバクテリアゲノムでも、強制的にこの形にすることができる)(B)
  • 再構成させたクロマチンを、ヒストン同士、共有結合によってクロスリンクさせる。これにより、ゲノムDNAが凝集され、距離が縮まる。例えば、上図の1と2は、最初は50kb以上離れた位置に配列だったが、クロスリンクによって近くの位置に来ている(C)
  • クロスリンクされたクロマチンのDNAは、制限酵素によって切られ、sticky-endedのフラグメントができる。DNAはバラバラになったように見えるが、ヒストンのクロスリンクにより、もともとのフラグメント由来のDNAは、この時点でも凝集されていてる(D)
  • 新しく作られたsticky-endedの末端は酵素反応でblunt-endにされ、その際、ビオチンがついたヌクレオチドでしるしがつけられる(E)
  • DNA Ligase反応で、blunt-ended 末端同士が結合される。たいていの場合、これまでつながっていたフラグメントではなく、遠く離れたフラグメント同士が結合する(ここは確立論)ので、例えば、上記、1と2が結合することもあり得る(F)
  • 次に、クロマチン構造は解除され、DNAが抽出される。そしてフラグメントの真ん中に無いビオチンは取り除かれる。つまり、Fのステップでライゲーションされなかったフラグメントのビオチンは除去される(G)
  • 最後に、ストレプトアビジンビーズで、ビオチンが付加しているDNAだけ、精製される
このようにして、もとは数十~数百kbpも離れていたDNA同士が、くっついた形で抽出できるのが、Chicagoライブラリ。

で、あとはこれを連続で読むかペアエンドで読むかして、先のショットガンゲノムアセンブリで作ったContigをScaffoldするという流れです。

Scaffoldに使用するソフトウェアはHiRiseという、彼らが開発した独自のもので、今は公開はしていません。

Dovetail社は、デノボアセンブリの受託に特化していて、機械やキットを売るというビジネスはしていません。
非常にシンプル! 

気になるのは金額ですよね。そこそこはします
まだ、インターナショナル価格は設定されていません。
この間のPAG Asia @シンガポールで、Dovetail社のブースが出ていました。
現CEOのToddさんは、元イルミナ社員で、かつ元BioNano社員で、PacBioのひととも仲が良い。
せっかくなので、みんなで夕食に行き、そのまま夜12時過ぎまで飲みました(私もToddさんとは知り合いだったのです。世界は狭い!)

これから、アメリカ国外に進出をしていく予定らしいので、注意してフォローしていきたいと思います。
PacBioとも親和性があると思うんですよね。


2016年6月20日月曜日

Dovetail - de novo Assembly 専門のテクノロジー(1)

大型ゲノムのデノボアセンブリといえば、これまで良く使われてきた方法として、
ショートリードでがっつりショットガンシークエンス &
PacBioで10x程度読んでScaffold

というのがありました。
この方法は、PacBioだけでアセンブリすることが(予算的に)できないときや、既にHiSeqで200xくらい読んでいてContigもたくさんある、というときなどに使われてきたと思います。
これからも、この方法は多く使われるでしょう。

では、PacBioで50x程度読んでアセンブリしたけれど、もう少しContigやScaffoldとして配列を長く伸ばしたい、という場合はどうしたら良いでしょう?
3つ方法があります。
1つめは、連鎖解析。これは古くから、植物などのゲノムアセンブリのバリデーションに使われてきたと思います。
2つめは、BioNanoのIyrsなど、Physical Mapping情報を使って、PacBio ContigをScaffoldingしていく方法。PacBioで読んだヒトゲノムの論文にも紹介されています。
3つめは、別のシークエンス技術を併用する方法。ショートリードでScaffoldする方法です。

今日は3つめの、ショートリードでScaffoldする話です。
今さら?と思われるかもしれませんが、Chicago Library、ってご存知ですか?

Dovetail Genomicsという会社と、UC Santa Cruzが開発した、通常のMate Pairよりも離れた場所の配列情報を読むためのライブラリ作製技術です。
もともと、ゲノムの3D 構造を見るための、Hi-Cという技術があります(Hi-Cの詳細に興味のあるかたは2009年の論文を参照)。
Hi-C: Lieberman-Aiden et al., (2009)

このHi-Cを使って、PacBioで読んだヤギのゲノムのContigを、染色体の長さレベルに伸ばそう(オリエンテーションも考慮して)としたプロジェクトは、PAG2015で発表がされました。

Hi-Cと非常に似ているのですが、Chicagoライブラリーは、in vitro で行なうところが大きく違います。
Chicagoは、Cell-free Hi-C for Assembly and Genome Organization の略らしいです(ここ)。

では、どんなふうに作っているのか。
Dovetail社はそれを使ってどんなビジネスを展開しているのか?
は次回のお楽しみ!


2016年6月6日月曜日

「10X Genomics と PacBio」 どちらかを選ぶとしたら?

10X Genomicsという会社を知ってますか?
10カバレッジ、ではありませんよ。ややこしい。

カリフォルニアにあるこの会社のテクノロジーは、簡単に言うと、「ショートリードシークエンサーを使って超長い配列をざっくり読んでしまう」もの。
日本語での説明は、ここ「GOクラブ」とかここ「技術夢想」にあります。
最近の発表は、YouTubeにも上がってますのでこちらもどうぞ。
10Xの最新マシンは、Chromium Systemという機械。
前機種よりも性能アップで、ゲノムアセンブリやExomeシークエンス、SNP フェージング、さらにSingle CellからのRNA-Seq発現解析ができる機械だそうです。

先月、Nature Methodに、ヒトゲノムの「デノボアセンブリ」とフェージングに、10Xのテクノロジーが使われた論文がでました。
Mostovoy et al. (2016) Nature Methods. doi:10.1038/nmeth.3865
この論文では、Hybridとあるように、Illumina、10X、BioNanoの3つの技術を使用しています。
それぞれのデータを組み合わせて、Scaffoldを作っています。
サンプルはHapMapのNA12878です。
10XはScaffoldの装置(Mostovoy.et al)

ContigとScaffoldの違いは、Contigは連続配列、Scaffoldは飛び飛び(NNNがある)配列
PacBioのスライドより(ContigとScaffoldの違い)

論文によると、もともとIlluminaペアエンド&メイトペアのデータだけでアセンブリした場合のContig N50が11.1 kb(Scaffold N50は590 kb)。
ヒトゲノム97カバレッジのGemCode(10Xの装置)データだけでアセンブルすると、Scaffold N50 は7.03 Mb、最大Scaffold は37.9 Mb
さらに、Physical MappingのBioNanoデータを追加して、これらのデータをハイブリッドして、Scaffold N50が33.5 Mb
Hybrid Assemblyの解析パイプライン(Mostovoy.et al)

ショートリードだけでは短かったContig、Scaffoldから、「Scaffoldを飛躍的に長くした」のがこの論文のメインです。
Discussionのセクションには、10Xの技術のリミテーションも書かれています。

  1. 10Xの 「Linked-Read」 を出力するためには、高分子のDNAが必要
  2. Linked-Readは、ビーズ上のDNAをランダムk-mer増幅することにより作成される。そのため増幅されにくい配列(GCなど)は、その後シークエンスされない(つまりリピート配列などはNNNNNとして残る)
  3. NNNN配列の長さを短くするには、いくつかの異なるライブラリサイズのシークエンスが必要

GCリッチな場所が読めないというのは、目的にもよりますが、・・・ どうでしょうね。
やはりゲノムアセンブリには連続配列が重要ではないでしょうか? Scaffoldではなく、Contigが

ちなみにGenome In The Bottoleプロジェクトで、PacBioとBioNanoで同じサンプル(NA12878)を読んだときは、Contig N50 が1.4 Mb !
Scaffold も31.1 Mb


10Xの装置は、個人的には、ゲノムシークエンスよりSingle Cell発現解析のほうがメインな機能になる気がします。
また、現在、10Xはヒトゲノムオンリーの装置とのこと。
技術的にはヒト以外でも応用できると思いますが、ソフトウェア特に変異解析アルゴリズムがヒトゲノムに最適化している点や、あとはビジネス上の事情だと思います。


2015年10月5日月曜日

40kbライブラリ&6時間シークエンス最強説

「40kbライブラリと6時間シークエンス」で、驚きのアセンブル結果!
本当は10月最初の話題はこれにするつもりだったのですが、新型機械の発表があったもんだから、インパクトに欠けてしまいました。

でも、8月に実際シークエンスをしてみて、アセンブルしてびっくりしたのでせっかくだからシェアします。
(公開にあたりサンプル提供者の許可は得ています)

このサンプル、腸管出血性大腸菌O111は、ゲノムの中に20kb~30kbのリピートが多く、ショートリードではアセンブルがとても難しい。
PacBioでも、一昔前の酵素では、同じように複雑なゲノムであるO157:H7ゲノムは200カバレッジで読んでもContig数は9本でした。
(Koren S., et. al. (2013) Reducing assembly complexity of microbial genomes with single molecule sequencing. Genome Biology, 14:R101 Table 3)


そんなところに、この度、最長Movie時間が4時間から6時間にバージョンアップ!
6時間シークエンスということは、超長いライブラリを作成すれば、長いサブリードが得られ、結果アセンブル結果も改善できるはず。

ということで、

  • 40kbライブラリを作製
  • サイズセレクションをよりシビアに
  • 4時間または6時間でシークエンス

を試しました。

40kbライブラリを作製するには、それなりに長くゲノムを切ることが必要。
今までのG-tubeではなく、Megaruptorという機器を使って切りました。
Megaruptorについてはこちら

この機械で何回かテストカットして、Pippin Pulseに流して確認。
本番カットでゲノムを40kb Shearingしたら、PacBio SMRT bellライブラリ作製へ。

ライブラリができたらおなじみBlue Pippinを使ったサイズセレクション
普通は7kbカットオフとか10kbカットオフとかを行なっていますが、ここでは17kbカットオフをした。
17kb未満のサイズのライブラリを捨てて、それ以上の長いライブラリだけを回収するというわけ。

さて、そのようにしてできたライブラリを、4時間と6時間でシークエンスしたら・・・

リード数は4時間より6時間の方が多いですが、これは偶然でしょう。
平均リード長は、4時間が9kb、6時間が10kb
平均サブリード長は、4時間が8kb、6時間が8.7kb
すごく長いというわけではないけれど、20kb、30kb超えのサブリードも結構ありましたので、これでHGAP3アセンブルを試みた。

Contig数はどちらも4本
最長Contigはどちらも5.32Mb
6時間Contigの配列でDot Plotを作ってみると、確かに、20kbから30kbの長さのリピートが多く含まれていた。
おおーっ!すごい!

6時間で作ったContigに、再度サブリードをマップして作られた、カバレッジグラフを見てみると、染色体5.32MbのContigは、60カバレッジ~140カバレッジであることがわかりました。
カバレッジが高い場所は、ORIであるかも知れない。
ほかのContigは、プラズミドかな? これはその道の専門家に調査をお願いしています。


さて、結果としては、4時間でも6時間でも、このゲノムの染色体はつながりました。
ちゃんと精査する余地はまだ残っているとしても。


せっかくなのでもっとすごいリード、サブリードの例もお見せします。
これは別の大腸菌です。

リード数も6万本、7万本と、さっきの株より多いけど、リード長はもっとすごい。

平均リード長は、4時間が15.6kb、6時間が18.2kb
平均サブリード長も、4時間が13.2kb、6時間が14.4kb

もちろんこのデータでも、染色体ゲノムのアセンブル成功
20kbのリピートも何のその! です。


もちろん、このようにサイズセレクションをシビアにすると、捨てられるDNA量も多いですから、最初に用意すべきDNA量は大変多い(10マイクロ~30マイクログラム)です。
これがネックでしょうね。少量DNAからもこのような長いライブラリを作れたら良いのですが。


2015年7月8日水曜日

NGS現場の会で思ったことと、ヒトゲノムのアップデート

梅雨ですねえ。毎日雨が降っています。
そんな中、先週つくばで「NGS現場の会・第4回大会」が行なわれました。
私たちは、初日にスポンサーセッション、2日め3日めは展示会場とポスターで、楽しみながら仕事してました。

いつもプレゼンを作るとき、観客が100人、200人の場合、どのレベルに合わせて話すかで迷います。
集客をたくさん取るにはできるだけインパクトのあるタイトルと、わかりやすい内容の要旨、が必須。
現場の会で集まる皆さんは、NGSのプロから初心者、研究対象もバラエティに富んでいる。
そこで難しいのは、まず話す内容のレベルです。

PacBioを知らないひとにHGAPとかSubreadとかいきなり言っても通じるわけが無く、眠ってしまうのがオチ。
反対に、あまり初歩的な内容を話すと、今度はNGSのプロでPacBioに精通しているひとが退屈してしまう。
だからといって平均的なレベルの内容では、面白みが無い。

そう、だから、企業がやるプレゼンは大抵つまらないのです!!
みなさん、企業プレゼンで退屈した経験は多いでしょう?
そうならないために、各社、その道の有名研究者を講師に招いて、喋ってもらったりする。

企業としても研究者に喋ってもらった方が楽だし、リップサービスで自社の製品を褒めてもらえれば説得力が出る。
私も、日本進化学会とかゲノム微生物学会とかのランチョンセミナーでは、大学の研究者にお話ししてもらいましたが、「現場の会」「・・・若手の会」では私自身で喋るようにしています。

自分にとっても良い経験になります。
普段は特定のお客さん相手、または同じような研究をしている方相手の「真面目な」プレゼンが多いですが、現場の会、若手の会は、「ここまでなら許されるかな?」的に冒険できる。

ストーリーを作って、観客を飽きさせない。たまに外すこともありますが。

そんなプレゼンの中で、今回は

  • はじめに(これまでの3年を振り返り)
  • PacBioシークエンスとは(初心者向けに簡単におさらい)
  • ヒトゲノムへ与えた衝撃(最近のヒトゲノムシークエンス)
  • ターゲットキャプチャーシークエンス(NimbleGenプローブを使ったキャプチャーシークエンス)
  • 2015年からこの先の計画(さらなるロングリードを実現するためのアップデート)

の流れで話しました。

特に、発表の前日、PacBioを使ったヒトゲノムデノボアセンブリの論文がPublishされました。
これは話題に入れないとダメだ、と思い、深夜1時過ぎまでスライドを更新していました。

その論文がこれ、
あの、Mount Sinaiのチームの仕事です。
2014年、アキバでPacBio現場の会、をやりましたがその時の演者の1人、Bobbyさんの講演を覚えている方は、「ああ、あの仕事がついに!」と思ったのではないでしょうか。

彼らは、今までのショートリードとPacBioリードというハイブリッドアセンブリの概念を覆す、新しいハイブリッドアセンブリを行なっていました。
彼らのは、PacBioロングリードと、BioNanoゲノムマップによるハイブリッドアセンブリ。

BioNanoのテクノロジーは今日はあまり詳しくは書きませんが、ゲノム上に特定の短い配列があるとして、ゲノム抽出後にそれを酵素が特異的に認識、蛍光を付け、そのDNAフラグメントを機械にかけて蛍光を検出します。
そうすると、ゲノム上のその特定塩基配列があった場所が蛍光でわかります。
ゲノム配列全体がわかるのではなく、特定認識配列があった場所の情報(ゲノムマップ)がわかるというわけ。

この論文を読むときは是非、Supplement 1も手元にあったほうが手順がわかりやすいです。


彼らはHapMapのDiploidヒトゲノム・NA12878を、P5-C3で合計46x読んだ。
そしてBioNanoでは80xのゲノムマップを読んだ(平均278kb)
PacBioデータはエラー補正後、Celera Assembly またはFalcon Assemblyした。
BioNanoのマップデータは一度アセンブリし、Scaffoldを作る。
そのScaffoldにCelera Assemblyで作ったContigをアラインし、Scaffoldにシークエンスデータを足す。Scaffold v1ができる。
Scaffold v1に、Falcon Assemblyで作ったContigをアラインし、Scaffold v2を作る。

こんな感じでScaffoldをきれいにしていって、ヒトゲノムを構築していった。

最終的には、Scaffoldが202本、NG50 はなんと28.8Mb!!
これは驚き、というか衝撃!

もちろんここから、構造変異を見つけていくわけです。

彼らの目標は、リファレンス配列並の高精度のゲノム配列を、いかに簡単に今あるテクノロジーでつくること。
BioNanoは技術的にはPacBioと全く異なりますが、うまく両方使えば他のどのテクノロジーでもできないようなことを可能にする、そんな論文です。

もちろん、このようなアセンブリは、BioNanoだけ持っていても不可能です。
BioNanoとショートリードでも無理でしょう。
PacBioが絶対に必要です。

2015年3月4日水曜日

AGBTレポート3:Human Genome Assemblyには何時間かかる?

しつこいようですが、私はAGBT行っていません(笑)。

PacBioのランチョンセミナーにて、ヒトゲノムのアセンブリがいくつか発表されました。

  1. J. Craig Venter博士のゲノム
  2. (おととい書いた)Breast Cancer細胞株のゲノム
  3. 韓国人リファレンスゲノム by Macrogen社

そのうち、Venter氏のゲノムと、SK-BR-3株のゲノムのアセンブリは、DNAnexus社のクラウド計算機を使うことで、それぞれたった2日で終わったそうです!


Venterゲノムを例に挙げると、PacBioのP6C4試薬で読んだ、平均リード長14kb、N50リード長19kbの、ロングリードを1790万本、総塩基数266Gb(85x)をインプットデータとして用意。
DNAnexus上のクラウドサーバでFALCONを流し、ContigのN50はなんと11.5Mb !! 全体の塩基のうち1Mb以上の長さのContigが97.8% !!
これら計算にかった時間は48時間、計算ピーク時のCPUコア数は14,000

クラウドサーバでヒトゲノムのアセンブリ、それも最高に素晴らしい(長い)Contigが2日で出てくる時代、ですか・・・。

気になるお値段ですが、DNAnexusのサイトには、1回5千ドルから1万ドル、と書いてありました。 そんなに高くない?

レジストしてログインすれば、データ解析のパイプラインを見ることができます。


うーん、やってみたい。
Daligner→Falcon→Quiverの流れ
でもポケットマネーじゃ無理~。

このようなクラウド環境ができるのは、サーバを用意できない、用意したくない、ユーザにとって良いことでしょう。
臨床データをバンバン読むようなところなら、クラウドに上げるのはちょっと抵抗あるでしょう。
でも、PacBioでヒトゲノムアセンブリするのが目的ならまだまだ高価なプロジェクト。
細胞株や、リファレンスゲノムのようなサンプルならクラウドでささっとアセンブルするのも良いのかも。


Lin, Mike (2015): Comparing de novo assemblies of J. Craig Venter's genome. figshare.
http://dx.doi.org/10.6084/m9.figshare.1319564
Retrieved 07:42, Mar 03, 2015 (GMT)

PacBio Onlyのゲノムアセンブリは、GRCh38やHuRef (2007) と比べて全く見劣りしない。
結構驚いたのですが、どうですか?
かたや数十億ドル国際プロジェクト、そして企業の威信を賭けた大プロジェクト。
それが今や、たったひとつの機械で3ヶ月程度のシークエンス時間と、2日間のアセンブリ。

アセンブリ、ですからね。
リシークエンスじゃありませんよ。