ラベル News の投稿を表示しています。 すべての投稿を表示

2018年3月20日火曜日

PacBio Sequel v.5.1  ~もうバージョン5.1になってました、、、

装置やソフトウェア、試薬のバージョンアップは、この業界では頻繁にあることです。
今のSequelでは、装置ソフトウェアと解析ソフトウェアが同じバージョンでそろっていて、試薬やケミストリーが別のバージョン番号で管理しているのです。
ちょっとややこしいですが、試薬・ケミストリーが v.2.1で、ソフトウェアが v.5.0 という感じだったんですね。
解析ソフトウェアSMRT Link(SMRT Analysisを含む)のバージョンが、装置ソフトウェアと同じバージョンです。

そこで今回、新たなバージョンアップ!

ソフトウェアが v.5.1になり、ケミストリーが 2.1 version 2 に!
ん? v.2.1 のさらに v.2 って・・・ と思う方もいるでしょうが、そこは気にしないでください。

装置&ソフトウェアの v.5.1と、試薬 v.2.1(v2)を使った場合のスループットがこちら。
ロングライブラリ(35kb)を10時間読んだとき

ショートライブラリ、5kbアンプリコンを20時間で読んだとき

そう、v.5.1から、10時間ムービーと20時間ムービーが選べます。
20時間で読む場合は、LRという別のSMRT Cellを使う必要があります。
(因みにスタンダードのセルよりもLRセルの方が若干高価)

どう使い分けるのか?ですが、今のところ、
  • ゲノムアセンブリのような長いインサートライブラリは10時間
  • PCRアンプリコンやIso-Seqのような短いライブラリは20時間
をお勧めしています。将来的には変わるかもしれませんが、今はこのように、長いライブラリは今まで通りの10時間で読み、短いライブラリは、もちろん10時間でも良いけれど20時間で読むこともお勧め、ということです。
もちろん、20時間で読んだ方がロングライブラリでも長く読めるのでは?という疑問が出てくると思いますが、今のところ、ロングライブラリを20時間で読んでも、10時間で読んだときと平均リード長はほぼ同じ(最長リードは長いが)。というデータが出ています。
LRセルの方が高価だということを考えると、10時間でも費用対効果は良い。

ところが短いライブラリで、主にCCSを作ることを目的としたシークエンスでは、20時間は生きてくるのです。
先のデータによると、

35kbライブラリの場合、10時間で読んだとき
  • データの半分以上は、30kb以上の長さのリード(ポリメラーゼリードとサブリードはほぼ同じ長さとみて良い)
  • 最長リードは90kb超え
  • 1セルあたりの出力塩基数は 10Gb
  • 出力リード数は40万

5kbアンプリコンライブラリの場合、20時間で読んだとき
  • データの半分以上は、70kb以上の長さのリード(アンプリコンサイズが5kbだから何度もインサートを繰り返し読むことのできるポリメラーゼリード、が多く出力される)
  • 最長ポリメラーゼリードは180kb超え
  • 1セルあたりの出力塩基数は20Gb
  • 出力リード数(この場合出力CCS数と言っても良い)は40万

アプリケーションごとのSequel v5.1パフォーマンス(1 SMRT Cell あたりの出力)は以下のようになっています(v5.1 Software Upgrade and Performance Overview - Customer Training より引用)

Whole Genome Sequencing for De Novo Assembly
-Up to 10 Gb:サイズセレクション済の 40kb以上のロングライブラリの場合
-Up to ~7-10 Gb:サイズセレクション済の 15-40 kbロングライブラリの場合

Iso-Seq 完全長 cDNAシークエンス
-Up to 20 Gb
-Up to 250,000-350,000本の full-length non-chimeric (FLNC) reads

Targeted Sequencing (アンプリコンシークエンス)
-Up to 20 Gb
-Up to 300,000 CCS reads:2.5 kb アンプリコンの場合
-Up to 200,000 CCS reads:5 kb アンプリコンの場合
-P1リードのうち 40% 以上は QV 30 のCCSを作成可能:5 kb アンプリコンの場合

Structural Variation Calling (構造変異解析)
-Up to ~7.5 Gb: サイズセレクション済の 15kb ロングライブラリの場合

「Up to」と書かれていますね。これは、そういう意味です。
必ず出る保証はないけれども、うまくいけばこのくらいの塩基は読めるという。

と書いていて自分で言うのも何ですが、数字ばかり並べてもあまり説得力がないと思います。
それぞれ、研究にどれだけ使えるのかを具体的に示せなければ意味が無い。
これについては次に書く予定です。

お知らせ:
3/25-26 日本育種学会総会
3/27-28 日本細菌学会総会
にそれぞれ出展します。どちらも福岡での開催です!

2018年1月16日火曜日

PAG XXVI 学会(その2)PacBioとDovetailの新情報

今回のPAGではゲノムアセンブリ関係で2つの大きなニュースがあります。
まずはPacBioの最新スループット
これは今日のワークショップでMarty(製品担当責任者)が発表していたのでそのまま紹介しますね。
PacBioワークショップより Martyの発表

な、なんと、ポリメラーゼリードのN50 が30kb超!
つまりデータの半分以上が30kb以上の長さということ。
1セルあたりの塩基数は10Gb
リード数は40万本
いいですねえ、素晴らしい。

ロングリードのあちらの会社には負けてませんよ!


もうひとつのゲノム関連企業、Dovetail Genomics
こちらは新製品の発表です。
Dovetail Hi-Cキット
Hi-Cライブラリ作製キットです。
もうウェブサイトにも情報が載っているので見た方もいるでしょうか。
これは、1キット8本入りで、1本は3Gbまでのゲノムサイズに対応しています。
つまり5Gbのゲノムなら2本分が必要。3Gbゲノムサイズまでの生物なら1キットで8サンプル分が作れます。

ユーザはこのキットを使う前に、自分が読みたいゲノムのドラフトアセンブリを持っていることが条件です。
さらにそのアセンブリのコンティグ/スキャフォルドのN50 が1Mb を超えていることが必要です。
その理由は、Hi-Cで良い結果を出すためにはもともとのアセンブリのクオリティが良い必要があるからです。
そのクオリティ(N50=>1Mb)に達していない場合は、あらかじめPacBioでアセンブリしておくか、Chicagoを使ってアセンブリしておくか、いずれかが必要でしょう。

さて、Hi-CキットでHi-Cライブラリを作ったら、自分のところでシークエンスします。
HiSeqXで1レーンくらい読めば3Gb程度のゲノムなら事足ります。

読んだリードを自分のドラフトアセンブリと組み合わせてスキャフォルドするには、HiRiseというソフトウェアが必要です。
これを追加料金でDovetailにお願いするも良し、自分でやってみたい場合はDNANexusのクラウドパイプラインを使って無料で1回やるも良し。
このキットにはDNANexusのパイプラインで1回解析する分のライセンス料も含まれています。

現在はまだ、哺乳類でしか検証していないので他の生物種でうまくいくかは未確認ですが、いずれできるようになるでしょう。
そして4月以降のどこかで、植物用のキットも出る計画。
気になるお値段ですが、来週以降に決定する予定です。お楽しみに。

キットを販売すると言っても、今まで通り受託サービスも続けますから、全部お任せコースも維持します。
Dovetailは公平な目で見ても、今年のPAGで一番勢いのある会社と言っていいと思いますよ。

2017年9月13日水曜日

ナノポアZMWって何?

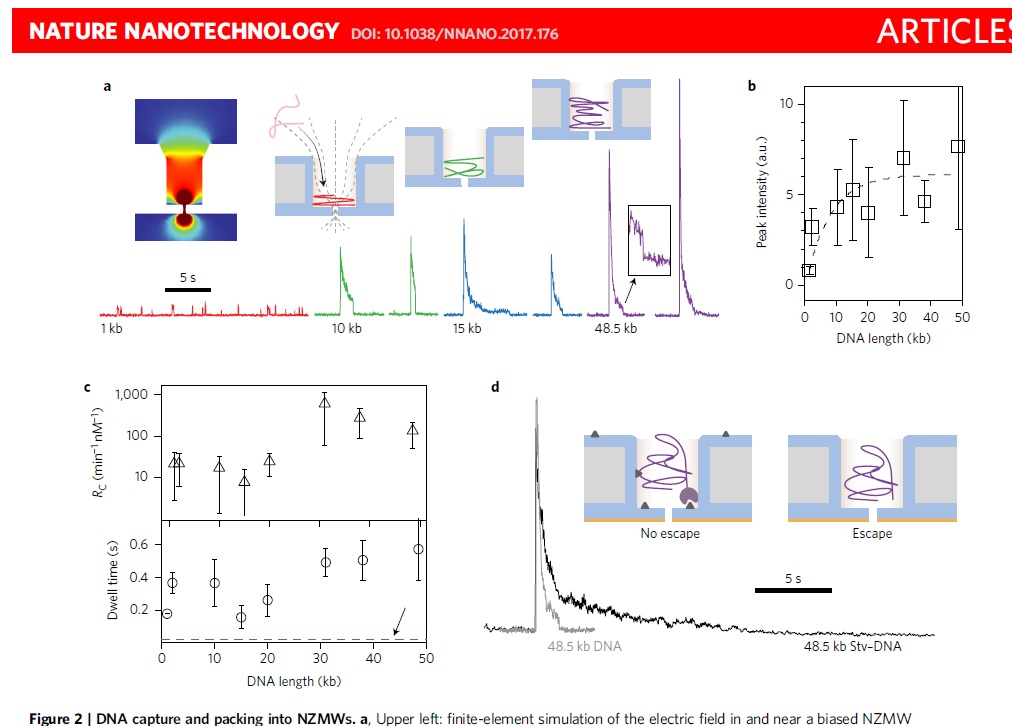
Twitterやその他SNSで知った人もいるかと思いますが、こんな論文がNature Nanotechnologyから出ています↓
"Length-independent DNA packing into nanopore zero-mode waveguides for low-input DNA sequencing"
はて、ナノポア? ZMW? そしてオーサーの一人はPacBioのCSO(最高科学責任者)?
そうです。これはナノポアとPacBioのSMRT Sequencingの両方の技術を組み合わせた新しい技術です。
どんなものかというと、今のPacBioのSMRT CellにはZMWという微小ウェルがありますね。
PacBio・SMRTシークエンスの良いところはたくさんありますが、唯一の欠点はDNA量。
ナノグラム単位のDNA(ライブラリ)をアプライする必要があります。
これをピコグラム単位にすることは、裏プロトコルはあるにはあるのですが、結構難しい。

単純に言うと、ZMWのウェルの中にDNA‐ポリメラーゼの複合体をロードする効率が悪いからです。
長いライブラリ(例えば20kb)は短いライブラリ(例えば1kb)よりもウェルに入りにくい。これをローディングバイアスという。
マグネティックビーズを使って物理的にロードする方法はRSIIの時代に確立されましたが、それでも効率よくライブラリをウェルに入れるのは今でも難しいものです。

ONTのナノポアには、ポアにDNAを通すため、ガイドプロテインをいうものを使います。
この論文にあるナノポアZMW(NZMW)は、ZMWの底にナノポア(穴)を開け、電圧を使ってDNAをZMWにガイドするそうです。

これによるとかなり効率よくDNAライブラリをローディングできるらしい。
10ピコグラムのDNAでも1分以内にローディングできるとのこと。
20kbライブラリの場合、2秒の電圧パルスの結果、DNAをNZMWに吸着できた。
ローディングバイアスも見られず、1kb~48.5kbまでのライブラリをローディングできたとのこと。
Larkin et al., Fig 2

そこまで言うと、じゃあこれが次のPacBioのバージョンアップ技術になるの?
と思うでしょう?
残念ながらこれはまだPOP (proof of principle)の段階で、すぐに商品化されるわけではありません。と、CSOのJonas Korlachも言っています。
でも実現されれば面白い。装置の改良も必要かもしれませんが。
詳しくはNature Nanotechの論文

またはGenomewebのこの記事を参照ください。

有料記事なので詳細は書きませんでした。ご了承下さいまし・・・
個別にディスカッションしましょうね

2017年8月4日金曜日

PacBio 2017年後半戦が見通し明るいそのわけとは?

これを書いている今日は8月4日、昨日のPacBioの株価は前日比で14%も上昇しました。
こういう時は何かニュースがあったのでとりあえず本社のサイトやSNSをチェック!

アメリカ時間で8月2日に第二四半期の発表がありました。
CEO自らが投資家向けにプレゼンする場で、これは録音されて、翌日には誰でも聞くことができます。 一応、視聴するには登録が必要

数字については、私はその辺(アメリカ企業の経営に関する数字)は詳しく無いので評価できません。
でも、悲観的か楽観的かというと、明らかに楽観的な見通しでした。
このプレゼン時間の半分以上が投資家からの質疑応答になるのですが、厳しくは無かったです。

で、良いニュース(これが今回の株価14%UPにつながっているかは不明)はこちらです。

  • 装置の売り上げは顧客のバジェットタイミングによるので不安定だが、試薬売り上げはSequel台数が増えるにしたがって着実に増えている
  • 中国のNovogeneがSequelを10台追加で注文(これで20台購入!)するなど、中国の売り上げが堅調
  • Sequelの新ソフトウェア version 5 のアップデートが始まり、テストデータはとても良い
全世界でRSIIとSequelを合わせると、現在300台以上が導入されています。
この数字は5月のものなので、最新ではもっと行っているはず。
装置が増えればそれに伴い試薬の購入も増えるわけですが、この傾向はシークエンスラボで顕著だそうです。

どういうことかというと、一般のアカデミアは、プロジェクト単位でシークエンスが行われるので、プロジェクトが終わると一息つくことが多いですね。
日本以外でもこれは同じで、プロジェクトごとに予算が付く。そうすると、それが終わったとたんにシークエンスしなくなる。

ところが、営利企業やシークエンスコアラボでは、ひとつのプロジェクトに左右されないので通年シークエンスされるとのこと。
日本でもまあ、そんな感じでしょうか。年度末は忙しい、というバラつきは多少あるでしょうが。

中国のNovogeneという会社、これは世界最大のシークエンスラボのひとつです。
ここ2年くらいで、PacBioの最大の顧客になりました。
Sequelを10台保有し、さらにこの度もう10台の購入を決定! 世界一、Sequelを保有する機関になりました。
彼らがなんでこんなに(20台も)Sequelを買ったのかというと、ロングリードに積極的に投資しているからです。ちなみにここには政府系の投資会社もお金を出しているそうです。
Novogeneでは、中国人ゲノムを1000人分読み、構造変異を解析し、世界初の構造変異データベースを完成させる、という壮大な計画があります。
ここに、Sequelが使われるのです。
さらに、Novogeneはシークエンス受託解析企業なので、世界中から顧客を集め、世界一のシークエンス受託会社になることを目指しています。
そんなこんなで今、PacBioのRevenueの25%は中国から得ているそうです。

中国だけでなく、世界の営利企業は積極的にSequelに投資する傾向にあるそうです。

HistogeneticsというアメリカのHLAタイピング企業は、ショートリード数十台に加えてRSIIが動いています。もちろんSequelも。
これは、HLA遺伝子の完全シークエンス(ショートリードでどうしても型が判定できないような難しいローカスのシークエンス)のためにPacBioのロングリードが絶対必要だ!ということで、アグレッシブにRSII、Sequelが使われているそうです。


これらの発表がもしかすると、昨日の株価14%アップに影響したのかな?

PacBioは、先月Sequel用に、これは解析ソフトと装置のソフトの両方で新しいソフトウェアをリリースしました。
昨日のCEOのプレゼンでは、このソフトが順調に動いていて、ある顧客では平均リード長33kb、またある顧客では1セルあたりの出力が15Gbに達したと言っていました。
まあ、これは極端な例でしょう。
実際は、良くて平均12kb、N50 で20kb、塩基出力も良くて10Gb くらいかな、という感じです。
でも2017年の末には、わかりませんよ。

CEOははっきり言っていました。
2018年末までには、今の8倍のウェルを持ったセルが登場し、新試薬などで今よりスループットが30倍Upすると。

2016年12月13日火曜日

2017年もやります! PacBioセミナー@秋葉原

12月も中旬になると、東京も急に寒くなってきました。
毎年、分生が終わったこの時期は、忙しいはずなんだけど・・・「今年も良く働いた!」というへんな達成感がある。あとは飲み会?Year End Party

さて、来年ですが、2月7日(火)に、また秋葉原UDXで「PacBioセミナー」やります。
今回は午後からの半日セミナー。
なぜ午後からかというと、朝から5時まででは長い!という意見が前回あったから。
そこで今回は1時から5時までで、英語での発表はひとつ、PacBio本社からのみ。

NGS現場の会のメーリスにも流しましたが、
今回の名前はシンプルに「PacBioセミナー」。
なぜ「PacBio現場の会」にしなかったかというと
  1. 同じ年にNGS現場の会があるので、社内で「現場の会の準備」と言っとき、「え?どっちの?」とややこしいから
  2. お客さんに紹介したとき、「え?どっちの?」とややこしいから

いう理由でした。

PacBioセミナー 2017
ロングリードが世界を変えた!

【日時】
2017年2月7日(火)
午後1時スタート(受付開始は12時30分~)
午後5時半頃終了予定(その後懇親会あり)
参加料金は無料! 

【場所】
秋葉原UDX

【事前登録制】
ここからかならず登録してくださいね(そのページの一番下に入り口あります)

日本にPacBioが導入されてからまもなく6年目を迎えます。(ということは私も今の仕事してから6年目ということか・・・)
バクテリアゲノムから大型真核生物ゲノムまで、様々なところでSMRTテクノロジーのスーパーロングリードは活躍してきました。今回は、ヒトゲノム、植物ゲノム、そして新型機Sequelにフォーカスしたセミナーを行ないます。もちろん、そのほかのアプリケーションやバクテリアゲノムも忘れません!

今回も、豪華な演者の先生方をお招きします。
  • 芦澤哲夫先生(Houston Methodist Neurology, Director);ショートタンデム反復の拡張と神経遺伝疾患との関連性の研究がご専門。米国NIHの組織するSCAコンソーシアムのリーダー
  • 安田純先生(東北大学 東北メディカル・メガバンク機構 教授);日本人基準ゲノム配列(JRG)をPacBioを用いて決定。このプロジェクトの中心メンバー
  • 榊原康文先生(慶應義塾大学理工学部生命情報学科 教授);11月にNature Communicationsに発表され注目を浴びたアサガオゲノム。その解析チームリーダーでバイオインフォマティクスがご専門
  • 豊田敦先生(情報・システム研究機構 国立遺伝学研究所 特任教授);ゲノム支援・先進ゲノム支援の枠組みの中でPacBio RSIIを様々なプロジェクトに活用され、日本で最もPacBioを使われているユーザのおひとり
  • ほか交渉中演者数名

PacBio本社からは、アメリカでのPacBio応用例をご紹介します(Luke Hickey, PacBio)。
さらに、PacBioアプリケーションアップデートの発表や、今話題のDovetail Genomics(ゲノムアセンブリ専門の受託サービス)、Swift Biosciences(少量DNAからのショートリードライブラリ作製キット)の紹介、NGS関連商品の紹介などもする予定です。

今回もPacBioに興味のある現場の方や、ロングリードの可能性に期待する先生方が一同に集まる貴重な場になると思います。
是非この機会にご参加下さい。

しつこいですが事前登録制です。
このページの一番下から、Googleフォームへのリンクへ行って、レジストしてください。
入り口がわからない方は、ここから直接どうぞ

懇親会は、会場近場で18:00から予定しています。

是非こちらもご参加下さい。.

タイトル、アブストなどが決まり次第、またお知らせします。

来年は、手のひらサイズシークエンサーが話題になりそうですが、PacBioはまだまだ負けてませんよ!
ランニングコスト、データ量、精度、供給安定性、サイエンスとしてのデータ、いずれも客観的に見てPacBioの方が上回っている、ということをこれからもお示ししていきます!

なーんて、大きなこと言ってますが、アレですね、市場が活性化するのはいいことです。
同じロングリード同士、競いながらもうまく住み分け、するのかな。
これについてはまたの機会にしっかり書きます。
では

2015年12月20日日曜日

PacBio メディカル関係の記事3つ

12月も半ばを越えると、もうアメリカはクリスマスモード。メールもほとんど来ません。
ブログを書く暇があるので、今日は、最近ウェブで紹介された、メディカル関係の記事を3つ紹介します。

まずはこちら、Diagnostics Worldからの記事

Long-Read Sequencing in the Age of Genomic Medicine


Icahn School of Medicine at Mount SinaiのBobby Sebra氏曰く、「Pseudogenes, large structural variants, validation, repeat disorders, polymorphic regions of the genome―all those are categories where you practically need PacBio」
ヒトゲノムに存在する変異には、ショートリードでは検出できない大きな構造変異、リピート変異が多く存在します。これらを検出するにはPacBioのロングリードが不可欠、という話。

技術はある。マシーンもある。あとはソフトだけ。

ソフトウェアは、研究者向けには一通り揃っていますが、お世辞にも現場の医者向けではありません。
それはどのNGS機器でも同じ問題を抱えているでしょう。
Mount Sinaiでも、3台のPacBio RSIIから出てくるデータを効率よく解析できる様に、彼ら独自のソフトウェア・アルゴリズムを作っています。(例:構造変異検出ツールとか)
また、ひとつのテクノロジーにこだわらず、10Xや、BioNano、Oxford Nanoporeなどいろいろな技術を次々に取り入れ試しています。
最近2倍体ヒトゲノムをPacBioとBioNanoで解析し、それまでのどの結果より優れたContig/Scaffold配列を作りました。

このように、他のNGSとは明らかに優位性を持つPacBioのロングリード。
メディカルの現場に持ってくるにはどうしたら良いか?

言うまでも無く、機械の使いやすさと安定性、低コスト、わかりやすいソフトウェア、が必要でしょう。
RSIIからSequelになって、実際のところはどうでしょうか?

Sebra氏は、Sequelのアーリーアクセスユーザでもあります。
その辺の話は、また今度、2月23日(火)に秋葉原で行なわれる、「第二回PacBio現場の会」ワークショップセミナーにて、詳しく聞けますよ。
お時間があれば是非ご参加下さい!お楽しみに!

ちなみにこの記事の中に登場する英語で、「Off-the-shelf」というのがあります。
いつでも買える、とか、入手可能な、という意味です。
Off-the-shelf analysis, with readable diagnostic reports for doctors
というと、医者が読みやすい、臨床レポートが出てくる解析ツールの存在、という意味。
今はまだありませんが、これなくしてクリニカルシークエンスの現場に普及するのは難しいですから、絶対できるはずです。


次はGenomeWebから(ごめんなさい、これは有料みたいです)

Baylor Team Explores PacBio Long Reads for Detecting Pathogenic Structural Variants in Patients

こちらはBaylor College of Medicine & Miraka が考えている、ヒト診断への可能性についての記事です。
BaylorのAssistant Prof. Bainbrigdeは述べています(ざっくり翻訳)。
「ヒト全ゲノムのシークエンスが現実的なものになり、皆さんこれで構造変異などの問題は全て解決できる!と思ったはずです。でも、たいていの構造変異検出プログラムは、変異全体の1/3~1/4ほどしか検出できていないんです。それらを合わせても半分くらいしか実は検出できていないことになります。でも、6,000~10,000 bpのロングリードを使えば、もっと簡単にできるはず」

Proof-of-Concept(できるかどうか試してみよう実験)にて、Baylorのチームは、PacBioのロングリードが、どれだけ遺伝子検査に応用できるかを調べました。
彼らはまず、既知の疾患関連遺伝子ベスト100にフォーカスしています。その中には、がん関連遺伝子60余りや、シングルセキソンの抜け落ちが原因で引き起こされる疾患関連遺伝子、Fragile Xシンドロームなどリピートの数が重要となる遺伝子、が含まれます。

そのような、重要遺伝子だけをキャプチャーする技術、キャプチャーシークエンスとかターゲットリシークエンスとか呼ばれますが、これをPacBioのロングリードにも応用できます。
前のブログ「PacBio-LITS PacBioでターゲットリシークエンス 1& 2」でも紹介しましたが、プローブを用いて、7kb程度のロングリードをキャプチャーできるようになったのです。

今までのキャプチャーシークエンスといえば、タンパクコーディング箇所に焦点を当てた、エキソームシークエンスが有名ですね。
各メーカーがキットを出しています。
PacBioのロングリードでできるキャプチャーは、エキソンのみならず、遺伝子全体なんです。
遺伝子全体をキャプチャーできるアプリケーションはPacBioのロングリード無しではできない。
これはがん遺伝子もそうですが、HLA遺伝子なんかも、全体をキャプチャーしたほうが複雑な変異(phasingなど)を検出できるので良いと思います。


最後は、こちら
Front Line Genomics Magazine  Issue Six


こちらの雑誌はフリーで全文読むことができます。
その42~43ページめにPacBioの記事があります。
インタビューに答えているのは、PacBio本社のマーケ担当、イケメンLuke Hickey

内容は、これまでPacBioを使って挑戦されてきたヒトゲノムアセンブリの紹介と、On-Goingなプロジェクト。

ハプロイドのヒトゲノム(hydatidiform mole, CHM1)をPacBioで読んで読んで・・・というのは、以前このブログでも紹介しましたが、その時はWashington University in St. Louisのプロジェクト。
大学名が似ているのでたまにごっちゃになるのですが、こちらはthe University of Washington、さらにUniversity of Bari Aldo Moro と University of Pittsburghのチームは、同じくハプロイド株を40X PacBioで読んで、リファレンスゲノムに存在する160箇所のギャップのうち半数以上を、クローズするかギャップを縮めたそうです。
そのほとんどはGCリッチな場所、反復領域だったとのこと。
さらに、100万塩基以上の新規の配列を追加。
彼らが見つけた26,079個の変異箇所のうち、コピー数変異の85%、挿入変異の92%、欠損変異の69%が、これまでに報告の無い新規だったそうです。

ということは、リファレンス配列といっても、まだまだ完璧ではなかったんですねえ。

リファレンス配列といえば、ここ数年、人種ごとにリファレンスを作ろう!的なプロジェクトが動いています。
韓国のマクロジェン社とソウル大学が推し進める、韓国人リファレンスゲノム計画は、PacBio、BioNano、BACシークエンスを使ってデータを出し、完成に近づいています。
GRC(Genome Reference Consortium)アセンブリよりも、よりアジア人を代表するリファレンスゲノムになる予定です。

さらに、あのCraig Venter博士が率いるHuman Longevity, Inc. では、世界の人種を代表するゲノム、30リファレンスを作成する計画があるそうです!
何とも壮大な計画・・・
Front Line Genomics Magazine,  Issue Six, p43
こういう夢のある計画、いいですね。

ヒト以外の生物でも、もう一回PacBioで全ゲノム読んでみたら、意外と新規配列がたくさん見つかるかも。


2015年7月18日土曜日

PacBio Asia User Group Meeting 速報


今年も、PacBioアジアユーザーグループミーティングが行なわれました。
場所は去年と同じ、シンガポールのGrand Copthorne Waterfront ホテル。
ここはANAのCAさん御用達のホテルなのです。
ANAの制服のままのCAさんとホテルのエレベーターで一緒になるとドキッとしますね。
いろんな意味で(笑)。

さて話をユーザーミーティングに戻すと、今回は第3回、参加人数は昨年の2倍近い140名!
規模が大きくなった分、以前のようなアットホームさは無くなりましたが、これも成長しているということでしょうか。

今年、存在感を増していたのが韓国チーム。
韓国からは、受託会社のマクロジェン、DNALink、バイオンフォ受託会社のChunLab、の3社が発表。
マクロジェン社は皆さんご存知、韓国人AK1ゲノムをリファレンスレベルクオリティで完成させることを目標に、HiSeq X10システム、RS II2台、をフル稼働させてシークエンスしている会社です。
AGBTのときの発表よりもデータを増やしていました。

DNALink社は、アジアで最初のPacBioを導入した会社です。ここはマクロジェンよりPacBio経験が長いので、実績は多い。
面白かったのが朝鮮半島の東西南の海岸で採取したサンプルでメタゲノム解析を行い、Pacならではのメタメチレーション解析を試みた、という話。
バクテリアのメチレーションのパターンが地域で違う、ということで、他の機械ではできない解析だなと思いました。結論をどうもっていくのか、論文が見ものです。

マクロジェンもDNALinkも、ライバル同士がお互い発表し合い、それぞれ認め合うような、そんな雰囲気でした。

もう1社のChunLabは、今月初めのNGS現場の会でも参加していましたね。
ChunLabは、バクテリアの16S配列をPacBioで完全長読んで、それをもとに種のレベルの分類を可能にする解析パイプラインを提供しています。
ここで、発表者のChun社長は、「16Sを完全長で読んだ場合、一番大事なことはPCRキメラを取り除くこと」と言っていました。
実際にPCRで全長16Sを増幅すると、かなり(多いときは20%も!?)キメラ配列が作られるらしい。
そのキメラ配列を取り除くために、既知の正しい16S配列のデータベースを整備し、その配列と比較することで確からしい配列を判別し、キメラ配列を取り除いているそうです。
確からしい配列のなかには新規の16Sがあるので、それは新たにデータベースに追加される。
そうしてどんどんデータベースが更新されて、キメラ配列除去の精度も上がる。
興味のある方はこちら
でも、アジアには競合がとても多いらしいです。

さて、そのほかにもオランダのバイオテック、Key Gene社は、4倍体の綿など植物ゲノムをPacBioでデノボアセンブリ。
マレーシア大学では天然ゴムを分解するActinomycetes(GCリッチ)をゲノムアセンブリ。
Acceligen社はLivestock(何て訳すのかな)ゲノムの話しの流れで、ヤギのゲノムアセンブリの話。
Arizona Genome Instituteからは、複数BACを一度にシークエンスした話。10個のクローンを1つのSMRT Cellでシークエンスして、10個のContigに。
使ったのはHGAP3のみでインデックス使用していないって!?
その10個がどれくらい違う配列なのか、それにもよるのでしょうが、もう少し聞きたいところ。
早く論文になって欲しい。

今回、大型ゲノムのアセンブリの発表で、BioNanoとのハイブリッドアセンブリがいくつかありました。
確実に来年は、もっと増えてスタンダードになっていることでしょう。
BioNanoは前にも書きましたが、ゲノムマッピングの情報を出してくれます。(配列をマップするの意味では無いです。地図の意味です)
そのマップ情報と、PacBioの配列情報を組み合わせれば、アセンブリにはかなり強い!
でも、やっぱりLife Is Not So Easy!!
BioNanoとPacBioのContigが矛盾することもあるそうで、そういうところは何が起こっているのか、詳しく見ていく必要があるでしょう。


お待たせしました。我が日本からは、内藤さんが登場!
140名が釘付け
Wild Vigna !  
いつものトークでアズキたちのすごさが十分伝わりました。
内藤さん、ありがとう!
最後のSexy、うけてました!

終わってからPacBio Asiaの人から、「日本人研究者って、面白くてエネルギッシュな人が、実は多い?」と聞かれました。ちなみに去年は、阪大微研の中村さんでした。
「若い研究者はね」


皆さん、お疲れ様でしたー
また来年、シンガポールでお会いしましょう!


ちなみに、ツイッターでは
#ugmAsia でミーティングの模様が若干ですが、ツイートされていました。


2015年1月22日木曜日

2015年のロードマップ等々


東京農大で開催された、2014年度拠点セミナー「NGSデータを用いた非モデル生物のゲノム・トランスクリプトーム解析」に参加してきました。
3人の演者の方のうち、2人はPacBioの大ファン!
昨年の「PacBio現場の会」でもお話頂いた、マスター・オブ・デノボの笠原先生
アズキで世界の食糧難に挑戦する、セクシー研究者の内藤先生
お二人とも「PacBioは素晴らしい!」「I社のシークエンサーで読んだ後も、もう一度Pacで読み直そうと思っている」
などなど
会場にいたPacBioの回し者である私は思わず、謝礼を渡したい気持ちになってしまいました。

ありがとうの気持ちはプライスレス

さて、PacBioの2015年の、公式ロードマップが出されました。
全文はここから

スループットについては、
SMRT Cellあたり4Gb、平均リード長15-20kb、ポアソン分布以上のロード率
を達成させます!

we expect to deliver another ~4-fold increase in throughput, reaching >4 Gb of data per SMRT Cell run, with average read lengths increasing to 15-20 kb. We plan to accomplish this through a combination of improvements in the sequencing chemistry, protocol workflows, and software. An example is active loading to increase the efficiency of loading one polymerase per ZMW at frequencies greater than the Poisson limit.

ポアソン分布以上のロード率というのは、これまでは15万のZMWから30%~40%程度のデータしか出てきませんでしたが、これを60%、それ以上に上げるというものです。
濃度を上げてロード率を高めるのではなく、濃度はそのままにリード数を高めるというもの。
どうやるの?
気になりますよね?
これはまだ「Confidential」が取れていないはずなので、もう少々お待ち下さい。


2月下旬の、AGBT学会に行くかた、PacBioはゴールドスポンサーですので、ワークショップを是非のぞいてきてください。 私は行かないんで。 
後で聞かせてください!

そのワークショップで、PacBioだけでヒトゲノムを読んだ、2つのプロジェクトの成果が発表されます!
これまでに無い、素晴らしい結果。
PacBioのデータだけで、しかもデノボだと聞いています。リファレンスガイドのアセンブリではない。
2つのうちひとつは、韓国から。
韓国では、韓国人のリファレンスゲノムを作ろうというプロジェクトが一昨年からありました。
そんな中、どうしてもPacBioが必要だ、ということになったわけです。
彼らとは昨年のASHGで偶然会って、意気込みがすごかったのを覚えています。
どんな結果を発表するのか、気になりますね。

もうひとつはアメリカから。
誰でも知っている、ある有名な科学者の全ゲノムを、PacBioで読んだそうです。
そしてこれまでに得たことが無いくらい長いContig N50を達成したそうです。
驚かすために、誰のゲノムかは秘密。
でも何となく、予想はつきますよねえ。
ビッグ・サイエンティストといえば・・・

1. ジェームズ・ワトソン?
2. グレイグ・ベンター?

DNAが分解していなければ、故人というのもありえる
3. アルバート・アインシュタイン?

誰でしょうね。でもこれがNCBIに載るということは・・・


2014年9月17日水曜日

Mount Sinai Opens New Genomics Lab

Mount Sinai といえば、今年の5月、「PacBio現場の会」でゲストスピーカーとして招待した Dr. Robert Sebra、覚えていますか?
彼のインタビューがフライヤーになりました!
こんな感じ
展示会などで配られるはずです。


そしてMount Sinaiからまたひとつ新たなニュースが飛び込んできました。
こちらの記事をご覧ください。
先日Genome WebでPremiumユーザでないと見れない記事が、もうオープンになっていました!


Icahn Institute at Mount Sinai では、新たに遺伝子診断用のクリニカルラボを建設中です。
Roche454があった建物らしいです。
そして人間も、Roche454から引っ張ってきたと書いています。

彼らがターゲットとするのは、がんを含む様々な疾患。 
700の疾患関連遺伝子をターゲットに、26,000のアンプリコンを、Ion TorrentのカスタムAmpliseqを利用してパネルを作製しているとのこと。
カスタムAmpliseqを自由に設計(Life Techによれば設計自体は無料とのこと)できるのは素晴らしいですよね。

この記事に出てくる、Mr. Glenn Farrell、彼も5月にBobbyと一緒に来日しました。
なので早速メールしたところ、遺伝子リストはまだ公開されないそうです。
今のところ、プロジェクトの参加者内でのリストにとどめているとのこと。
いずれにしても、メーカーが販売している遺伝子パネルとはだいぶ違うでしょう。

そして注目すべきは、Mount Sinaiでは既に2台、PacBio RSIIを持っているのですが、今回、3台めをこのラボ用に購入するということです。
彼らがどうやって、PacBioをクリニカルに応用していくのか見ものです。
何てったって、このラボのトップ、Dr. Eric Schadtは、設立初期のPacBioで長年CTOを勤めただけあって、PacBioの技術には精通しているからです。
もちろん、私もフォローしていくつもりです。

これから益々PacBioもNGSも、盛り上がっていくような雰囲気を感じます!


ところで、ライフテックのAmpliseqでカスタムに設計したアンプリコンは、PacBioで読めるんでしょうか?
原理的には読めるはずですが。
誰か、PacBioで読むことを前提にした、疾患カスタムアンプリコンに興味のある方いませんかね。
一から設計したい、PacBioで読んでみたい、という独創的かつ野心的な方、いたらお知らせください。 力になります! なれると思います。

2013年5月8日水曜日

ニュースレター 2013年春 より


PacBioのメール通信に登録していると、四半期に一回以上、ニュースレターが届きます!
今日はそのお知らせ。

ニュースレターを購読していない方は今回だけ、こちらからどうぞ(http://www.pacb.com/newsletter/2013/spring/)

その中でも、おそらく皆さんが注目するのがここ(矢印)でしょうか?
今後のPacのロードマップです。

今までプレゼンなどでは言ってきた内容ですが、このたび公になったということは、リリースに向けていよいよ準備ができてきた、ということです!

"Also in the works: we are developing a protective scaffold between the fluorescent dye and the nucleotide that minimizes photodamaging effects the dye may exert on the sequencing polymerase. Such photodamage can reduce read lengths, and our results in R&D from the new, photo-protected nucleotides are very promising. We believe this advance will allow average read lengths of 7,000 to 9,000 bases — roughly another doubling of the read lengths compared to our current XL chemistry."

レーザーによってヌクレオチドに結合している蛍光が光る度に、すぐ近くのポリメラーゼにエネルギーが渡り、ポリメラーゼ活性が劣化していくのが今までの問題でした。 そこでR&Dでは昨年から、蛍光分子とヌクレオチドの間に新たに分子を挟ませる研究をしていました。 傘のように、蛍光からポリメラーゼを守るのです。
そうすることで、平均リード長が7000~9000bpほどに伸びることが可能になる、というのです!

平均9000bp !?
すごい! これはすごい!
私も昨年の夏、この話を聞いた時には正直、半分、どうかなあ~って思っていました。
でも、昨年から今年にかけて、だんだん現実味をおびてくるにつれて、ワクワクの気持ちに代わりました。

サンプルプレップ時の調整や改良と合わせると、1セルあたりの出力が、今の100Mb(または200Mb)から、500Mb~1Gbになってくるというのです。


話は変わりますが、5月18日から3日間、アメリカのコロラド州デンバーにて、American Society of Microbiology があります。 PacBioも出展します。
私は行きませんので、PacBioの仲間に聞いて、色々情報をアップデートしようと思います。
確か全てのプレゼンが公開されるはずです。