ラベル Sequel の投稿を表示しています。 すべての投稿を表示

2018年4月23日月曜日

ローディングリコメンデーションという「推奨」

PacBioに限らず、ローディングリコメンデーションという単語があります。
アプライDNA量の推奨値、という方がわかりやすいでしょうか。
シークエンスデータが最も最適に出力されるような、DNAライブラリの濃度と量のことを示しています。

「最適に出力」という意味は「より長いリードをより多く出力」と考えてかまいません。

その前に、、、
P0、P1、P2、というPacBioに特別な単語があります。
これはZMWの中にポリメラーゼとSMRT Bellライブラリのコンプレックスが入ってシークエンスされるわけですが、そのデータを見て、

  • P0:データ無し→つまりZMWにライブラリが入っていない。空っぽ
  • P1:きれいな1分子のDNAデータが出てくる→きちんとZMWにライブラリが入って、かつシークエンスがされていた
  • P2:上記以外→データがノイズばかりの場合。ZMWに複数ライブラリが入った場合。クオリティが低いリードしか読まれていない場合など
を区別しています。
実際解析に使用されるデータは、P1のデータです。
アプライDNA量が極端に少なければ、ZMWに入るライブラリが少ししかないのでP0が増えます。逆に極端に多くライブラリを入れた場合は、オーバーロードと言って、P0は減るかもしれませんがP2が増えることが予想されます。

RSIIや初期のSequelの場合、ZMW全体のうち20%~40%のZMWからP1データが出力されることが望ましい、と言われていました。
ポワソン分布に従うならば33%、それをもっと上げるためにマグビーズなどが使用されて40%、多い時は50%を目指していました。

Sequelの5.1になり、そのリコメンデーションが改訂されました。ここ
  • P1はほとんどのアプリケーションで50%以上を目指すように
    (ただし、あまり多くのP1リードを目指すとリード長が短くなる恐れもある)
  • オーバーロード(ライブラリの入れすぎ)の指標は、P0の値を参考にする。P0は20%くらいが望ましく、10%を切るようならばライブラリ量を減らした方が良い
  • Iso-Seqやアンプリコンの場合、Pre-extension(読む前にシークエンス反応をある程度進める方法)をするので、P1は70%を目指すことが可能で、P2は20%未満を狙う
  • Expressキットを使うゲノムアセンブリ用のロングライブラリの場合、P1は50%台を目指す
  • バクテリアのマルチプレックスは、P1は50~65%を狙う
と、細かいことですがつまり長いライブラリでもZMWの半分からは良いデータが出てくるような濃度でアプライすることを推奨しているのですね。
SequelセルのZMWは100万あるので、50万本のロングリードが1セルから出力されることを想定して、最適なライブラリ濃度を調整することが必要というわけです。

短めのライブラリ、Iso-Seqやアンプリコンの場合は、最高70万本の配列が出力されることが十分あり得るのでデータ単位のコストはかなり低くなると思います。

ここまで書きまして思うところがあるのですが、
P1の数字を狙って濃度調整することは難しい!
というのがユーザの本音だと思います。

なのであくまでもリコメンデーション、推奨、なのです。
「その値を狙ってアプライしたときが一番良い結果を生むと思います。ですが結果はサンプルにも依存するので必ず良い出力を出すという保証はございません」
という意味です。

なので受託に頼んでスループットが予想ほど良く無くても、受託会社さんを責めないでくださいね。

2018年4月17日火曜日

ハイブリッド でIso-Seqしたい方はこの論文を!

Iso-Seqは皆さんご存じですね。
PacBioのロングリードで完全長cDNAを一気に読んで、スプライシングバリアントを含めたRNAの構造解析をする方法です。

ショートリードでデノボで転写産物をシークエンス&アセンブリする方法には、Trinityという有名なものがあります。
しかしリピート配列があると正確に転写産物を再現できない、K-merサイズによってはアセンブリが不正確になる、など、ショートリードだけの完全長cDNAシークエンスには限界がありました。

IDP-denovo
そんな中、ショートリードでデノボアセンブリしたアイソフォームコンティグに、ロングリード配列をマッピングさせて、アイソフォーム全体の姿を再現するIDP-denovoというツールが出ました。

この論文はあくまでも、ショートリードがメインで、これを補佐する役割としてPacBioのロングリードが登場します。
正直、私はPacBio一本でやった方が良い気がしたのですが、、、。
だって最初のショートリードのアセンブルで、既に、読める配列がイルミナ技術に依存しているでしょう?
それからPacBioで一分子配列を付け足して補正、ってどれだけ精度が上がるのか疑問。

多分、コストが問題だったのでしょう。
でも今はSequel使えばコスト的にもだいぶ割安感があると思うんですけどね。


さてさて、ここからはIso-Seqの話です。
SMRT Link(PacBio解析ソフトウェア)バージョン5.1には、Iso-SeqとIso-Seq2が搭載されています。
へぇ、Iso-Seq2とは?

その前にIso-Seq解析のおさらいです。
実験のプロトコルはこちらからダウンロードできる。簡単に言うと、

  1. サンプルの中で発現しているmRNAの、完全長cDNAを作る
  2. 完全長cDNAをPCRで十分量増やす
  3. SMRT Bellライブラリを作る(SequelではIso-Seqのサイズ分割は基本行わない。長い転写産物に注目したい場合は4kbを境に分割しても良い)
  4. Sequelで読む→ データが出てくる


ここから先は、SMRT Link 5.1で解析すると仮定しますね。
Iso-Seq解析は最初にCCSを作ります。

5'プライマー、インサート配列、ポリA配列、3'プライマーを持つ場合、完全長cDNAとみなされます。完全長=Full Length(FL)と不完全長=Non-FLのリードに分ける。
このステップがClassify

次のステップがClustering
アイソフォームレベルのクラスタリングを行うにはFLのCCSだけが使われる。
このクラスタリングステップがとても時間がかかり、今まで問題になっていた。
Iso-Seq1では配列の長さが同じくらいのものをまとめ、クラスタリングを行っている。
Iso-Seq2では塩基配列のパターンから同じようなものをまとめ、クラスタリングを行っている。
2の方が1より2倍ほど計算速度が速いとのこと。
さて、クラスタリングしてアイソフォーム配列が出来たら、これにFLとNon-FLのサブリードをアラインし、ArrowまたはQuiverで配列精度を高める。
いずれにしても、転写産物を網羅的に見る場合は、Iso-Seq2の方が良い。
一方、ターゲットIso-Seqの場合は、どのアイソフォームも同じような配列パターンを持つので、サイズによってクラスタリングする普通のIso-Seqの方が良い。

最後に、リファレンスがある場合はGMAPでゲノム配列にマップして、Alternative Splicingを見る。ここはヒトとかマウスとかのモデル生物で行われる。
アイソフォームを見つけたらその精査が必要だ。
SQANTIというツールは見つけたアイソフォーム配列を、機能ごとにアノテーション付けてくれる。
FSM = full splice match   (perfect match w/ known isoform)
ISM = incomplete splice match  (partial match)
NIC = novel in catalog  (novel isoform with known junctions)
NNC = novel not in catalog  (novel isoform with new junctions)
というように。
論文にもなっているのでこちらもどうぞ

そのほかにもありますが今日のところはこれにて


5月18日(金)は秋葉原にて「PacBio現場の会 2018」
登録はこちらから!

2018年4月4日水曜日

PacBio現場の会 2018 登録スタート!

5月18日は、年に一度の現場の会、といっても「PacBio現場の会」です。
今年はもうNGS現場の会が無いので、復活しました、この名前!
場所は秋葉原UDX Next1

ロングリードを愛する全てのひとへ心を込めて

あえてロングリードとしたのは、今やPacBio以外でもOxford Nanoporeのシークエンサーで読んでいる研究者も多いだろうと思うからです。
もしあなたが、MinIONデータで何かを読んでいるとしても、私たちは拒みません。
PacBioがいまだにロングリード市場でメジャーなシークエンサーだということは、紛れもない事実なのですから。

前置きが長くなりましたが、登録サイトがスタートしたのでこちらからどうぞ!
英語名がPacBio User Group Meetingとなっているのは各国で統一感を出すための便宜的な名前なのでユーザーでなくとも参加できますよ


顔写真入りの紹介って、案外良いですねぇ
最新のプログラム、時間割りは「最新プログラムはこちらから」のリンクからダウンロードできます。
まだ変更が入るかもしれませんがご了承下さい。

5月18日ですよー
アキバですよー
時間は1時から開始で、情報交換会もあります 
結構びっちり、勉強になると思います

奮ってご参加下さい ここから

2018年3月20日火曜日

PacBio Sequel v.5.1  ~もうバージョン5.1になってました、、、

装置やソフトウェア、試薬のバージョンアップは、この業界では頻繁にあることです。
今のSequelでは、装置ソフトウェアと解析ソフトウェアが同じバージョンでそろっていて、試薬やケミストリーが別のバージョン番号で管理しているのです。
ちょっとややこしいですが、試薬・ケミストリーが v.2.1で、ソフトウェアが v.5.0 という感じだったんですね。
解析ソフトウェアSMRT Link(SMRT Analysisを含む)のバージョンが、装置ソフトウェアと同じバージョンです。

そこで今回、新たなバージョンアップ!

ソフトウェアが v.5.1になり、ケミストリーが 2.1 version 2 に!
ん? v.2.1 のさらに v.2 って・・・ と思う方もいるでしょうが、そこは気にしないでください。

装置&ソフトウェアの v.5.1と、試薬 v.2.1(v2)を使った場合のスループットがこちら。
ロングライブラリ(35kb)を10時間読んだとき

ショートライブラリ、5kbアンプリコンを20時間で読んだとき

そう、v.5.1から、10時間ムービーと20時間ムービーが選べます。
20時間で読む場合は、LRという別のSMRT Cellを使う必要があります。
(因みにスタンダードのセルよりもLRセルの方が若干高価)

どう使い分けるのか?ですが、今のところ、
  • ゲノムアセンブリのような長いインサートライブラリは10時間
  • PCRアンプリコンやIso-Seqのような短いライブラリは20時間
をお勧めしています。将来的には変わるかもしれませんが、今はこのように、長いライブラリは今まで通りの10時間で読み、短いライブラリは、もちろん10時間でも良いけれど20時間で読むこともお勧め、ということです。
もちろん、20時間で読んだ方がロングライブラリでも長く読めるのでは?という疑問が出てくると思いますが、今のところ、ロングライブラリを20時間で読んでも、10時間で読んだときと平均リード長はほぼ同じ(最長リードは長いが)。というデータが出ています。
LRセルの方が高価だということを考えると、10時間でも費用対効果は良い。

ところが短いライブラリで、主にCCSを作ることを目的としたシークエンスでは、20時間は生きてくるのです。
先のデータによると、

35kbライブラリの場合、10時間で読んだとき
  • データの半分以上は、30kb以上の長さのリード(ポリメラーゼリードとサブリードはほぼ同じ長さとみて良い)
  • 最長リードは90kb超え
  • 1セルあたりの出力塩基数は 10Gb
  • 出力リード数は40万

5kbアンプリコンライブラリの場合、20時間で読んだとき
  • データの半分以上は、70kb以上の長さのリード(アンプリコンサイズが5kbだから何度もインサートを繰り返し読むことのできるポリメラーゼリード、が多く出力される)
  • 最長ポリメラーゼリードは180kb超え
  • 1セルあたりの出力塩基数は20Gb
  • 出力リード数(この場合出力CCS数と言っても良い)は40万

アプリケーションごとのSequel v5.1パフォーマンス(1 SMRT Cell あたりの出力)は以下のようになっています(v5.1 Software Upgrade and Performance Overview - Customer Training より引用)

Whole Genome Sequencing for De Novo Assembly
-Up to 10 Gb:サイズセレクション済の 40kb以上のロングライブラリの場合
-Up to ~7-10 Gb:サイズセレクション済の 15-40 kbロングライブラリの場合

Iso-Seq 完全長 cDNAシークエンス
-Up to 20 Gb
-Up to 250,000-350,000本の full-length non-chimeric (FLNC) reads

Targeted Sequencing (アンプリコンシークエンス)
-Up to 20 Gb
-Up to 300,000 CCS reads:2.5 kb アンプリコンの場合
-Up to 200,000 CCS reads:5 kb アンプリコンの場合
-P1リードのうち 40% 以上は QV 30 のCCSを作成可能:5 kb アンプリコンの場合

Structural Variation Calling (構造変異解析)
-Up to ~7.5 Gb: サイズセレクション済の 15kb ロングライブラリの場合

「Up to」と書かれていますね。これは、そういう意味です。
必ず出る保証はないけれども、うまくいけばこのくらいの塩基は読めるという。

と書いていて自分で言うのも何ですが、数字ばかり並べてもあまり説得力がないと思います。
それぞれ、研究にどれだけ使えるのかを具体的に示せなければ意味が無い。
これについては次に書く予定です。

お知らせ:
3/25-26 日本育種学会総会
3/27-28 日本細菌学会総会
にそれぞれ出展します。どちらも福岡での開催です!

2018年3月16日金曜日

Human Genome Meeting 2018 @パシフィコ横浜 終了!

あー、終わった終わった。
いつも学会展示会の後はそう思います。
立ちっぱなしも結構疲れるんですよ。

今週はHuman Genome Meetingという国際学会に出展していました。
RIKEN&Hugoが主催で開いたこのミーティングには、およそ400人の国内外のヒトゲノム研究者が集まったそうです(最終参加人数はまだ聞いていませんが、およそそれくらいの人数かと)

どうですか? このすばらしいブースデザイン!
サイズ感がわからない?
バックの絵は高さが2mちょい、横幅は4mくらいあるんですよ。

他にもたくさん企業が出展していまして、ロングリードのもうひとつの会社も、ショートリードの会社ももちろん。
シークエンス受託会社も、タカラバイオさんをはじめ、マクロジェンさん、Novogeneさん、DNA Linkさん、BGIさんも出展。
BGI シークエンサーも、展示してありました。100bpまたは200bpのペアエンドで読めるらしいです。
イルミナさんの iSeq は、斬新なデザインでしたね。白いカクカクっとした立方体。
半導体のチップは、どこかの会社のアレにそっくりでした。
さすがに写真は撮らなかったですけど。

さてさて、私たちPacBioは、初日にスポンサーセッションとランチョンセミナーをやりました。
スポンサーセッションでは、東京大学大学院医学系研究科 ゲノム医学講座の河津正人先生に、「Genetic status of immune microenvironment in microsatellite instability-high colorectal cancers」という題名でお話し頂きました。

ランチョンセミナーでは、前半をPacBioのCSO、Jonas Korlachが「Accessing the full size-spectrum of human genetic variation using PacBio long-read SMRT sequencing on the Sequel System」
後半をHouston Methodist Research Instituteの芦澤哲夫先生に「Internal sequences of large pentanucleotide repeat expansion alleles in SCA10」というタイトルでお話し頂きました。

Jonasの講演

芦澤先生の講演

翌日、私たちはアジア時間に合わせてウェビナーを行いました。
芦澤先生には、こちらのウェビナーでもお話し頂き、たくさんの参加者が参加されました。
当日参加できなかったかへ朗報。
ここからビデオ録画が視聴できます。

精神疾患とその原因のひとつと考えられている、繰り返し配列のシークエンス。
Cas9を応用したPacBioのEnrichment技術。
PacBioはまさに、メディカルに応用できるロングリード技術である、ということが実感できると思います。

是非ご覧ください。


2018年1月21日日曜日

PAG XXVI 学会(その3)SMRT Developers Conference など

今回のPAGのゲノムアセンブリの発表の中で、特に興味を持ったのは、Trio-binning という方法でF1ハイブリッドのハプロタイプを決める方法。

ウシの場合、黒いアンガス牛と白いブラフマン牛の掛け合わせで、ブランガスという牛がいるそうです。これは、肉質は良いが暑さに弱いアンガスと、肉量は少ないが病気や高温に強いブラフマンの掛け合わせで、両方の良いとこを取ったF1牛です。

このようにして作りだしたF1ハイブリッド種は、とてもゲノムのヘテロ性が高いと想像できます。
ゲノムを読んでアセンブリしたら、ゲノムサイズx2くらいのアセンブリサイズが作られるでしょうね。
それにPacBioのようなロングリードで深く読んだとしても、Falcon Unzipではハプロタイプスイッチ、ということがおきて、完全にハプロタイプを決めることは困難。
PAGXXVI Dr. Sergey Korenのスライドより
”Falcon Unzipで作られるPrimary Contigは、正しいハプロタイプを反映しない。
これは、Pseudohaplotypesといった方が良い。
正しいHaplotigsを作るには、もっと別な方法が必要。”

そんな中SMRT Informatics Developers Conferenceでも発表したDr. Sergey Koren が提案しているのは Trio-binningという方法です。
あらかじめアンガスとブラフマンはIlluminaショートリードでたくさん読んでおく。
F1はPacBioでたくさん読んでおく。
F1をアセンブルする前に、F1のPacBioリードを、親のショートリードのK-merで、SNPをもとにそれぞれの由来リードに分けてしまう。
アンガス由来とブラフマン由来に分けられたPacBioリードを、Canuでアセンブルする。
ざっくり言うと↑な感じです。
PAGXXVI Dr. Sergey Korenのスライドより
左がFalcon Unzip、右がTrioBinningの結果
左はアンガスとブラフマンがFalcon Unzipではうまく分けられていない
右は、両者のTrioBinning後のアセンブリがきれいにアンガスとブラフマンに分かれている

このやり方ができるのは、両親のゲノムをもとにF1のリードを分けるので、両親がわかっている場合に限られます。
野生動物や、親がわからない種は、できないのではないかな。


さて、SMRT Informatics Developers Conferenceの発表に使われたスライドはこちらにアップされていますので興味ある方は是非チェック!
PacBioのポスターなどもあるので面白いですよ。

2018年1月16日火曜日

PAG XXVI 学会(その2)PacBioとDovetailの新情報

今回のPAGではゲノムアセンブリ関係で2つの大きなニュースがあります。
まずはPacBioの最新スループット
これは今日のワークショップでMarty(製品担当責任者)が発表していたのでそのまま紹介しますね。
PacBioワークショップより Martyの発表

な、なんと、ポリメラーゼリードのN50 が30kb超!
つまりデータの半分以上が30kb以上の長さということ。
1セルあたりの塩基数は10Gb
リード数は40万本
いいですねえ、素晴らしい。

ロングリードのあちらの会社には負けてませんよ!


もうひとつのゲノム関連企業、Dovetail Genomics
こちらは新製品の発表です。
Dovetail Hi-Cキット
Hi-Cライブラリ作製キットです。
もうウェブサイトにも情報が載っているので見た方もいるでしょうか。
これは、1キット8本入りで、1本は3Gbまでのゲノムサイズに対応しています。
つまり5Gbのゲノムなら2本分が必要。3Gbゲノムサイズまでの生物なら1キットで8サンプル分が作れます。

ユーザはこのキットを使う前に、自分が読みたいゲノムのドラフトアセンブリを持っていることが条件です。
さらにそのアセンブリのコンティグ/スキャフォルドのN50 が1Mb を超えていることが必要です。
その理由は、Hi-Cで良い結果を出すためにはもともとのアセンブリのクオリティが良い必要があるからです。
そのクオリティ(N50=>1Mb)に達していない場合は、あらかじめPacBioでアセンブリしておくか、Chicagoを使ってアセンブリしておくか、いずれかが必要でしょう。

さて、Hi-CキットでHi-Cライブラリを作ったら、自分のところでシークエンスします。
HiSeqXで1レーンくらい読めば3Gb程度のゲノムなら事足ります。

読んだリードを自分のドラフトアセンブリと組み合わせてスキャフォルドするには、HiRiseというソフトウェアが必要です。
これを追加料金でDovetailにお願いするも良し、自分でやってみたい場合はDNANexusのクラウドパイプラインを使って無料で1回やるも良し。
このキットにはDNANexusのパイプラインで1回解析する分のライセンス料も含まれています。

現在はまだ、哺乳類でしか検証していないので他の生物種でうまくいくかは未確認ですが、いずれできるようになるでしょう。
そして4月以降のどこかで、植物用のキットも出る計画。
気になるお値段ですが、来週以降に決定する予定です。お楽しみに。

キットを販売すると言っても、今まで通り受託サービスも続けますから、全部お任せコースも維持します。
Dovetailは公平な目で見ても、今年のPAGで一番勢いのある会社と言っていいと思いますよ。

PAG XXVI 学会(その1)ゲノムシークエンスはPacBioとHi-CとBioNanoで決まり!

PAGは植物と動物のゲノム学会とだけあって、いろんな生物のゲノムシークエンスの発表があります。
今回ちょっと残念なのは、聞きたい発表が結構重なっていること。
でもPacBioが一般的に使われてきたせいかなーと思うことにしています。
PacBioのブース 
デザインの好みは分かれるか
昨年もそうでしたが、PacBio+Dovetail Chicago/Hi-C + BioNano
のどれかの組み合わせはゲノムシークエンスの発表で良ーく耳にします。
特に今回多かったのはPacBio+Hi-Cの組み合わせ。
Complex Genome Sequencingのセッションでは、クルミ、ココナッツ、ヒマワリ、ピーナッツ、とどれもPacBioが基本で補正的にHi-CとBioNanoを使っていました。

クルミ(ゲノムサイズ560Mb前後)の発表ではBioNanoを最初に使って物理マッピング地図を作っていました。(最初にBioNanoから行うゲノムプロジェクトは初めて聞いた!)
PacBioデータは47x でアセンブリ、N50=8Mbも得られたのは驚きですが、BioNanoの地図を加えて294本のスキャフォルド、N50=34.8Mbを達成したとのこと。

ココナッツはゲノムサイズが2Gb~2.6Gbと大きく、50xのイルミナデータでアセンブリ、15xのPacBioでギャップフィリング、DovetailのChicagoデータを足してスキャフォルディングという安全かつ簡単な方法を採用していました。
因みにココナッツは全世界の25%をフィリピンで生産しているらしく、一番の用途はコスメティクらしいです。へー意外。

ヒマワリはゲノムサイズ3.6Gbで、8kbと11kbのリピートが多くゲノムの33%を占めるらしいです。
102xのPacBioデータをFalconアセンブリして2.93Gb、N50=498kb、12,318本のコンティグを得たあと、こちらはBACデータにアラインしてPseudo chromosomeを作っていました。BACデータがあったからこそできた話ですね。

ピーナッツは1.25GbのAゲノムと1.4GbのBゲノムが2~300万年前にくっついて2.8GbのAABBとなったらしい。AとBは98%が同じ配列で64%がリピート、ATリッチという特徴があるそうです。
48xのPacBioデータをアセンブリしてコンティグN50=460kbを得た後、Hi-Cを行って、最後はイルミナリードでアセンブリエラー修正。
ピーナッツは染色体の端っこの方ではBゲノムがAゲノムになる傾向があるらしいです。


これとは別のセッションでも参考になる話が聞けたので少し。

キヌアゲノムは昨年Natureの論文で出ましたが、Kaniwa(カニューアと発音するらしい)という種を初めて聞きました。キヌアよりもタンパク質が多くて健康食らしいです。
ゲノムサイズは452Mbで、イルミナとHi-Cである程度スキャフォルディングまではできた。
これにPacBioデータを加えてギャップフィリングをするのですが、17xデータでやったけれど結構苦労したとのこと。やっぱり30xは欲しいと言っていました。
個人的には、Hi-CをするよりもChicagoを行った方がギャップフィリングの前のスキャフォルドの精度が上がったと思います。
または、最初からイルミナを使わずにPacBioで70xくらい読んで、それにHi-Cを加えるのが、お金があれば最適の方法でしょう。(←Sequelのランニングコストで考えるとPacBioのアセンブリもバカ高いわけではありません)

カベルネ・ソーヴィニョンもアップデートがありました。
以前ここでも紹介しましたが、ヘテロ性が高いのでFalcon Unzipのテストにも使われたこともあります。
これまではアセンブリしてN50が数Mbとかの話で終わっていましたが、その後BioNanoデータとDovetail Hi-Cを加えて、19本のPseudo Chromosome / allele まで完成させていました!
ほかにもIsoSeqを行い、672,000本の高精度アイソフォーム配列を得たそうです。
うち549遺伝子(585アイソフォーム)は、他の品種のゲノムにも転写産物データベースにもなかったとのこと。新規?

アセンブリにどれくらいのカバレッジが必要か問題についても少し議論があり、カベルネ・ソーヴィニョンの例では、「多ければ多いほど」良いとの結論でした。
つまり、カバレッジが多すぎてコンティグの長さが saturate してしまう、ということは無く、90xでも100xでも、多ければ多いほどアセンブリ結果は良くなる、というそうです。
とは言っても、100xの場合でもエラー補正に使われるリードがかなりありますし、カベルネ・ソーヴィニョンの場合はヘテロ性がとても高いので、ハプロタイプあたり50xと言えなくもないです。
そうするとヒトゲノムアセンブリで50x以上を推奨しているのとほとんど変わらない、かもしれませんね。


2017年11月20日月曜日

PacBioとナノポア 違いはここだ! (2017年版)

2017年は、PacBioにとってのライバル、オックスフォード・ナノポアテクノロジーズ(以下ONT)がいよいよ本格的に市場に登場、ロングリード業界に新たな風が生まれました。
(正確には、2016年でもMinIONを購入することはできましたが、誰でも手軽に買えるようになったという意味では2017年が国内リリースの年といっても良いでしょう)

そこで聞くのが、PacBioより長いリードが出てくるとか、バクテリアアセンブリにはONTだけで十分とか、ロングリードはナノポアに席巻されるのでは?という、PacBioに否定的な意見。
一方、ナノポアのデータはまだ精度が悪い、超ロングリードはエラーだらけ、ノートPCではランはできるけど解析はできない、というONTに否定的な意見も。

どちらもロングリードを謳っているだけあって、目的がデノボアセンブリやゲノム構造変異解析、16S解析など、ガチでぶつかるのは当たり前です。
では2017年11月の現時点で、このふたつの製品はどこがどう違うのか?

注!:皆さんご存じ、私はPacBio側の人間なので、これから書くことは多少ともPacBioバイアスがかかっています。そこを承知の上、お進みくださいね。


さて、PacBioとONT、現時点でどこがどう違うのか?

【テクノロジーの違い】単純にいうと
  • PacBio:DNAポリメラーゼがDNAを合成するときに、取り込む塩基に付加されている蛍光を、レーザーによって1塩基ずつ検出する。1つのウェルからは1本の配列データしか出力されない
  • ONT:DNAがナノサイズの穴を通るときに生じるわずかな電位差を検出し、アルゴリズムが塩基配列に変換する。1つのポアから複数本の配列データが出力される
つまり、
  • PacBio:DNA合成を伴う、蛍光色素を使う。レーザー励起エネルギー検出
  • ONT:DNA合成は行わない、蛍光色素は使わない。電位差検出
皆さんご存じの方も多いと思います。

【リード長はどうか?】
  • 平均リード長:PacBioもONTも同じくらい (10kb~20kb)
  • 最大リード長:PacBioは読むライブラリのサイズ、ムービー時間などで制限されるので60kb~100kb程度ではないかと思う。数百kbのリードは見たことが無い。一方ONTは、ポアを通るDNAが長ければ、最大1Mbのリードも出るそうだ
  • しかしリードの本数や分布には注意が必要。PacBioもONTも、短い(とはいっても数キロbpはあるが)リードは多く出力され、長いリードほど出力数は少なくなる。先のONTの超ロングリードも、出力本数でいうと数本
  • 因みにランタイムはPacBioのSequelが30分~10時間、ONTのMinIONが1分~48時間、だそうで。
数値についてはこちらを参照(オフィシャルな情報です)

で、精度はどうか?
生リードとコンセンサスリードで精度の意味は違う。
ここを一緒にして、「ロングリードは精度が悪い」という研究者のなんと多いことか!!

【生リードの精度】
  • PacBio:RSIIのP6C4ケミストリーや今のSequelは、平均86%
  • ONT:精度の数字はケミストリーのバージョンによって様々のようだけど、R9.2は平均80%~85%くらいか(違ってたらゴメン)。でも使うベースコーラーによって精度は変わってくるそうです。ベースコーラーは何種類かある
つまり、どちらも生リードの精度はほぼ同じ、ということになる。しかしもっと重要な点は、エラーの入り方。
【エラーの入り方】
  • PacBioはランダム
  • ONTはランダムという話も聞くが、実は決まった場所に必ずエラーが入るというユーザーのポスターも見るので本当のところはわからない
【コンセンサス配列の精度】
  • PacBio:エラーがランダムに入るので20~30カバレッジでQV50(99.999%)も可能
  • ONT:ONTだけのデータでQV50を達成している結果は私は聞いたことが無い。たいていイルミナデータをエラー補正に使っているようである
とまあ、ここまで読んで、いやそんなことは無い!と思った方もいるでしょう。
あくまでバイアスがかかった私見ですので。
この辺の技術の数字は、すぐに変わる可能性があります。少なくともPacBioは、来年データ量が増える予定なので。この辺はONTとの競争ですよ

【ベースコール】

  • PacBio:装置から出てくるデータは既にベースコール済み
  • ONT:ベースコーラーが数種類あるのでユーザが適切なものを使用してベースコールをかける必要がある

【PacBioしかできない解析】
  • CCS:ライブラリを1分子DNAの単位で何度も繰り返し読むことができ、精度を上げることが可能。Iso-Seq(完全長cDNAを高い精度で読む解析)ができる
【ONTしかできない解析】
  • ダイレクトRNAシークエンス? 今どこまで現実的に使えるのか、知っているひといたら教えてください
【PacBioでもONTでもできる解析】
これはいつくかリストした後に考えてやっぱり消しました。というのは、「できる」という言葉の定義がひとによってさまざまだから。
バクテリアのゲノムアセンブリができる、と言っても、精度99.99%以上でできるというのと、ラフなドラフトでいいからできる、というのとでは全然違う。
HLAなどのロングアンプリコンシークエンスもそうです。求められる精度が6桁なのか8桁なのかで同じく「できる」というべきか。
あと、メチレーションや16SなどでもONTのデータを私は知らないのでできると言うのはやめました。
あと、意外と知られていないことですが、ノートPCにUSB挿してランができるMinIONも、データ解析には普通のサーバが必要です。

それでは技術以外の、それぞれの特徴を考えてみましょう!

【PacBioの特徴】

  • 装置型なのでシークエンスを行う環境が安定している
  • 実験プロトコルが用意されている
  • 解析パイプライン(マッパーやアセンブラ)がほぼ確立されている。これを使っておけば大丈夫的なツールがある
  • グローバルに数百台入っていて、国際プロジェクトにも正式採用されている(例えばG10K(脊椎動物のゲノムプロジェクト)ではPacBio、10XGenomics、Hi-Cのみが正式採用)ので信頼が高い
  • PacBioを使った研究の論文数、学会でのポスター数は圧倒的にONTのそれより多い(これは先行者だからかもしれません。来年が勝負の年かも)
【ONTの特徴】
  • MinIONはコンパクトで持ち運べる
  • 初期投資額が少なくて済む
  • 誰でもどこでもいつでもシークエンス、を謳っているが、「どこでも」シークエンスをするとデータにバラつきが出やしないか?(逆に、誰がどこでランしても一定のデータが出てくるなら凄い)
  • ユーザーコミュニティの中からプロトコルや解析ツールが作られる、ボトムアップなイメージ。NGSは昔からサードパーティのツールがユーザーから作られるものだが、ONTはよりその傾向が強いように感じる
  • バージョンアップのスピードが速い。PacBioもそこそこ速いけれどONTはもっと速いイメージ


と、つれづれなるままに書いてみましたが、いかがでしょうか?
結局はコストだと言われるかもしれませんが、シンプルにランニングコストで比較すればPacBioも負けていませんよ。アプリケーションによっては。

結論!
PacBioやONTのどちらも持っていない場合:

  • どうしても自分でランしたくて、ユーザーコミュニティでどんどん聞いて行くのが好きで、インフォマティクスにも強ければONT(ベースコールも何種類かあるのをお忘れなく)
  • 自分でランすることにはこだわらず、安定したデータを早く出したい、インフォを誰かに頼めるか自分でできれば、受託か共同研究でPacBio
  • 限られた予算を無駄なく効果的に使いたければ・・・ (答:     )

PacBioを持っている場合:
迷わずPacBio(笑) これ一本!

以上、2017年11月現在の私の意見でした。

2017年11月4日土曜日

増幅無しのターゲットエンリッチメントはCas9を使え!

先月10月のASHGはフロリダ州オーランドでした。
成田からシカゴへ行く飛行機の中、偶然にも隣に座ったひとが、このブログを学生時代から読んでました、というかたでビックリ!
こんなこともあるんだな~、と思いましたね。

いまさら学会報告もあれですが、PacBioのワークショップのビデオ、ポスター、プレゼンテーションが昨日ウェブに公開されたのでお知らせします。

PacBioは今年のASHGで、構造変異解析を前面に持っていきました。
構造変異というのはいわゆるSNV解析よりも大きな、数百塩基やそれ以上の、挿入・欠損・Inversionなどの変異です。
また、リピート配列というのも疾患に関連する変異のひとつです。


ASHGの展示会場にて、CoLabというコーナーがあり、そこで企業がセッションをしていました。分生なんかでも良く見る、あれです。
ここでも紹介されているCRISPR/Cas9 Targeting、これはCas9を応用した増幅無しのターゲットエンリッチメントです。
上のウェブページはこちら

なぜ増幅無しのターゲットエンリッチメントが注目されているかというと、増幅できない配列をエンリッチできるからです。

は、はい。 

という声が聞こえてきそうですが、例えばハンチントン病やある精神神経疾患などでは、CGGやCAGといった3塩基が何十回、何百回も繰り返して、その繰り返しの量で病状が変わることが知られています。


CGGのリピートだと、CGGCGGCGGCGGCGGCGGCGG・・・になるのでもちろんPCRがかからない。

このような配列をエンリッチするには、増幅を介するハイブリベースでは難しい。そこでCas9エンリッチの登場!

ゲノム配列を制限酵素を使って切り、スマートベルを作製し、ベルの中のターゲットとする配列をCas9で切断、切断されたライブラリには第二ヘアピンアダプターをつける。
第二ヘアピンアダプターはほかのペアピンアダプターとは配列が違い、その配列のついたスマートベルだけをビーズで回収する。 
文章に書くとこんな感じです。
スライドはこちらにありますので興味ある方はどうぞ。

Cas9エンリッチメントを行うと

  • PCRバイアスやエラーを防ぐことができる
  • 一塩基レベルの精度でリピート配列全体をカバーできる
  • リピート配列の数を計測できる
  • 違う配列がリピート配列の中に混じっている場合もそれを検出できる
  • リピート配列の体細胞モザイシズムも見ることができる

こちらCas9エンリッチメントは先日論文が公開されました

このCas9エンリッチメントですが、正式プロトコルは来年早々リリースされる予定です。
こうご期待!

2017年10月4日水曜日

ASHG2017でのイベント情報

すっかり涼しくなってきたな~と思えるときもある10月。
10月と言えばアメリカ人類遺伝学会(ASHG)。
毎年恒例で多くの日本人研究者も集まりますが、今年は特に多い。
場所がフロリダ州オーランドだからでしょうか?

ということで、PacBioのイベント情報をお知らせします。
ASHG学会に行く人も行かないひともぜひチェック!

このページ行けば全部書いてあるんですけど、まとめますね。

ワークショップは10/18(水)の現地時間12時半から
テーマはヒトゲノム構造解析
Cas9を使った配列特異的ターゲットシークエンスを使って脊髄小脳失調症タイプ10のメカニズム解明に挑む例や、大きなゲノム構造変異と知的障害の関係性の研究、1000人ゲノムプロジェクトの最新情報など。
特に1000人ゲノムの発表は、今年HUGOのPresidentでもあるDr. Charles Leeです!
参加はこちらから、学会には行けないけど後で講演を聞きたい!というひとも、レジストして
Not attending. Send the recording
を選択すればOKですよ! (もちろん参加したひとにも録画のリンクが送られてきます)

それ以外の注目イベントはこれ!

10/19 11:00 am-12:30 pmの Concurrent Platform Session “Advances in the Genetics of Autoimmune Disease,”では、“The MHC Diversity in Africa Resource: A roadmap to understanding HLA diversity in Africa,”(Martin Pollard of the Wellcome Trust Sanger Institute)というタイトルの発表があります。PacBioを使ったMHCシークエンスの実例が示されるそうです。

同日午後4:15-6:15の Concurrent Invited Session “Analysis of Cancer Genome Variation Using Long-read Sequencing”では、Dr. Fritz Sedlazeck (Baylor College of Medicine)、Dr. Jacques Banchereau (Jackson Labs for Genomic Medicine) らによるガンゲノムへのPacBioの応用例がこれでもか!と発表される予感。

Dr. Xufeng Zhao、Dr. Mark Chaissonらは、the Human Genome Structural Variation Consortiumを代表して, “Comprehensive Discovery of Structural Genomic Variants Through Integration of Multiple Sequencing Platforms,” というタイトルのポスターを18日の 午後2:00-3:00 のポスターセッションで発表するそうです (Poster #1501).
彼らは最近、3組のトリオの全ゲノムをPacBioで読んで解析し、1000 Genome Projectのショートリードデータ解析よりも10倍以上の構造変異を見つけたとして bioRxiv に発表。この論文はチェックしているかたも多いでしょう。

PacBio社からの注目は、Tyson Clark が “Targeted Enrichment Without Amplification and SMRT Sequencing of Repeat-expansion Disease Causative Genomic Regions” というポスターを18日の 3:00-4:00 pm で発表します。
これが例のCas9ターゲットです!(Poster #1480).

さらにさらに、初日17日(火)の午後1時から4時にあるGenome Reference Consortium (GRC) & Genome in a Bottle consortium (GIAB) Workshop も見逃せませんよ。
ヒトゲノムリファレンスのアップデートが話し合われるとても面白いワークショップです!PacBioのロングリードも大活躍しています。

と、いろいろ書きましたがプレスリリースにも書いてありますので時間がある方はどうぞ。
PacBio関連のプレゼンだけで約30もあるそうです! 全部をフォローするのは難しいけれどできるだけ聞いてきます。


2017年9月5日火曜日

Iso-Seq:Sequelでの実力はどれくらいか?


以前、こちらやこちらのブログで、「言葉を覚える鳥」ゲノムのことを書きました。
ゲノムを読んだら次は遺伝子発現、ということで、Iso-Seq(完全長cDNAのシークエンス)をやった結果のデータが公式にアップされました。

PacBio公式ブログでの記事はこちら

ポスターはこちらからダウンロードできます。
出たばかりのSMRT Link v5 を使っていたようですね。

データ出力のところを注目してみましょう。
SMRT Cellは4個使っています。
セルごとにバーコードで2種の鳥のサンプルを読んでいます。
Cellあたりの出力塩基数は6.1Gbから7.7Gb、ポリメラーゼリード長のN50はなんと32kb~38kb!
どうです? いや、長さが全てだとは言いません。でもPacBioでもこんなに長いリードが出るんです。
冗談はさておき、サブリードのN50 も5kb台です。十分転写産物をカバーできていると言えるでしょう。

ポスターを見ると、High QualityのIsoformは、Zebra Finchもハチドリも、それぞれおよそ17,000本を得ています。
これは偶然でしょうか? (いいえ)

2種類のサンプル(AとB)を4セルで読むとき、Aを2セル、Bを2セル、というシークエンス方法もあります。
今回はわざわざバーコードを付けて、ABを後から区別できるようにし、2つを混ぜてから4セルで読んでいます。
こうすることで1セルに2種類のサンプルが均等に読まれることになります。
結果、異なるセル間の出力のばらつきがたとえあったとしても、A、Bそれぞれの4セル分のリード数は同じようになると期待できますよね。
これもSequelになって出力が増えたおかげかな?

さて、この解析のところでIso-Seq2もしくはToFU2というのが出てきますが、これはまだ開発版でサポート外です。
今までのIso-Seqとどう違うかというと、主に解析パフォーマンスを上げるためのバージョンアップになります。
SGEを使うのがオプションになったり、クラスターを作るところでBLASRとDALIGNERのどちらかを選べたりします。
Sequelになってデータ量が増えた分、Iso-Seqの解析時間がかかり過ぎていた問題点を、これで改善する目的で作られました。
詳しくはこちらのPDFをご覧あれ
ToFU2: Design Overview より


2017年8月14日月曜日

動物でもゲノムサイズって様々ですね & PacBioセミナー録画

お盆休み。日本民族大移動。おかげで都内は空いてて快適!
今年は東京はあまり暑くないな、と軽く思っていたら、湿度が高いせいでしょうね、危うく熱中症になりかけました。
公園で2時間近くもフリスビーやっていたらそうなるか。

休み中のひとも多いと思うので、軽い話題。
哺乳類のゲノムサイズ、ってどれもヒトと同じくらいって思っていませんか?
私もちょっと前まで、哺乳類は大体3Gb って思っていたのですがとんでもない!
先月のDovetailのユーザーミーティングでリスを読んでいたひとは、ある種のリスのゲノムサイズは6Gbあるって言っていました。

この絵はSNSで見つけました。ゲノムサイズの面白い示し方ですよね。
プレゼンのネタの参考になります。

それにしても、ゲノムサイズが体のサイズに比例しないのは不思議です。
哺乳類じゃないけど、バッタが7Gb以上もあるなんて。
それに比べると、ハチドリは1Gbちょっとなんですね。あんなに激しく羽を動かす鳥なのでエネルギー相当使ってそう。でもゲノムサイズは小さい。

ゾウがヒトより大きいのは何となくわかる。耳と鼻が大きいから(笑)
タコがもっと大きいのは足が8本もあるから(笑笑)
(じゃあイカはどうなんだ? ムカデは?)

ゲノムサイズが大きいと、物理的に大きな核が必要になりますよね。細胞分裂で染色体全部がきちんと分かれてくれない可能性も高い(一部の植物やアメーバなどでは、きちんと染色体がわかれなくても生きていけるものもあるそうですが)。分裂にエネルギーをたくさん使いそう。
そんなリスクがあっても、大きなゲノムサイズを維持するにはやはりそれなりの理由があるのでしょうね。


話題代わって以前、アメリカ東海岸でユーザーミーティングがありました。
そこで使用されたスライドや、一部録画が公開されたのでお知らせします!

この録画は、PacBioのSarahが、二倍体のアセンブリについて、Falconアセンブリのアルゴリズムからアセンブリの評価方法、NCBIへの登録方法について喋ったものです。
こちらから見ることができるのでどうぞ。

スライドはこちらにUpされていますのでご自由にどうぞ。

2017年8月4日金曜日

PacBio 2017年後半戦が見通し明るいそのわけとは?

これを書いている今日は8月4日、昨日のPacBioの株価は前日比で14%も上昇しました。
こういう時は何かニュースがあったのでとりあえず本社のサイトやSNSをチェック!

アメリカ時間で8月2日に第二四半期の発表がありました。
CEO自らが投資家向けにプレゼンする場で、これは録音されて、翌日には誰でも聞くことができます。 一応、視聴するには登録が必要

数字については、私はその辺(アメリカ企業の経営に関する数字)は詳しく無いので評価できません。
でも、悲観的か楽観的かというと、明らかに楽観的な見通しでした。
このプレゼン時間の半分以上が投資家からの質疑応答になるのですが、厳しくは無かったです。

で、良いニュース(これが今回の株価14%UPにつながっているかは不明)はこちらです。

  • 装置の売り上げは顧客のバジェットタイミングによるので不安定だが、試薬売り上げはSequel台数が増えるにしたがって着実に増えている
  • 中国のNovogeneがSequelを10台追加で注文(これで20台購入!)するなど、中国の売り上げが堅調
  • Sequelの新ソフトウェア version 5 のアップデートが始まり、テストデータはとても良い
全世界でRSIIとSequelを合わせると、現在300台以上が導入されています。
この数字は5月のものなので、最新ではもっと行っているはず。
装置が増えればそれに伴い試薬の購入も増えるわけですが、この傾向はシークエンスラボで顕著だそうです。

どういうことかというと、一般のアカデミアは、プロジェクト単位でシークエンスが行われるので、プロジェクトが終わると一息つくことが多いですね。
日本以外でもこれは同じで、プロジェクトごとに予算が付く。そうすると、それが終わったとたんにシークエンスしなくなる。

ところが、営利企業やシークエンスコアラボでは、ひとつのプロジェクトに左右されないので通年シークエンスされるとのこと。
日本でもまあ、そんな感じでしょうか。年度末は忙しい、というバラつきは多少あるでしょうが。

中国のNovogeneという会社、これは世界最大のシークエンスラボのひとつです。
ここ2年くらいで、PacBioの最大の顧客になりました。
Sequelを10台保有し、さらにこの度もう10台の購入を決定! 世界一、Sequelを保有する機関になりました。
彼らがなんでこんなに(20台も)Sequelを買ったのかというと、ロングリードに積極的に投資しているからです。ちなみにここには政府系の投資会社もお金を出しているそうです。
Novogeneでは、中国人ゲノムを1000人分読み、構造変異を解析し、世界初の構造変異データベースを完成させる、という壮大な計画があります。
ここに、Sequelが使われるのです。
さらに、Novogeneはシークエンス受託解析企業なので、世界中から顧客を集め、世界一のシークエンス受託会社になることを目指しています。
そんなこんなで今、PacBioのRevenueの25%は中国から得ているそうです。

中国だけでなく、世界の営利企業は積極的にSequelに投資する傾向にあるそうです。

HistogeneticsというアメリカのHLAタイピング企業は、ショートリード数十台に加えてRSIIが動いています。もちろんSequelも。
これは、HLA遺伝子の完全シークエンス(ショートリードでどうしても型が判定できないような難しいローカスのシークエンス)のためにPacBioのロングリードが絶対必要だ!ということで、アグレッシブにRSII、Sequelが使われているそうです。


これらの発表がもしかすると、昨日の株価14%アップに影響したのかな?

PacBioは、先月Sequel用に、これは解析ソフトと装置のソフトの両方で新しいソフトウェアをリリースしました。
昨日のCEOのプレゼンでは、このソフトが順調に動いていて、ある顧客では平均リード長33kb、またある顧客では1セルあたりの出力が15Gbに達したと言っていました。
まあ、これは極端な例でしょう。
実際は、良くて平均12kb、N50 で20kb、塩基出力も良くて10Gb くらいかな、という感じです。
でも2017年の末には、わかりませんよ。

CEOははっきり言っていました。
2018年末までには、今の8倍のウェルを持ったセルが登場し、新試薬などで今よりスループットが30倍Upすると。

2017年1月22日日曜日

PAG報告 パート2 NovogeneがSequel10台購入!

PAG学会の2日目、日曜に大きなニュースが飛び込んできました。
中国のシークエンスサービスプロバイダー・Novogene社が、Sequelをなんと10台購入するらしいと!
この日の朝、私がホテルを出る前に、ロビーの奥でPacBioの重役とNovogeneの偉いひとっぽい方たちが一緒に朝食を取っていたのですが、最終的な詰めをしていたんでしょうか。
この話は、翌日正式に一般に発表され、世間を驚かすことになりました。

写真はイメージです
Novogene社は世界各地に研究所を持っていて、10台のSequelは一箇所に集まるのではなく、複数の研究所に分散してインストールされる予定です。でも、ひとつの機関が10台も所有するなんて、本当にチャイニーズマネー恐るべしです!

これほどの資金を持っているNovogeneなら、イルミナの最新シークエンサーNovaSeq6000も、結構な数で購入するかも。
ちなみにNovaSeq6000は、装置自体は結構大きくて、横幅はSequelと同じか若干大きかった。
高さはSequelより低いかな。でももはや床置きタイプになってしまった。
スループットは最大4フローセルで6T塩基(2x 150 bp)。フローセルあたりのリード数は最大100億本! HiSeq Xの3倍ですよ。
ここから先は、イルミナ社の方に聞いてくださいね。

Sequelの話に戻ると、この装置を使った発表も増えてきました。
これからの発表には少しずつ、RSIIからSequelを使ったゲノムシークエンス、Iso-Seqなどの結果が増えてくる気がしました。

PacBioからのポスターはこちら

2017年1月13日金曜日

Sequel 新試薬登場でスループット向上!


もうアナウンスされましたが、PacBioのJPMネタは、「Sequelの試薬・ケミストリー・ソフトウェアのバージョンアップによってスループットがすごくUP!」です。

カタログもそれにあわせて改訂されました。ここからダウンロードできます。
6ページ目に注目!
これが今のSequelのスループットだ!!

これはあくまでゲノムアセンブリ用の長ーいライブラリ(例えば60kbとか)を読んだ場合です。サイズセレクションは30kbでしています(つまりライブラリは30kb以上の長さ)。
これを2.0ケミストリーで10時間(!)読んでいます。
セルあたりの出力リード数は365,000本で、うち半分のリードの長さは20kb以上。
この図では出力塩基数が 7.5 Gbです。バラツキはありますが5Gb ~8Gbというところでしょうか。

試薬のバージョンが2.0とか、ソフトウェアのバージョンが4.0とか、実際使っているユーザ以外にはどうでもいい数字だと思いますが、重要な点は、
  • 少ない量のライブラリからシークエンスできるようになった
  • 長ーいライブラリもローディングできるようになった
  • ラン時間が最大10時間までできるようになった
  • ベールコールアルゴリズムが改善された (精度がUp)
  • 短いライブラリでのシークエンス結果が改善された

という感じです。

ゲノムアセンブリにはできるだけ長ーいライブラリを作ることが重要です。
一方、構造解析などでは30kbとか40kbとかの長いものを作る必要はなく(もちろん目的によりますが)、10kb程度のライブラリでも十分解析できるのでは?というのが今のところのPacBio社内で一致した意見です。
ヒトゲノムのほとんどの構造変異は、Segmental Duplicationなどを除けば、だいたいは10kb程度に収まるのでは無いか?
もちろんお金とサンプルが潤沢にあれば、長いライブラリを作って読んだほうが、より多くのゲノム構造解析を検出できるでしょう。
でも現実的には、コストと検出感度・精度はトレードオフの関係にあります。
検体数にもよりますしね。
リードが長くなったおかげで、検出できる構造変異の数で見ると、新試薬の方が従来試薬の半分のコストで解析できるそうです。
コスト表を改訂しなきゃ。

2016年12月31日土曜日

今年最後は・・・Quiver と Arrowの話 我ながら地味

2016年、大晦日です。
紅白見ながら書いてます。PPAP、ゴジラ、真田丸、ブラタモリ。
今年は面白いな。

さて今年最後の投稿は、地味なネタです。
QuiverとArrowの違いであまり知られていないこと
GitHubのサイトでもあまり詳しくは説明されていないので、少しお話しします。

【はじめに】
QuiverとArrowは、どちらも、CCS(Circular Consensus Sequence)を作るアルゴリズムに由来します。
QuiverはRSIIのデータ用、ArrowはSequelのデータ用の、コンセンサス配列作製アルゴリズムです。
SMRT Analysis v2.3 まではQuiverが標準搭載されていて、v3.x からはArrowになりました。
v3.xは、SMRT Linkというパッケージソフトになったのですが、引き続きSMRT Analysisという名前も解析用ソフトとして使われています。
SMRT LinkでもP6-C4のRSIIのデータは解析できるよう、Arrowも対応されました。

【QuiverよりArrowの方が精度が高い】
CCSを作るとき、Quiverベースのアルゴリズムでは、何回パスを重ねても平均QVフレッドスコア30くらいで精度に限界がありました。
また、ホモポリマーもうまく認識できないという欠点もあったそうです。
これは様々なクオリティ値を使ったエラーモデルが複雑すぎて余計ノイズになったとか。
そこで開発されたのがArrowというアルゴリズム。
トレーニングモデルやエラーモデルをより単純にし、またZMWごとの違いを考慮するようにした。(2016年アジアユーザグループミーティングより)

Arrowを使ったCCSは、パスを増やすとQVをフレッドスコア50、60に高めることが可能になりました。
Old = Quiver, New = Arrow

【QuiverよりArrowの方が使っているQV値は少ない】
普通、シークエンサーから出力されるリードの塩基には、その塩基をその塩基であろうとしたクオリティ値(QV)があります。
つまりAである塩基をAとコールしたとき、Cではなく、Gでもなく、Tでもなく、Aであったという「確からしさ」を表現する方法として、QVがあります。

RSIIは、ベースコールの結果、各塩基ごとのQVのほかに詳細QV (DeletionQV, InsertionQV, SubstitutionQV, SubstitutionTag, DeletionTag)という複数のQVを出力し、Quiverはこれらの情報も利用してコンセンサス配列を補正します。

Sequelは、これら詳細QVは出力せず、各塩基ごとの全体のQV(QUAL/FASTQ qv)のみを出力します。
(実データを見たことがあるかたは、現在のSequelリード BAMファイルではQVの情報が全て「!」になっているのに驚くかもしれません。この問題は次バージョンで改善される予定です)
ですがArrowではそもそも、塩基ごとのQVを使用しません!

ではArrowは何のデータをもとにエラー補正&コンセンサス作製をするのでしょう?
Arrowは、

  1. 各リードのシグナルノイズ比
  2. 各塩基のパルス幅の情報

この2つを使用して、マッピング後のコンセンサス配列を補正して作ります。
これらの情報は今もリードBAMファイルに記載が有ります。

P6-C4のRSIIデータも、Arrowを使えます。
このときは、RSIIデータ(bax.h5)をSequelのBamファイルに変換し、リードごとのSN比と各塩基のパルス幅情報を使って、Arrowが使われます。
結局、補正に使うデータを単純にしたほうが精度が上がったということでしょう。

今後、Arrowで塩基ごとのQV(詳細QVではなく、全体のQV)が使われるようになるかは、現在のところ何ともいえません。
精度が向上するようであれば、使われるようになる可能性はあります。


ああー、もうすぐ2016年も終わります。
しかし笑ったのは、白組の方がダントツで票が入ったのに何故か赤組が勝った、というアメリカ大統領選挙よりも摩訶不思議な紅白歌合戦。
明日の新聞で説明あるかな?

また来年も宜しくお願いしまーす!
2月7日の「PacBioセミナー@秋葉原」も宜しく

2016年12月13日火曜日

2017年もやります! PacBioセミナー@秋葉原

12月も中旬になると、東京も急に寒くなってきました。
毎年、分生が終わったこの時期は、忙しいはずなんだけど・・・「今年も良く働いた!」というへんな達成感がある。あとは飲み会?Year End Party

さて、来年ですが、2月7日(火)に、また秋葉原UDXで「PacBioセミナー」やります。
今回は午後からの半日セミナー。
なぜ午後からかというと、朝から5時まででは長い!という意見が前回あったから。
そこで今回は1時から5時までで、英語での発表はひとつ、PacBio本社からのみ。

NGS現場の会のメーリスにも流しましたが、
今回の名前はシンプルに「PacBioセミナー」。
なぜ「PacBio現場の会」にしなかったかというと
  1. 同じ年にNGS現場の会があるので、社内で「現場の会の準備」と言っとき、「え?どっちの?」とややこしいから
  2. お客さんに紹介したとき、「え?どっちの?」とややこしいから

いう理由でした。

PacBioセミナー 2017
ロングリードが世界を変えた!

【日時】
2017年2月7日(火)
午後1時スタート(受付開始は12時30分~)
午後5時半頃終了予定(その後懇親会あり)
参加料金は無料! 

【場所】
秋葉原UDX

【事前登録制】
ここからかならず登録してくださいね(そのページの一番下に入り口あります)

日本にPacBioが導入されてからまもなく6年目を迎えます。(ということは私も今の仕事してから6年目ということか・・・)
バクテリアゲノムから大型真核生物ゲノムまで、様々なところでSMRTテクノロジーのスーパーロングリードは活躍してきました。今回は、ヒトゲノム、植物ゲノム、そして新型機Sequelにフォーカスしたセミナーを行ないます。もちろん、そのほかのアプリケーションやバクテリアゲノムも忘れません!

今回も、豪華な演者の先生方をお招きします。
  • 芦澤哲夫先生(Houston Methodist Neurology, Director);ショートタンデム反復の拡張と神経遺伝疾患との関連性の研究がご専門。米国NIHの組織するSCAコンソーシアムのリーダー
  • 安田純先生(東北大学 東北メディカル・メガバンク機構 教授);日本人基準ゲノム配列(JRG)をPacBioを用いて決定。このプロジェクトの中心メンバー
  • 榊原康文先生(慶應義塾大学理工学部生命情報学科 教授);11月にNature Communicationsに発表され注目を浴びたアサガオゲノム。その解析チームリーダーでバイオインフォマティクスがご専門
  • 豊田敦先生(情報・システム研究機構 国立遺伝学研究所 特任教授);ゲノム支援・先進ゲノム支援の枠組みの中でPacBio RSIIを様々なプロジェクトに活用され、日本で最もPacBioを使われているユーザのおひとり
  • ほか交渉中演者数名

PacBio本社からは、アメリカでのPacBio応用例をご紹介します(Luke Hickey, PacBio)。
さらに、PacBioアプリケーションアップデートの発表や、今話題のDovetail Genomics(ゲノムアセンブリ専門の受託サービス)、Swift Biosciences(少量DNAからのショートリードライブラリ作製キット)の紹介、NGS関連商品の紹介などもする予定です。

今回もPacBioに興味のある現場の方や、ロングリードの可能性に期待する先生方が一同に集まる貴重な場になると思います。
是非この機会にご参加下さい。

しつこいですが事前登録制です。
このページの一番下から、Googleフォームへのリンクへ行って、レジストしてください。
入り口がわからない方は、ここから直接どうぞ

懇親会は、会場近場で18:00から予定しています。

是非こちらもご参加下さい。.

タイトル、アブストなどが決まり次第、またお知らせします。

来年は、手のひらサイズシークエンサーが話題になりそうですが、PacBioはまだまだ負けてませんよ!
ランニングコスト、データ量、精度、供給安定性、サイエンスとしてのデータ、いずれも客観的に見てPacBioの方が上回っている、ということをこれからもお示ししていきます!

なーんて、大きなこと言ってますが、アレですね、市場が活性化するのはいいことです。
同じロングリード同士、競いながらもうまく住み分け、するのかな。
これについてはまたの機会にしっかり書きます。
では

2016年11月23日水曜日

IGVでの格好いい見せ方の、もとデータ

前回、IGVでPacBioを格好良く見せる方法を紹介しました。
その時例に使ったデータは何かと言うと、Sequelでヒトゲノム NA12878 を10xくらいの深度で読んだものです。
具体的には、ここのデータ
ライブラリの長さは25kb、Blue Pippinを使って15kbにサイズセレクション

  • 使用したSMRT Cell 1M の数:10
  • トータルラン時間:60時間
  • 出力塩基数:32.8 Gb
  • リード数:340万本
  • リード長のN50 :11.823 bp

このとき使用した試薬は、旧バージョン、v.1.2 のもの
なので今ならセルあたりの出力はもっと多いはず。

とにかくこれでヒトゲノムの10倍のデータが出た。

このデータをヒトゲノムにマップするのですが、ここで使ったツールは、NGM-LR + PBHoney
PBHoneyは構造変異を検出するツールです。

NGM-LR って何? という方、これはロングリード用のマッピングツールです。
Next-Gen Mapping tool for Long Read、だったかな?何かそんな名前。
Githubにもあるので、興味のある方はここからどうぞ。

PacBioリードは1本が長いので、例えば 1kb 程度の挿入・欠損をまたいで読むことが可能。
しかし通常のマッパーでは 1kb の変異を考慮してほかの配列を綺麗にゲノムにマップすることができなかった。NGM-LRは、二箇所に分かれてマップするような、ロングリード独特な性質をフルに発揮できるマッピングツール。
BWAとNGM-LRのマッピング結果 Aaronのスライドより
さて、こうしてマッピングした結果は、もちろん参照できます。

先ず、DNAnexusのデモアカウントと作りましょう!
いえいえ、決して私はDNAnexusの手先ではありません。
仕方無いんです。ここにアクセスした方が、データ参照が楽だから。

私はアカウント持っているのですが、ロングインするとこんな感じです。

左下の、"PacBio Sequel Data" というところをクリックします。
これが例の10カバレッジのSequelデータ
"Sequel Data" を開きます
NA12878.reads.ngm.bamというファイルが、マッピングファイルですが、20Gbもあって大きいです。
そこで、indexsession ファイルをダウンロードします。
これは、IGVに取り込むと、DNAnexusのサーバにアクセスしてデータを表示してくれるインデックスファイルです。
IGVはこのように、必ずしもローカルに大きなサイズのマッピングファイルを持っておく必要がありません。

さ、IGV を開きましょう。前回のあれ、ですよ。わからないひとはちょうどこの前の記事をチェック!
ゲノム配列が "Human hg19" であることをチェックして(違ったら Human hg19 を選ぶ)

File > Open Sessions 
今ダウンロードした indexsession ファイルを選択。
何か聞かれるけどOKをする。
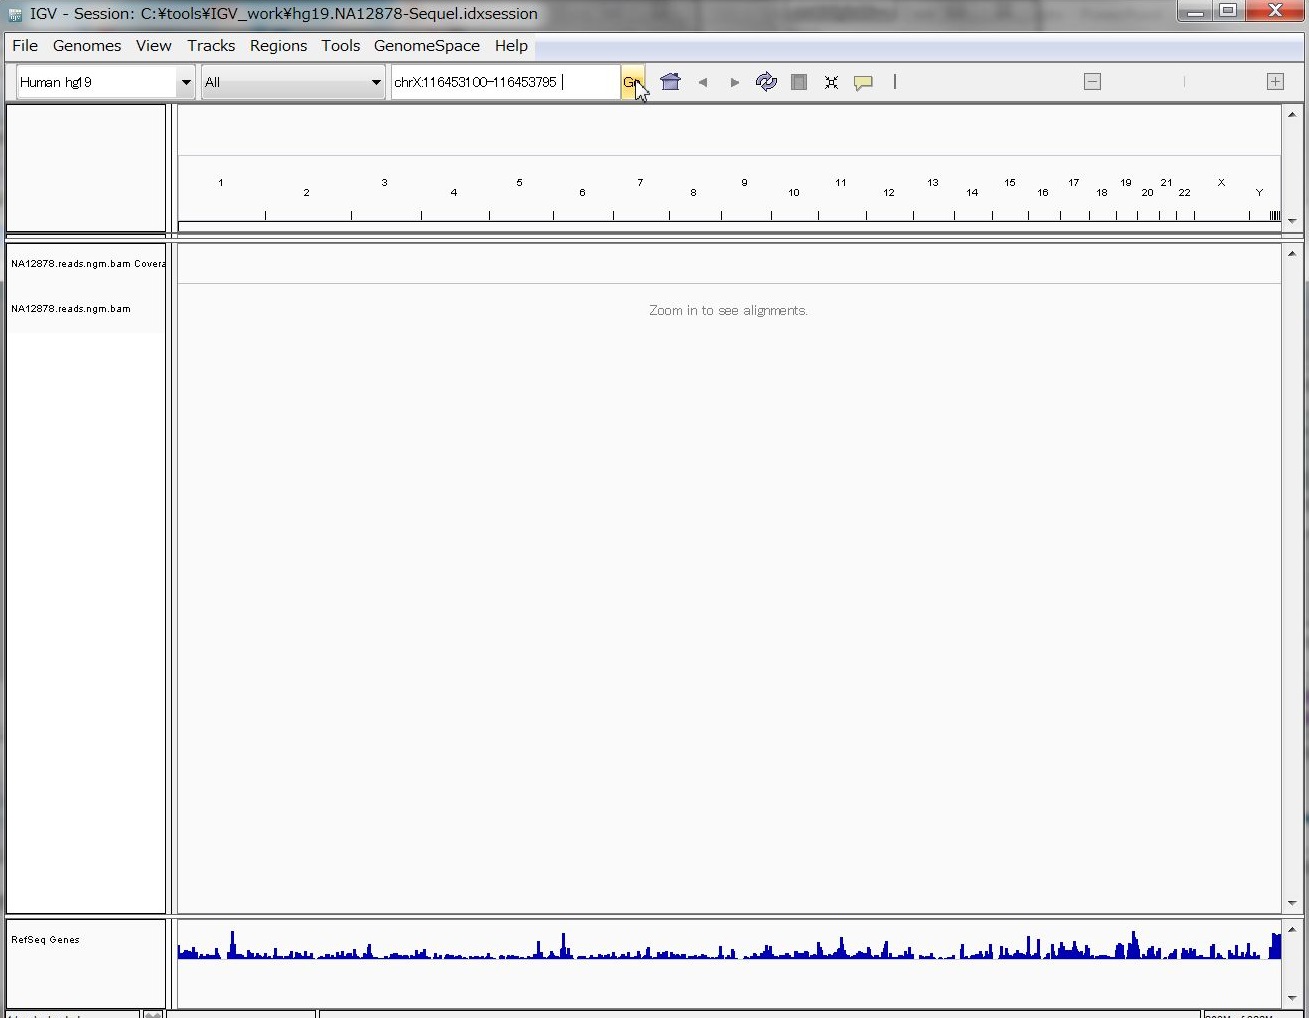
ゲノムのポジションを入力する場所に、試しに、
chrX:116453100-116453795
と入れてGo!
いぇーーーーい !!

ほかにもチラッと見てみたいポジションは、こんなところかな?
chrX:116454160-116454859
chr10:92213800-92216245

InDelの変異箇所は、先の DNAnexusのアカウントから、
NA12978_Output を選び、ここから ... del.bed  ins.bed ファイルをダウンロードしてきて、取り込むと面白いかも!

いかがだったでしょうか?