ラベル 実験 の投稿を表示しています。 すべての投稿を表示

2017年3月6日月曜日

サイズセレクション無しのISO-SEQ Sequel向け


Iso-Seqというのはアイソフォームシークエンス。
数年前から(もちろんそのときはRSIIで)、完全長 cRNAをシークエンスすることで、スプライシングのバリエーションを一気に、連続配列情報として得ることが出来る。
これがIso-Seq です。
最近ではここに書きました
Iso-Seq アイソフォームシークエンスアップデート 植物

RSIIでのIso-Seqは、サイズセレクションといって、1kb、2kb、3kbなど、サイズごとに分けてライブラリを作製、別々のセルでシークエンスしていました。
と・こ・ろ・が・!


このたび正式にリリースされたSequel用のプロトコルでは、サイズセレクションしません。
というのも、Sequel用のケミストリーでは、ローディングバイアス(短いライブラリが優先的にZMWに入る、というバイアス)が、あまり影響しないらしいことが経験的にわかってきたからです。
RSIIとSequel、サイズセレクション無しのとき
Sequelのランはバイオアナライザで測ったときの波形に似ている

サイズセレクションせずに、Iso-Seqの同じライブラリをRSIIとSequelでランしたとき、RSIIは1kb程度のフラグメントがもっとも多く検出されます。
でも、Sequelでランすると2kbあたりに最頻値が現れる。
これはバイオアナライザで測ったときの形に似ているぞ。
ちなみにAMPureは1Xで行なっています。

というわけですが、マグビーズは推奨されています。
また、4kb以上の長い転写産物の出力を増やしたい場合は、4.5kb以上でサイズセレクションをしたほうが良いらしいです

そのたの目新しいこと・・・

  • AMPure精製は、0.40Xと1Xの2通り別々に行い、あとでモル比を合わせて混ぜます
  • PrimeSTAR GXLポリメラーゼを長鎖PCRに使います
  • P1を50%目指します(50%のZMWから使えるデータを出す)
  • 6時間Movieまたは10時間Movieで読みます(時間かかっても精度良いデータをたくさん出したければ10時間)
  • Movieをとる前に2時間シークエンスさせます(Pre-extensionと呼ぶ)
このような変更点があって、プロトコルもだいぶ変わりました。

Sequel では、RSIIで複数個のセルを使っていたIsoSeqが、1個か2個のセルで可能になりました。
今度のAACR(4/1~5)で発表があるかな。
注目してます。


Iso-Seqの新しいプロトコルはこちらから!


2017年2月23日木曜日

バクテリアマルチプレックスシークエンス


Sequel のスループットは、RSII より多いです。
Movie時間やライブラリの種類によって変わりますが、一般的にRSIIでも1セルあたり550Mb~1Gb のデータは出てきます。
一方Sequelは、3Gb~7Gb のデータが出ます。
ポリメラーゼリードの分布はこのような感じ。
1セルで7Gbものデータが出ると、高等真核生物のような大型ゲノムのアセンブリには向いているんですが、バクテリアサイズのゲノムにはそのままではオーバースペックなんですね。

そこで誰もが思いつくのがマルチプレックス。
バーコードをつけて、多検体を一度にシークエンスし、解析のところでバーコードごとに振り分けて検体ごとにHGAPする方法です。

その公式プロトコルができあがりました。解析ワークフローはこちらにあります。

この方法を簡単にまとめると
  • 10kbライブラリをつくる(ゲノムを切るとき10kbをターゲットにする)
  • ゲノムを切った後はExo VII酵素で切れ端一本鎖を処理する
  • バーコード付きのダンベルアダプターをDNAの両端にライゲーションする
  • ライゲーションした後複数サンプルを混ぜる
  • 5Mbゲノムなら12サンプルまで、2Mbゲノムなら16サンプルまで一度に混ぜることができる(Sequelのとき)
  • サイズセレクションにBlue Pippin は使わないで、0.45X AMPure PBを使用する
  • 解析はSMRT Link4.0 以降のソフトウェアで行なう
なぜ20kbでなく10kbライブラリを作るのか?
バーコードはインサートDNAの両側のアダプターについています。
そのアダプター配列を正しく読むためには、10kbくらいがちょうど良い長さなのです。
もちろんもっと短くても、ほとんどのポリメラーゼが端っこのアダプターまで到達するでしょうが、あまり短いとデノボアセンブリに向きませんね。
20kb のインサートだと、端っこのアダプターまで到達するポリメラーゼの数は半分以下か、もっと少なくなります。
それでは得られるデータが少なくなるのでマルチプレックスする意味が無い。
バーコードを認識するにはアダプターまで読みぬかないとダメ

ライブラリの長さとバーコード認識の比率はトレードオフの関係なんです。
ということは、ですね、とても長いリピート配列を含むゲノムには向いていないのです。
30kbのリピートが存在するゲノムをつなげるには、30kb 以上のライブラリが必要。
それだとバーコードまで届かない・・・。ジレンマ

でも、そこまで長いリピートを持たないバクテリア、または染色体を完全につなげなくても良い場合などはマルチプレックスをすることでコストを大きく引き下げることができます。

必要ゲノムDNAの量は?
DNAシェアリング(切断)した後のステップは、Exo VII酵素処理です。
ここで必要な検体あたりのDNA量は、
4マルチプレックスの場合:250ng
8マルチプレックスの場合:125ng
10マルチプレックスの場合:100ng
12マルチプレックスの場合:83ng
全体量で1μgがあれば良いのです

バーコード付きのアダプターは自分で作るの?
売ってます。PacBio Barcoded Adapter Complete Prep Kit.という名前で。
お勧め配列があるのでそれをつかいます

混ぜるときの注意点は?
DNA切ったときの切れ具合が、混ぜるサンプル間で似ていることが重要!
10kb狙って切ったとして、Bioanalyzerで確認して、もしも大きく切れかたが違った場合、DNA濃度をもとにして均等に混ぜるよりも、モル数を同じにして混ぜないと、均等にならない恐れがあります。注意しましょう。


ランニングコストはいくらになる?
12種類のバクテリア(ゲノムサイズ5Mb)を、この方法でバーコード付けてマルチプレックスで読んだときの、1株あたりのコストは、55,000円(2017年2月現在・Sequelの1セル使用時)


2017年1月13日金曜日

Sequel 新試薬登場でスループット向上!


もうアナウンスされましたが、PacBioのJPMネタは、「Sequelの試薬・ケミストリー・ソフトウェアのバージョンアップによってスループットがすごくUP!」です。

カタログもそれにあわせて改訂されました。ここからダウンロードできます。
6ページ目に注目!
これが今のSequelのスループットだ!!

これはあくまでゲノムアセンブリ用の長ーいライブラリ(例えば60kbとか)を読んだ場合です。サイズセレクションは30kbでしています(つまりライブラリは30kb以上の長さ)。
これを2.0ケミストリーで10時間(!)読んでいます。
セルあたりの出力リード数は365,000本で、うち半分のリードの長さは20kb以上。
この図では出力塩基数が 7.5 Gbです。バラツキはありますが5Gb ~8Gbというところでしょうか。

試薬のバージョンが2.0とか、ソフトウェアのバージョンが4.0とか、実際使っているユーザ以外にはどうでもいい数字だと思いますが、重要な点は、
  • 少ない量のライブラリからシークエンスできるようになった
  • 長ーいライブラリもローディングできるようになった
  • ラン時間が最大10時間までできるようになった
  • ベールコールアルゴリズムが改善された (精度がUp)
  • 短いライブラリでのシークエンス結果が改善された

という感じです。

ゲノムアセンブリにはできるだけ長ーいライブラリを作ることが重要です。
一方、構造解析などでは30kbとか40kbとかの長いものを作る必要はなく(もちろん目的によりますが)、10kb程度のライブラリでも十分解析できるのでは?というのが今のところのPacBio社内で一致した意見です。
ヒトゲノムのほとんどの構造変異は、Segmental Duplicationなどを除けば、だいたいは10kb程度に収まるのでは無いか?
もちろんお金とサンプルが潤沢にあれば、長いライブラリを作って読んだほうが、より多くのゲノム構造解析を検出できるでしょう。
でも現実的には、コストと検出感度・精度はトレードオフの関係にあります。
検体数にもよりますしね。
リードが長くなったおかげで、検出できる構造変異の数で見ると、新試薬の方が従来試薬の半分のコストで解析できるそうです。
コスト表を改訂しなきゃ。

2015年10月5日月曜日

40kbライブラリ&6時間シークエンス最強説

「40kbライブラリと6時間シークエンス」で、驚きのアセンブル結果!
本当は10月最初の話題はこれにするつもりだったのですが、新型機械の発表があったもんだから、インパクトに欠けてしまいました。

でも、8月に実際シークエンスをしてみて、アセンブルしてびっくりしたのでせっかくだからシェアします。
(公開にあたりサンプル提供者の許可は得ています)

このサンプル、腸管出血性大腸菌O111は、ゲノムの中に20kb~30kbのリピートが多く、ショートリードではアセンブルがとても難しい。
PacBioでも、一昔前の酵素では、同じように複雑なゲノムであるO157:H7ゲノムは200カバレッジで読んでもContig数は9本でした。
(Koren S., et. al. (2013) Reducing assembly complexity of microbial genomes with single molecule sequencing. Genome Biology, 14:R101 Table 3)


そんなところに、この度、最長Movie時間が4時間から6時間にバージョンアップ!
6時間シークエンスということは、超長いライブラリを作成すれば、長いサブリードが得られ、結果アセンブル結果も改善できるはず。

ということで、

  • 40kbライブラリを作製
  • サイズセレクションをよりシビアに
  • 4時間または6時間でシークエンス

を試しました。

40kbライブラリを作製するには、それなりに長くゲノムを切ることが必要。
今までのG-tubeではなく、Megaruptorという機器を使って切りました。
Megaruptorについてはこちら

この機械で何回かテストカットして、Pippin Pulseに流して確認。
本番カットでゲノムを40kb Shearingしたら、PacBio SMRT bellライブラリ作製へ。

ライブラリができたらおなじみBlue Pippinを使ったサイズセレクション
普通は7kbカットオフとか10kbカットオフとかを行なっていますが、ここでは17kbカットオフをした。
17kb未満のサイズのライブラリを捨てて、それ以上の長いライブラリだけを回収するというわけ。

さて、そのようにしてできたライブラリを、4時間と6時間でシークエンスしたら・・・

リード数は4時間より6時間の方が多いですが、これは偶然でしょう。
平均リード長は、4時間が9kb、6時間が10kb
平均サブリード長は、4時間が8kb、6時間が8.7kb
すごく長いというわけではないけれど、20kb、30kb超えのサブリードも結構ありましたので、これでHGAP3アセンブルを試みた。

Contig数はどちらも4本
最長Contigはどちらも5.32Mb
6時間Contigの配列でDot Plotを作ってみると、確かに、20kbから30kbの長さのリピートが多く含まれていた。
おおーっ!すごい!

6時間で作ったContigに、再度サブリードをマップして作られた、カバレッジグラフを見てみると、染色体5.32MbのContigは、60カバレッジ~140カバレッジであることがわかりました。
カバレッジが高い場所は、ORIであるかも知れない。
ほかのContigは、プラズミドかな? これはその道の専門家に調査をお願いしています。


さて、結果としては、4時間でも6時間でも、このゲノムの染色体はつながりました。
ちゃんと精査する余地はまだ残っているとしても。


せっかくなのでもっとすごいリード、サブリードの例もお見せします。
これは別の大腸菌です。

リード数も6万本、7万本と、さっきの株より多いけど、リード長はもっとすごい。

平均リード長は、4時間が15.6kb、6時間が18.2kb
平均サブリード長も、4時間が13.2kb、6時間が14.4kb

もちろんこのデータでも、染色体ゲノムのアセンブル成功
20kbのリピートも何のその! です。


もちろん、このようにサイズセレクションをシビアにすると、捨てられるDNA量も多いですから、最初に用意すべきDNA量は大変多い(10マイクロ~30マイクログラム)です。
これがネックでしょうね。少量DNAからもこのような長いライブラリを作れたら良いのですが。


2015年4月5日日曜日

PacBio-LITS PacBioでターゲットリシークエンス 1

今日は4月5日、東京は雨が降って、せっかくの桜も散ってしまっています。
今年ほど、桜満開の時期が短いと感じたことはなかったなあ。
7月のNGS現場の会に向けて、「お花見メタゲノム」の試料採取が、全国で行なわれているみたいですね。
私のFacebookの友人も、採取の様子をいろいろアップしていまいた。
結果が楽しみです!

さて、今日は、PacBioではあまり今まで話題に出てこなかった、ターゲットリシークエンスの話

リシークエンスには大きく分けて、全ゲノムリシークエンスと、ターゲットリシークエンスの2種類あります。
前者はゲノム全体をガッツリ読む方法で、後者は例えばExomeなどのような遺伝子のエキソン領域だけを濃縮して読む方法です。
濃縮キットは(「エンリッチ」キットとも呼ばれますが)、ゲノム配列を断片化したあと、

  1. 取ってきたい(シークエンスしたい)配列領域にデザインされたプローブをハイブリして、エンリッチする方法
  2. 読みたい配列の両端にPCRプライマーを設計して、そこだけPCR増幅して、取ってくる方法
の2種類あります。
ハイブリ方式か、PCR増幅方式か

市場で良く聞く製品だと、SureSelect (Agilent社)や、SeqCap EZ (Roche社)などは、ハイブリ方式
Ion AmpliSeq(LifeTech社)は、その名の通り、Amplification(増幅)方式

これまで、どの方式、どのキットも、PacBioのロングリードには対応していませんでした。
PacBioで読むには、エンリッチした後の配列長が、そこそこ長くなくては意味が無い!
そんな中、ハイブリ方式で6kbフラグメントのターゲットエンリッチメントに成功したのが、この論文
Wang et al. BMC Genomics (2015) 16:214

Baylor College of MedicineのDr. Min Wangらは、彼らのエンリッチ方法を使って、Potocki-Lupskiシンドロームの患者に見られる、chr17p11.2の複雑な構造変異、Low Copy Repeats (LCRs; またはSegmental Duplications )のブレイクポイントを、検出することに成功しました。

そもそも何で、ゲノム全体を読まずに、特定の箇所をエンリッチして読むのか?
興味のある場所がゲノム全体の数%だったら、そこだけを濃縮(エンリッチ)してきて、PacBioの超ロングリードでがっつりカバレッジ稼いで読めば、かなり消耗品を節約できます。
ゲノム全部を読む必要が無いひとにとっては、エンリッチメントはかなり効率的な手段なのです。

彼らは、Roche NimbleGen社の、SeqCap EZ エンリッチメントキットを使用して、つまりハイブリ方式で、ターゲット領域を濃縮、PacBioで読むことに成功しています。
この方法は、PacBioのアプリケーションノートでも紹介され、今後、本格的に広まる予感がします。

通常、SeqCap EZのプローブは、200bpのフラグメントに対してハイブリするようデザインされています。
これを、彼らは、6000bpのフラグメントでも可能であることを示しました。

まず、ゲノムDNAを、G-tubeで10kbに断片化します。
その後、Blue Pippinというサイズセレクション機器を使ってゲル泳動し、5~9kbの長さのフラグメントだけを抽出します。
SeqCap EZ アダプターをつけたあと、増幅し、プローブとハイブリします。
ハイブリしなかったDNA断片(濃縮ターゲットではない部分)をWashして捨て、ハイブリした断片(濃縮ターゲット)を回収します。
もう一度、回収DNA断片を増幅し、それからSMRT Bellライブラリ作製にかかります。

このようにして、ハイブリ方式で濃縮したDNA断片から作製したライブラリを、実際にシークエンスしたデータは、かなりの数のライブラリが6kbのサイズを保っていたことを示しました。
実際にHG19ヒトゲノムリファレンスにマップしたところ、マップされたReads Of Insert(ライブラリの長さにほぼ等しい)の平均長は、4.3kb~4.7kb
これだけの長さのリードを濃縮できた例は、私は聞いたことがありません。

論文に出ているとはいえ、まだこのプロトコルはPacBio公式ではありません。
もし試してみたい方は、うまく行かない可能性も無くは無い、ということを頭に入れて、お試し下さい。

どんな遺伝子でもエンリッチできるのか?
SeqCapEZ のプロトコルにはどんな工夫があるのか?
データ解析ツールはどんなふうに使ったら良いのか?

などなど知りたいことはありますが、またフォローしていきますのでお楽しみに!


2015年3月31日火曜日

Structural Variant - 構造変異 PacBioでヒトを読んだら

PacBioのリードは長い
これはもうわりきっていることですが、長いリードを使ってできること、のひとつ
「Large InDel, Structural Variantの検出」を、ヒトゲノムでやるのはなかなかチャレンジングなテーマです。
なぜかと言うと、昨年(2014年)まで、
  1. デノボアセンブリするにはものすごい計算量が必要だった
  2. 平均リード長が、長いといっても5Kb(P4)、7Kb(P5)で、長いリードでゲノムカバレッジ上げるのにセル数がたくさん必要だった

もちろん、今(2015年)でも、PacBioでヒトゲノムやるにはバイオインフォの専門家が必要です。
誰でも簡単に楽チン解析!というわけにはいかんのです。

そんな中、韓国では、Macrogenという会社が、PacBio RSII を2台、HiSeq X10を、大人買いして、韓国人ヒトゲノム解析を行いました!
PacBioを買った、というプレスリリースが昨年10月だったから、たった5ヶ月余りで結果を出した、スピード感が半端無い。

以下、画像はPacBio AGBT 2015のYou Tubeからスライドキャプチャー
(その場面から観たいひと向けに時間も表示しておきます)

PacBioRSIIとHiSeqX10を使って、Blood Cell lineとGerm CellのBACを読んでいます
が、デノボアセンブリのメインはあくまでPacBioのデータ
281個のSMRT Cellでゲノムサイズの72X分のデータをP6C4で出力
Falconを使ったDiploid デノボアセンブリを行い、N50が7.3MbのContigを記録!
まあ、アセンブル結果は、PacBioすごい!の一言になるのでもう聞き飽きているひともいるでしょうね

デノボアセンブルの結果は、BACのアセンブル結果と共に、GapをFilling
BioNanoのIrysも使われたそうです
でもこれについては、本プレゼンでは軽く触れる程度です
IrysとPacBioRSIIは、親和性が高いと個人的には思っています
今度機会があったら、両方持っているユーザに聞いてみようっと

さて、本題のStructural Variant
先ずPacBioで作ったContigを、GRCh38リファレンスゲノムに対して、Symapでアンカリング
次に、アンカリングされたContigと、染色体配列を、アライメント
構造変異があったところは当然アライメントされないでしょうから、そういう箇所を "In-House Tools" を使って検出
だそうです。
In-House Toolsが知りたい!
まあ、そのうち論文になるのでしょう。そのときを楽しみに
SyMAPというのは、 比較ゲノムで用いられるツールのひとつです。
異なる種のゲノム(Contigも)配列を比較して、どこが一致しているのかをビジュアルで見せてくれるプログラム サイトはここ
フリーツールですよ

彼らはこうして、ヨーロッパ人には無い、アジア人特異的な構造変異、InDelなどを次々に発見!
おそらく、今年のアメリカ人類遺伝学会ではもっと、エキサイティングな発表があるでしょう。
韓国以外のユーザからも、もちろんね


で、Structural Variant関連でもうひとつ
こちらは前回も紹介した、CSHLのMcCombie博士らのHer2陽性乳がんセルラインのデノボシークエンスの発表

SMRT Cellのパフォーマンス、こちらはオンタリオがん研究所のデータですが、どんどん長くなっているのがわかります。
で、今は平均11kb、1セルあたり1Gbを出力していますね
きれいなデータです
これくらい、出ることもあります

 ここでももちろん、構造変異を見ています

Lumpyというプログラムは、恥ずかしながら知らなかったのですが、論文になっているようです。
ソフトクリップアライナーでアライメントされたBAMファイルをインプットとして、ゲノム位置が離れてマップされているリード情報から、構造変異の箇所を特定するツールです。
アライナーは、NOVOALIGN、BWA-MEM、YAHAなど、"Long Read" でもアライメントできるもの(PacBio用という意味ではないことに注意)を使用
LUMPYは、Illumina用に開発されたようで、ここでも彼らはIlluminaデータを使って、BWA-MEM+LUMPYで、大まかなマップ位置を確認
その後、(あまり詳しく述べていませんが)PacBioを使ったローカルアセンブリ


Her2(Human Epidermal Growth Factor Receptor type 2)遺伝子は、ヒト上皮細胞増殖因子受容体と良く似たタンパクを作ります。
このHer2タンパクは、正常細胞にも存在し、細胞増殖に関わっています。
乳がんの患者さんのがん細胞では、正常細胞に比べて、過剰に発現・活性していることがわかってきたそうです。 ここにくわしい
Her2と言えば、これを狙った分子標的約、ハーセプチン(これは商品名、正式名はトラスツズマブ)が有名です。

薬学部卒でもない私が何でこんなこと知っているかと言うと、前職で扱っていたパスウェイソフトウェアで、薬とタンパクのパスウェイをいくつか作っていたからです!
こんなときに役立つとは。

ま、話を戻すと、Her2陽性乳がん細胞で、17番染色体上のHer2遺伝子が過剰増幅したときのメカニズム、
8番染色体との転座による増幅、
Her2周辺の遺伝子と共に増幅、
部分的にInversionなどされて増幅、
などの様子が、今回PacBioを使ったシークエンスで確認できた。

この乳がんセルラインは、もともとHer2が過剰発現している細胞株だとわかっているから、これをシークエンスレベルで確認できただけ、と言ってしまえばそうなんだけど、
今あるテクノロジーでここまではっきり確認できるのはPacBioのロングリードがあればこそ、でしょう!

オンタリオがん研究所は、カナダでもトップのがん研究機関。
ここにPacBioが入ったのは2011年とかなり初期です。
当初、ヒトゲノムに挑戦するのはかなり大変だったけれど、今ではこのように現実味が出てきた。
まだまだセル数はたくさんいるけれど、これでがんの遺伝子メカニズム・構造変異が発見できるなら、決して高価なプロジェクトではないのでは?
これまでのテクノロジーでは隠れていた、大発見があるかも知れませんね。


2013年9月30日月曜日

PacBio RS II によるバクテリアゲノムアセンブリ:海外トップユーザの状況から

今日は久しぶりに会社のチームみんなで集まってビアガーデンパーティをしました。
出張が多いメンバーが一度にみんなそろうことはめったに無いのです。
9月30日、ビアガーデンとしてはちょっと肌寒い時期でしたが、大手町サンケイビル4階の「天空のビアガーデン」 
今年の夏を締めくくるにふさわしい、とても良いひと時でした。


さてさて、バクテリアサイズのゲノムのデノボアセンブリには、PacBio RSを超える機械はこの世に存在しない! というのはこのブログを読んでいる皆様にはもう常識?ですが、海外でももちろんその通りです。
JGI(Joint Genome Institute)という、アメリカエネルギー省管轄の研究所がカリフォルニア州ウォルナットクリークにありまして、ここでは2台のPacBio RSがフル活動しています。 
エネルギー省の施設なので、読んでいるバクテリアの種類は、病原菌というよりもどちらかというと環境や生態系に関する重要バクテリアや、バイオ燃料開発などで重要なバクテリアで、これらをがんがん読んでいるそうです。

彼らのホームページにもPacBioシークエンサーのことが書かれていて、HGApのことについても触れられています。HGApはもうご存知、PacBioのロングリードだけでエラー補正からアセンブリ、Contig Polishingまでを自動で行うパイプラインのことですね。
このアルゴリズムの開発にも、JGIは大きな貢献をしました。
http://www.jgi.doe.gov/News/news_13_05_06.html

さて、JGIでは、大量のサンプルをガンガン読んでいるために、サンプル調整を手で行うのは大変になりました。
そこで導入したのが、PerkinElmer社から売られている自動分注装置。
Caliper社のScicloneという自動サンプル調整ロボット機械には、PacBio用のアプリケーションが作られ、その名も  Maestro PacBio 10Kb DNA Library Prep
マエストロですよ!好きです、こういう自身満々の名前
http://www.perkinelmer.com/Catalog/Family/ID/Sciclone%20NGS%20Workstation
この装置は、PacBioの3Kb - 10Kbのライブラリ調整を自動で行ってくれるそうです。
スループットは一度に8 から 96 サンプルで、8時間以内で終了するそうです。

このような装置は、いろんな種類のサンプルを読む場合、たくさんのライブラリを作る必要があるので、大活躍するかもしれませんね。
反対に、大型ゲノムを数種類だけ読むような場合、最初にライブラリを作ってしまえばあとはできているライブラリをたくさん読むだけなので、サンプル調整は手で行った方が安上りかもしれません。

いずれにせよ、たくさんの種類のバクテリアを読んでいるJGIには、この手の機械が有用なのでしょう。
これがその自動化マシンを使ったときの、DNAサンプルからContigデータまでの流れです。
PacBioのプレゼンより引用
DNAのシェアリングまではG-tubeでやるんですね。ここはマニュアルかあ。

断片化した後の、ライブラリ調整を、PacBioプロトコルに合わせてこの装置がやってくれるわけですね。
出来上がったライブラリをシークエンサーに乗せるわけですが、サイズセレクションは当然これもマニュアルでしょうね。

回収率はどれくらいなんでしょう?

2013年7月27日土曜日

共生菌ゲノムの論文、日韓ほぼ同時Published


先週の木曜日、品川の京都大学東京オフィスにて、「NGS現場の会・第三回研究会」のスポンサー企業ミーティングがあり、行ってきました。
現場の会の集まりだから、わざと、アロハシャツ着て行ったら案の定、司会の渡辺さんにいじられましたよ。
久しぶりに会ったひとも何人かいて、懇親会の後も飲みに行ったり。
みんなで現場の会を盛り上げていきましょう!


さて、今月、アジアから2本、PacBioユーザの論文がPublishされました!
1つは日本、1つは韓国です。
  • 日本:Shibata TF et al., Complete Genome Sequence of Burkholderia sp. Strain RPE64, Bacterial Symbiont of the Bean Bug Riptortus pedestris. Genome Announc. 1(4):e00441-13.
  • 韓国:Seung Chul Shin et al., Advantages of Single-Molecule Real-Time Sequencing in High-GC Content Genome. PLoS ONE 8(7): e68824 
ホソヘリカメムシの共生菌、Burkholderia sp. strain RPE64のゲノムサイズは6.96Mbで、3つの環状染色体と3つのプラズミドから成るそうです。 
HiSeq2000で何種類かのペアエンドライブラリを読み、PacBioで6kbライブラリを読み、Allpaths-LGでハイブリッドアセンブリしています。

 こちらは南極圏に住む地衣類の一種、Cladonia borealisの共生菌、Streptomyces sp. PAMC 26508のゲノムを読みました。
PacBioは8kbライブラリをロングリード用に、1.5kbライブラリをCCS用に読み、そのほか300bpペアエンドをIllumina HiSeq2000で、7kbペアエンドをGS-FLXで、読んでいます。
pacBioToCAを使ったエラーコレクションの後で、Celera Assemblyしています。
エラー補正に使うリードの種類で、どれだけアセンブリの成果が変わるか、見るとへえー、って感じです。 


ところで、「NGS現場の会・第三回研究会」で、ぜひ、注目してほしい企画があります!
その名も、「DeNovoの達人」
 
同じサンプルを、PacBio、GS Junior、MiSeq、PGMで阪大微研さんで読んで頂きました。 これを、東大、慶応大、OISTのエキスパートがアセンブルに挑戦する!という企画。
このポスター好きです。作ったひとセンス良い!


2013年7月18日木曜日

PacBioの使い方・質問 募集!


ANAのボーイング747型機(通称ジャンボ機)は、来年3月で退役するそうです。ANAでは現在4機所有していて、どれも20年くらい働いているとのこと。 機長のアナウンスで知りました。
今回初めて、2階席に乗ったのですが、意外と広くて、窓側席には小物がしまえるスペースもあり、圧迫感が無いのにびっくりです。 でも、あと何回乗れるかなあ。

東海道山陽新幹線の500系車両、ってわかりますか? 青いカラーのとんがりノーズで、最初に時速300㎞の営業運転を始めた新幹線です。 壁と天井が300系や700系、N700系とは違って、半円形に近いんです。 ちょうどジャンボ機の2階席のように。
この500系も好きだったんですが、何年前でしょうか、のぞみ号から引退して「こだま」になってから乗らなくなりました。

出張の楽しみと言えば、こういう移動手段を選ぶときです。 あとは、ホテルを選ぶときと食べもの屋&飲み屋を選ぶとき。 もちろん仕事第一ですよ。


さて、NGS現場の会が9月の4日と5日にあります。 そこの企業セッションをチェック!
今年もPacBioのネタを喋りますが、単純なプレゼンではつまらん、と某広報委員長さまから言われましたので、少し志向を変えて、会場の方からの意見や質問も混ぜた感じのインターラクティブなものにしたいと考えています。

そこですでに現場の会メーリングリストを通じて、「PacBioをこんなふうに使えないのか?」とか「私はこんなアイデアがある!」とか「PacBioに関連してこんな噂を聞いたのだが本当か?」といった声を募集しました。
まだ受け付けていますので、是非、こちらまでメールでお送りください。
Addressは、ken_osaki「アット」digital-biology.co.jp
ちゃんとPacBio本社に確認してお答えします。

とは言っても質問自体も思いつかないよ、という方のために、今のPacBioシークエンサーのおさらいを少し。
スループットのグラフは以下の通りです。 横軸がリード長、縦軸がリード本数です。
【リード長は一定ではない】
平均4,600bpというのは、このような分布のリード長すべての平均です。 最長リードは20,000bpを超えますが、全体からするとごく一部です。
また、リードの長さとサブリードの長さは一致しません。

【ライブラリの長さも一定ではない】
10kbのライブラリを作りたくて、ゲノムDNAをシェアリングしたとしても、6kbの長さや3kbの長さのDNAも、最終的なライブラリに含まれるかもしれません。 これはライブラリ調整の過程で、AMPureのようなビーズや、BluePippinのような電圧を利用した、サイズセレクションをかけることである程度改善できますが、それでも完全に取り除くことはできないでしょう。
結果、10kbのライブラリサンプルの中には、6kbや3kbのサイズのライブラリも混在することになります。 ここで、「読まれやすさバイアス」の問題が出てきます。

【短いライブラリほど読まれやすい】
ZMWの穴には、普通、短いライブラリ程入りやすい、という物理的な性質があることが、わかっています。
Magnetic Beadsという磁気ビーズを利用して、長いライブラリを優先的に入りやすくする方法が現在デフォルトであります。
しかし、これでも実際やってみると、3kb位のライブラリならZMWの穴に入ってしまうんですね。
数百bp単位の短いライブラリを取り除くのには効果的なんでしょうが。

というわけで、10kbをターゲットとして作ったライブラリでも、3kbのライブラリがZMWの穴に入っていることは十分考えられることです。
ただ、その割合は読んでからでないと正確にはわかりません。

で、ここからがややこしいんですが、どの長さのライブラリから、どれくらいのリードが読まれたのか、この辺を知りたいと思いませんか? もしかしたら20kbのリードのほとんどは、3kbライブラリを何度も読んでいるだけかもしれない。 10kbライブラリは実は4kbくらいしか読まれていないかもしれない、などです。 
この辺は普段誰も説明しないし、PacBio本社もあまり深く調べていないようなのですが、私は気になります。


それはさておき、PacBioの新しい使い方のアイデア、噂話に対する質問、等ありましたらどんどんメールでお知らせください。

2013年6月5日水曜日

アドバンストワークショップ in TOKYO

夏ですねー、この天気。
梅雨入りしたのに東京は晴天で暑い!

先日ここで宣伝させて頂いた5月24日半日セミナーは満員御礼の大反響でした!
ランチが足りなく急きょピザを注文したりして、皆さまご協力ありがとうございました。

お客様のアンケートにも、「またこういうセミナーを開いて欲しい」「今度はトランスクリプトームのテーマが良い」など、とても前向きなご意見ご感想があり、嬉しい限り。
今度はいつ企画しようかな?

イルミナさんがやっているような、ウェビナーも良いですよね。 公開OKな方がいらっしゃればそれもまた選択肢のひとつ。


ところで、今週、PacBioのユーザー様を対象にした、ワークショップを行っています。
このワークショップは、ウェットを中心とした、PacBio最新プロトコルを学んで頂くことを目的としています。
最大の見せ場?は、20kbの超ロングライブラリーを作成して読む!
あと、今までのSMRT Bellライブラリを作らない方法で、読む!

皆さま一生懸命ライブラリ作成中です。

このワークショップには、PacBio本社からアプリのトレーナーを1名呼び、トミーデジタルのアプリ担当者3名、PacBioアジアオフィスからの社員1名と、さらにさらに、ライブラリーサイズセレクションの機器「Blue Pippin」の販売元本社と日本代理店(日本ジェネティクス株式会社)から計3名が、サポートに参加しています。
ありがとうございます。

私は今回は脇役で。

データが出てくるのは金曜くらいですが、皆さん楽しみですね。

ワークショップの様子(Blue Pippinの操作を見学しているところ)

ワークショップ会場は、上野動物園の隣りの、池之端のエッジビルというところです。

2013年4月4日木曜日

デノボトランスクリプトームにもどうぞ

企業が主催するウェビナーは好きです。
ライフサイエンス系のウェビナーは、時間が許す限り、見ようと思います。
IT系だと昔から結構普通にありましたが、最近2、3年は、バイオ系の会社も講師を呼んでセミナーをして、それをネットで生放送するのが流行りになりつつあります。

企業のウェビナーと言えば、今日(もう昨日かな)、4月3日に参加したのが、イルミナ社のウェビナー。 時間も夕方だったので、オフィスの何人かと見てました。
最近注目しています。 内容も面白い。 本音で語る演者をうまく厳選している感じです。
やるな。

あまり褒めると立場上アレなのでコレくらいにして。

今日のお話は、基礎生物学研究所 生物機能解析センターの、重信 秀治先生による、「非モデル生物のRNA-seq解析 -- 実験デザインから解析パイプラインまで」 でした。

見逃した方も、イルミナ社のサイトから録画を閲覧できます。 ここから

今日はデノボトランスクリプトームがテーマで、これは私もとても興味のある分野です。

重信先生は、リファレンスの無い生物のRNA-Seqをしてアセンブルするツールに、Trinityを勧めていました。 
Trinityは昔は結構メモリを食うツールで、困った経験があります(2011年7月22日の書き込み参照)。でも今は大分使いやすくなったそうです。良かった。
ペアエンドのイルミナHiSeqを使っていました。 例にあげられた生物種がちょっと気持ち悪(ワモンゴキブリ)かったですが、内容はとてもためになりました。
出来ればスライドの右上に登場するゴキブリの写真を、せめて可愛いイラストに変えて欲しかった。
ゴキブリ、苦手です。

非モデル生物のRNA-Seqは、目的が2つに分かれ、それぞれに実験計画が異なる、との言葉には大賛成です。
Isoformや新規の遺伝子を見つける目的には、できるだけ異なる環境や形質(卵、幼虫、蛹、成虫など)からまんべんなくたくさんのcDNAを読む。
発現量や発現比測定の目的には、統計計算できる生物学的リプリケートを用意して読む。
(個人的には、前者、新規遺伝子発見の方に興味があります。)

デノボで遺伝子候補を見つけた後に、ORF検索したり、BLASTxしたり、と、いわゆるアノテーションという作業が続くのです。 重信先生はさらっと言っておりましたが、結構大変な作業ですよ。
私もやってましたから。

それはそうと、重信先生、今後PacBioにも期待していると仰って下さいました!
多謝!

PacBioは、平均的cDNAなら全長読むことができます。
Trinityでアセンブルした結果のContigが、本当に遺伝子を反映しているのか、白黒付きます。

まだ、私もcDNAをPacで読んでの解析は、経験が浅いですが、「全長が読めている!」というのは最初感動しました。
GMAPでゲノムにマッピングして(おっと、ここでデノボでは無いのがバレてしまいました。実は非モデル生物でのcDNAサンプルはまだ手に入っていないので、モデル生物でしかやったことが無いのが現状)、IGVやUCSCブラウザで見たときに、これが一本のリードから取れた配列なのか、としばし見入ってしまいました。

モデル生物でも非モデル生物でも、全長cDNAがバッチリ読める、そんな感動を味わいたい方、PacBioいかがですか?

2013年1月15日火曜日

PacBioのリード長、最高20Kb突破!

本当はこの話は昨年の年末に書いたのですが、ブログのサーバの不具合で投稿されていませんでしたので、再投稿。 
以下のデータは12月のものです。 今はもっとたくさんありますが、それはおいおい。

さて、今の会社に入って1年が経ちました。
早いなあ、と感じる一方、1年前が3年くらい前に感じます。 ものすごく密度の濃い1年でした。
まあ、事業部の立ち上げ初年度でしたので、いろいろ手探り状態から始まり、PacBioからは毎月いや毎週かな、ひとが来る。

海外とやり取りが増えると、当たり前ですが時差があるので土曜もメールが来る。
スマホの有り難みを肌で実感です!! その分忙しくなった・・・。
海外の知り合いはとても増えました。
この業界は狭い、というのは海外も同じだということもわかりました。みんなどこかでつながっている。

他のシーケンサーメーカーもそうでしょうが、PacBioは常に進化しているので、ついていくのが大変です。 
1年前に書いたことがもう時代遅れになる。
このブロブもそういうつもりで読んで頂ければ幸いです。
カタログも書き換えなくてはいけないかも。

そこで、1年前に書いたことが古い情報になる例をひとつ示します。


このグラフと数値は、今のカタログに出ているものです。
10kbのライブラリを、90分Movieで測定したときです。

私が昨年5月に「NGS現場の会」で喋ったとき、後から座談会みたいなテーブルで、このリードの長さは将来どれだけ伸びるか、という質問を受けました。
皆さん、ロングリードに興味のあるひとはこの点を聞いてきますね。 
1.5倍くらい伸びる、と答えた記憶があります。

そしてあれから7ヶ月後、最新のデータはこちらです。 恐らくこれがオフィシャルなカタログ数値となるでしょう。

  • 平均Mappedリード長: 4,500 bp
  • 95th Percentile: 12,000 bp
  • 最大リード長: 21,000 bp
 
これはPacで11kbのライブラリを、最新の試薬で120分のMovieで読んだ時のものです。

実は、XL(Extra Long) Chemistry という新しい試薬&酵素が最近リリースされました。
諸般の事情で正式リリースが遅れましたが、日本でも今随時アップグレードしつつあるところです。
そう、アップグレードによって、120分のMovieで読めるようになったのです!

われわれも実際、アップグレードして読んでみました。
11kbのコントロールを、120分で読んでいます。
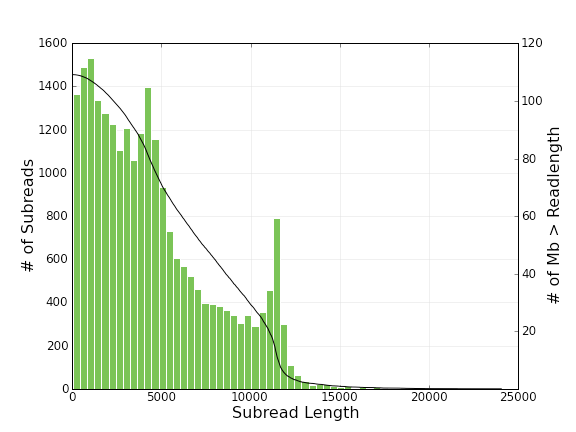
上のグラフは、アダプターを取っただけの、サブリード長が横軸に、その数が左縦軸に。
まだマップさせていません。
Subread Length = 11kbのあたりにピークがありますね。

実は11kbジャストのライブラリではありません。ちょっと長いものも、短い(数千bp)ものもあります。
しかし、アダプター間の距離を見たところ、このランしたサンプルのインサートサイズで一番多いのは、11kbでした。
ではなぜ上のように、11kb未満(11000より左側)のサブリードが多数を占めているのか?

理由1: 11kbのインサートで、11kb以上読めた場合、例えば15kb読めた場合、アダプターをぐるっと回って相補鎖側の4kb(15-11= 4kb)がもうひとつのサブリードとしてカウントされる

理由2: 短いインサートは、長いMovie時間読まれれば、それだけ多くのサブリードを生産するだろう。 グラフの縦軸はサブリードの数なので、短いインサートから生産される多くのサブリードが多くを占めて見える。

からかな?

このグラフがリファレンスにマップさせた後のリード長の分布
縦軸がリードの数、横軸がMappedリード長
さて、数字は次の通り

  • フィルタリング前の全ZMW数:  75,153
  • そのうち解析可能なデータが出力されたZMWの割合:  28.6% (これはちょっと少なめだ)
  • クオリティと長さ(50bp)でフィルタリングした後のリード数:  21,495 

もうすこし多くのリード数が得られれば、もうちょっとグラフの形も変わるかも。
まあ、初回のランなのでこんなもんでしょう。
それよりリード長に注目!
  • サブリード単位のマッピング精度の平均:  86.29% 
  • マップされたリード数:  20,193 
  • マップされたリードの平均長:  4,918 bp 
  • 95th Percentile マップされたリード長:  13,016 bp 
  • マップされたリードの最大リード長:  23,540 bp 
確かに長い! 長くなってる
でもこれ、ラムダコントロールのサンプルですからねえ。読めて当たり前かな。 
実際のサンプルで読んだらどうでしょうね。 (<-再投稿している1月現在ではバンバン読んでいます。結果はそのうちに)
Yieldはもっと改善できるでしょう。

今年は、より長くなったリードで、より多くのプロジェクトが進むといいですね。


・・・ 追記
さてさて、ここまでは「今の」スループットの話。
PacBioや私たちのプレゼンを実際に聞いたひとは、知っていると思いますが、上記に示した数値はあと数ヶ月すると変わっているでしょう。
もちろんYield(リード出力数)、リード長共に、良いほうに。

今年も忙しくなるなあ。

2012年8月27日月曜日

DNAはたくさん必要

もうすぐ9月だというのに、まだ暑いですねえ。
私は蚊が嫌いです。 夜中でも殺すまでは寝られません。
書いている今も、どこかに蚊がいるんですよね。 「虫よけ当番」を枕元に置かなきゃ。

ま、それは置いておいて、PacBioは1分子シーケンスを売りにしています。
基本的にPCR増幅はしません。
想像はつくと思いますが、そうするとスタート時にDNAはたくさん必要になるのです。
ちなみに今は、2本鎖のDNAだけ、からスタートできます。

スタート時に必要なDNA量ですが、サイズによっても違いますが、大体、10Kbのライブラリーで読むときは、9μgくらいは必要でしょうか?
と、これはアメリカの受託会社、Expression Analysis (EA)のドキュメントが公開している数値です。
Webで公開しているので書いても良いでしょう。
ドキュメントはここ(http://www.expressionanalysis.com/platforms/category/pacific_biosciences/)
のページの、右上の、Comprehensive PacBio RS Overview というところからダウンロードできます。
実は、この会社との出会いが、私をPacBioにのめり込ませたのですが、この会社は、アメリカでマイクロアレイやシーケンサーの実験・解析受託をしています。
昨年の6月に、PacBioのサービスを始めて、安定してビジネスを展開しているそうです。

さて、DNA必要量の話に戻りますが、9 μg という数値はかなり多いでしょう。
シェアリングして、End-repairして、Ampure Washして、…と進めていくと、ライブラリーにするころには、750 ~ 1250 ng が予想される回収量になるそうです。
(なるそうです、と書きました。いえ、私も予想回収率くらい知っているんですよ。でもPacBioのプロトコールはWeb公開されていないので、ブログで書くのはまずいからあくまで第三者のふりしてます。詳しく聞きたい方は別途)
EA社はこの場合、20 ~ 35のSMRT Cellが使用できる、と書いています。

で、データはどれくらい出てくるか、ですが、10Kbで90分Movieで読んだとき、生データで最長20Kb、クオリティフィルタリングした後で14.6Kb
平均リード長は、生データで3.7Kb、フィルタリング後で2.6Kb
フィルタリング後のリード数は44,232本、塩基数は116Mb

このデータは、比較的現実に沿った数値です。
チャンピオンデータではありませんが、いろいろなサンプルをやった経験値でしょう。

フィルタリングの条件は、リードにはそれぞれRead Qualityという精度の指標があるのですが、これが 75/100 以上であることと、クオリティの良い部分のリードの長さが50bp以下ではないこと、です。
これにひっかかるリードは除去されます。
そうして残ったリードの、平均長が 2,600 bp、Maxが14,600 bp ということなんですね。

Read Quality 75以上、リード長50bp以上、というのはデフォルトの値です。
50bpでは短すぎるな、と思うときは私はこれを上げていいと思います。


サンプル調整自体は、私もトレーニングを受けましたが、それほど難しいステップはありません。
シェアリングもCovarisの機械任せだし、精製もマグネットビーズでピペット処理だし、アダプターダイマー(アダプター同士の接着)をこれまたビーズで取り除くだけ。
基本プロトコールは順調です。
でも、裏プロトコール?みたいなトラブルシュート的なプロトコールでやったときはほとんどDNAをロスってしまいました。
ラボを離れて約7年・・・の私には、裏プロトコールは難しかった。
とは言っても、基本プロトコールで作った10Kbのライブラリーの方は、ライブラリーまでの回収率は33%で、Good!
ランの結果も、上記EA社の数値と同じくらいでした。


ところで、より少ないスタートDNA量でランできないものでしょうか。
たくさんDNAがとれないサンプルでも、長く読んでみたいという要望はあります。
この要望に応えるための方法は、・・・
公式にPacのWebSiteで公開されたらここでも書こうかと思います!
まだ書けないーっ!