ラベル ツール の投稿を表示しています。 すべての投稿を表示

2018年4月9日月曜日

ロングリード解析やっているひとはこの論文を絶対読まないと!

NGS解析をやっているひと、特にロングリード解析をやっているひとは絶対読まなければいけない論文、それがこれ
Piercing the dark matter: bioinformatics of long-range sequencing and mapping
Sedlazeck et al., (2018)Nature Reviews Genetics.
ロングレンジ技術を使ったゲノム解析に関する、すごくComprehensiveにまとめられた、バイオインフォマティクスのレビューです。
これはほんと超おすすめ。
このレビューはいくつかのパートに分かれてまして、

1.ロングリードテクノロジーのまとめ
ここでいうロングレンジ技術とは、Pacific Biosciences (PacBio)や Oxford Nanopore Technologies (ONT)のように、「本当の」ロングリードと、10X Genoimics のリンクドリード、BioNanoのフィジカルマッピング、Hi-Cのような超ロングレンジメイトぺア、を含みます。
それぞれの技術の特徴(ロングリードのエラー率の高さなど)がまとめられています。
Bamファイルの今のフォーマットが、ロングリードマッピングデータにはもはや向いていない、という点は前から言われていましたね

2.De Novo Assemblyへの挑戦

  • ゲノムに存在するリピート配列の存在が、ショートリードでのゲノムアセンブリを難しくしている
  • ロングリードが30カバレッジ未満しか無いときは、ショートリードとのハイブリッドを使うべきだろう
  • しかしショートリードでのロングリードエラー補正(PBcR, Nanocorr, Spades and MaSuRCA,)は、GCバイアスなどの問題でロングリードを正しくエラー補正できない可能性がある
  • ロングリード同士のSelf Correction (HGAP, PBcR, Canu, MARVEL or FALCON)が、もっとも良い
  • 倍数性の高いゲノムのアセンブルは今も、難しい (NRGeneという会社は倍数体があっても独自の秘密プログラムで行っているそうですが仕組みは非公開です)
  • コンティグを作った後のポリッシングには、QuiverやArrow(PacBio用)、Nonopolish(ONT用)、Pilon(ショートリードをポリッシングに使用)などがある
3.スキャフォルディングとギャップフィリング

  • スキャフォルディングには、10XやHi-Cなどが有効
  • しかしアセンブルの時点で高精度のコンティグを作ることが何より重要
4.SV解析
  • まずはSVの定義をはっきりさせている(挿入とか欠損とか、転移とか)
  • SV検出精度はマッピングの精度に依存する(BLASR, BWA-MEM, minimap/minimap2, LASTなどについても言及)
  • コスト、倍数体、リファレンス配列の精度、などがSV解析の大きな問題点

そのほか、ここには書ききれないほどのトピックスがたくさんあって、とにかく、一度読んでみてくださいと言うしかない!
バイオインフォマティクスのレビューなので、アセンブルからSVコール、RNAシークエンスまで、巷にあふれるたくさんのツールの解説があります。

もちろんこのレビューは、決してPacBio贔屓ではありません。
ロングリードはPacBioとONTがありますが、むしろ、最長ロングリードはONTに軍配が上がっている。
PacBioは、エラーのランダム性から、コンセンサス配列の精度は最も高いロングリードと言える。

どうやってもロングリードの場合、PacBioもONTもリード長には限界があり、結果、10XとかHi-Cとか、ショートリードによる擬似的な超ロングリードとの組み合わせがアセンブル結果や構造解析、フェージング解析の結果を大きく改善することは間違いない。

今の時代、複数のテクノロジーを、最適なバイオインフォマティクスツールをうまく使いこなして解析することが重要なんだなと、改めて実感するレビュー論文でした。


--------- 5/18(金)は秋葉原へ集合!------------
「PacBio 現場の会 2018」
登録はこちらから
5名の招待演者と
PacBio、Dovetail、その他最新NGS情報を
一度に聞ける年に一度のイベントです!
情報交換会もあります。
参加無料、PacBioに興味のある研究者なら誰でも参加OK!

2017年11月20日月曜日

PacBioとナノポア 違いはここだ! (2017年版)

2017年は、PacBioにとってのライバル、オックスフォード・ナノポアテクノロジーズ(以下ONT)がいよいよ本格的に市場に登場、ロングリード業界に新たな風が生まれました。
(正確には、2016年でもMinIONを購入することはできましたが、誰でも手軽に買えるようになったという意味では2017年が国内リリースの年といっても良いでしょう)

そこで聞くのが、PacBioより長いリードが出てくるとか、バクテリアアセンブリにはONTだけで十分とか、ロングリードはナノポアに席巻されるのでは?という、PacBioに否定的な意見。
一方、ナノポアのデータはまだ精度が悪い、超ロングリードはエラーだらけ、ノートPCではランはできるけど解析はできない、というONTに否定的な意見も。

どちらもロングリードを謳っているだけあって、目的がデノボアセンブリやゲノム構造変異解析、16S解析など、ガチでぶつかるのは当たり前です。
では2017年11月の現時点で、このふたつの製品はどこがどう違うのか?

注!:皆さんご存じ、私はPacBio側の人間なので、これから書くことは多少ともPacBioバイアスがかかっています。そこを承知の上、お進みくださいね。


さて、PacBioとONT、現時点でどこがどう違うのか?

【テクノロジーの違い】単純にいうと
  • PacBio:DNAポリメラーゼがDNAを合成するときに、取り込む塩基に付加されている蛍光を、レーザーによって1塩基ずつ検出する。1つのウェルからは1本の配列データしか出力されない
  • ONT:DNAがナノサイズの穴を通るときに生じるわずかな電位差を検出し、アルゴリズムが塩基配列に変換する。1つのポアから複数本の配列データが出力される
つまり、
  • PacBio:DNA合成を伴う、蛍光色素を使う。レーザー励起エネルギー検出
  • ONT:DNA合成は行わない、蛍光色素は使わない。電位差検出
皆さんご存じの方も多いと思います。

【リード長はどうか?】
  • 平均リード長:PacBioもONTも同じくらい (10kb~20kb)
  • 最大リード長:PacBioは読むライブラリのサイズ、ムービー時間などで制限されるので60kb~100kb程度ではないかと思う。数百kbのリードは見たことが無い。一方ONTは、ポアを通るDNAが長ければ、最大1Mbのリードも出るそうだ
  • しかしリードの本数や分布には注意が必要。PacBioもONTも、短い(とはいっても数キロbpはあるが)リードは多く出力され、長いリードほど出力数は少なくなる。先のONTの超ロングリードも、出力本数でいうと数本
  • 因みにランタイムはPacBioのSequelが30分~10時間、ONTのMinIONが1分~48時間、だそうで。
数値についてはこちらを参照(オフィシャルな情報です)

で、精度はどうか?
生リードとコンセンサスリードで精度の意味は違う。
ここを一緒にして、「ロングリードは精度が悪い」という研究者のなんと多いことか!!

【生リードの精度】
  • PacBio:RSIIのP6C4ケミストリーや今のSequelは、平均86%
  • ONT:精度の数字はケミストリーのバージョンによって様々のようだけど、R9.2は平均80%~85%くらいか(違ってたらゴメン)。でも使うベースコーラーによって精度は変わってくるそうです。ベースコーラーは何種類かある
つまり、どちらも生リードの精度はほぼ同じ、ということになる。しかしもっと重要な点は、エラーの入り方。
【エラーの入り方】
  • PacBioはランダム
  • ONTはランダムという話も聞くが、実は決まった場所に必ずエラーが入るというユーザーのポスターも見るので本当のところはわからない
【コンセンサス配列の精度】
  • PacBio:エラーがランダムに入るので20~30カバレッジでQV50(99.999%)も可能
  • ONT:ONTだけのデータでQV50を達成している結果は私は聞いたことが無い。たいていイルミナデータをエラー補正に使っているようである
とまあ、ここまで読んで、いやそんなことは無い!と思った方もいるでしょう。
あくまでバイアスがかかった私見ですので。
この辺の技術の数字は、すぐに変わる可能性があります。少なくともPacBioは、来年データ量が増える予定なので。この辺はONTとの競争ですよ

【ベースコール】

  • PacBio:装置から出てくるデータは既にベースコール済み
  • ONT:ベースコーラーが数種類あるのでユーザが適切なものを使用してベースコールをかける必要がある

【PacBioしかできない解析】
  • CCS:ライブラリを1分子DNAの単位で何度も繰り返し読むことができ、精度を上げることが可能。Iso-Seq(完全長cDNAを高い精度で読む解析)ができる
【ONTしかできない解析】
  • ダイレクトRNAシークエンス? 今どこまで現実的に使えるのか、知っているひといたら教えてください
【PacBioでもONTでもできる解析】
これはいつくかリストした後に考えてやっぱり消しました。というのは、「できる」という言葉の定義がひとによってさまざまだから。
バクテリアのゲノムアセンブリができる、と言っても、精度99.99%以上でできるというのと、ラフなドラフトでいいからできる、というのとでは全然違う。
HLAなどのロングアンプリコンシークエンスもそうです。求められる精度が6桁なのか8桁なのかで同じく「できる」というべきか。
あと、メチレーションや16SなどでもONTのデータを私は知らないのでできると言うのはやめました。
あと、意外と知られていないことですが、ノートPCにUSB挿してランができるMinIONも、データ解析には普通のサーバが必要です。

それでは技術以外の、それぞれの特徴を考えてみましょう!

【PacBioの特徴】

  • 装置型なのでシークエンスを行う環境が安定している
  • 実験プロトコルが用意されている
  • 解析パイプライン(マッパーやアセンブラ)がほぼ確立されている。これを使っておけば大丈夫的なツールがある
  • グローバルに数百台入っていて、国際プロジェクトにも正式採用されている(例えばG10K(脊椎動物のゲノムプロジェクト)ではPacBio、10XGenomics、Hi-Cのみが正式採用)ので信頼が高い
  • PacBioを使った研究の論文数、学会でのポスター数は圧倒的にONTのそれより多い(これは先行者だからかもしれません。来年が勝負の年かも)
【ONTの特徴】
  • MinIONはコンパクトで持ち運べる
  • 初期投資額が少なくて済む
  • 誰でもどこでもいつでもシークエンス、を謳っているが、「どこでも」シークエンスをするとデータにバラつきが出やしないか?(逆に、誰がどこでランしても一定のデータが出てくるなら凄い)
  • ユーザーコミュニティの中からプロトコルや解析ツールが作られる、ボトムアップなイメージ。NGSは昔からサードパーティのツールがユーザーから作られるものだが、ONTはよりその傾向が強いように感じる
  • バージョンアップのスピードが速い。PacBioもそこそこ速いけれどONTはもっと速いイメージ


と、つれづれなるままに書いてみましたが、いかがでしょうか?
結局はコストだと言われるかもしれませんが、シンプルにランニングコストで比較すればPacBioも負けていませんよ。アプリケーションによっては。

結論!
PacBioやONTのどちらも持っていない場合:

  • どうしても自分でランしたくて、ユーザーコミュニティでどんどん聞いて行くのが好きで、インフォマティクスにも強ければONT(ベースコールも何種類かあるのをお忘れなく)
  • 自分でランすることにはこだわらず、安定したデータを早く出したい、インフォを誰かに頼めるか自分でできれば、受託か共同研究でPacBio
  • 限られた予算を無駄なく効果的に使いたければ・・・ (答:     )

PacBioを持っている場合:
迷わずPacBio(笑) これ一本!

以上、2017年11月現在の私の意見でした。

2017年7月13日木曜日

gVolante でアセンブリを検証したくなるこれだけの理由!

Dovetailの話を数回にわたって続けましたが、ゲノムアセンブリを評価するとき、私もついN50 の値を比較してしまいます。
PacBioを使ってコンティグN50が数メガbpに達した!とか、
Dovetailを使ってスキャフォルドN50が何倍になった!とか。

でもこれは長さを評価する指標にはなりますが、アセンブリが正確にできているか、Completenessを評価するには別の指標が必要です。

アセンブリした結果の配列に、コアな遺伝子(代表遺伝子)がどれだけ含まれているか、そういった解析をする必要があるわけです。

ゲノムアセンブリの論文を読んだことのある方は、BUSCOとかCEGMAとかいう解析で、「Completeが何%、Fragmentedが何%、だからこのアセンブリはまずまず良い」なんていう文章を読んだことがあるかもしれません。
特に真核生物で、新しくゲノムを決めた、みたいな論文では必ずと言っていいほど。

このような解析を、GUIで簡単に解析できるツールが gVolante(ジーボランチ)です。
神戸理化学研究所の工樂さん、西村さん、原さんらの論文も、先日Publishされたそうです こちら

コンティグ/スキャフォルドN50の値が長ければ、それだけ連続配列が良く読まれている、と想像できます。ゲノム中にリピートが多くてかなりフラグメント化されていても、遺伝子の配列部分はそれなりに読まれているのではないか?
自分のアセンブリ結果は、どれだけの遺伝子を含んでいるのか?
そんなことを手軽にチェックできるのが、このウェブベースの簡易ツール「gVolante」

BUSCO、CEGMAの遺伝子セットのほかに、彼らが独自にまとめたCVG: Core Vertebrate Genesというのも脊椎動物評価用に使用できるようです。

使い方はとても簡単で、ゲノムアセンブリの結果FASTAファイルを、ウェブからアップロードして、「Upload File」ボタンを押す
数分待ってアップロードが終わったら、解析メニューを選びます
(私はデモサンプルにNCBIに登録されていたナメクジウオのゲノムアセンブリを選んだのですが、間違えてNon-vertebrate を選んでしまった! あれって原始的な脊索動物らしいですね。もうちょっとわかりやすい例を選べば良かった。。。 とはいえ、どんな風に動いて結果が出てくるのか、はわかりますよね?)

解析によって完了する時間は異なります。
私の場合、ナメクジウオゲノムアセンブリのCEGMA解析で、1日くらいで結果が出ました。
リンクをクリックすると・・・
素晴らしい。きれい!

結果はしばらくするとサーバーから削除されるそうなので、ダウンロードすることができます。
データは暗号化されてアップロードしたあと、すぐに削除されるらしいので安全です。

トライアルするならちゃんとサンプルを選びましょう、という教訓を得ましたが、自分でアセンブリしているデータがあるなら是非お勧めします!
お金かからないし、論文も出ていますので引用もできますし、何より簡単。
今のドラフトアセンブリのチェックと、これからスキャフォルドするかどうか迷っているひとにお勧め!

2017年3月6日月曜日

サイズセレクション無しのISO-SEQ Sequel向け


Iso-Seqというのはアイソフォームシークエンス。
数年前から(もちろんそのときはRSIIで)、完全長 cRNAをシークエンスすることで、スプライシングのバリエーションを一気に、連続配列情報として得ることが出来る。
これがIso-Seq です。
最近ではここに書きました
Iso-Seq アイソフォームシークエンスアップデート 植物

RSIIでのIso-Seqは、サイズセレクションといって、1kb、2kb、3kbなど、サイズごとに分けてライブラリを作製、別々のセルでシークエンスしていました。
と・こ・ろ・が・!


このたび正式にリリースされたSequel用のプロトコルでは、サイズセレクションしません。
というのも、Sequel用のケミストリーでは、ローディングバイアス(短いライブラリが優先的にZMWに入る、というバイアス)が、あまり影響しないらしいことが経験的にわかってきたからです。
RSIIとSequel、サイズセレクション無しのとき
Sequelのランはバイオアナライザで測ったときの波形に似ている

サイズセレクションせずに、Iso-Seqの同じライブラリをRSIIとSequelでランしたとき、RSIIは1kb程度のフラグメントがもっとも多く検出されます。
でも、Sequelでランすると2kbあたりに最頻値が現れる。
これはバイオアナライザで測ったときの形に似ているぞ。
ちなみにAMPureは1Xで行なっています。

というわけですが、マグビーズは推奨されています。
また、4kb以上の長い転写産物の出力を増やしたい場合は、4.5kb以上でサイズセレクションをしたほうが良いらしいです

そのたの目新しいこと・・・

  • AMPure精製は、0.40Xと1Xの2通り別々に行い、あとでモル比を合わせて混ぜます
  • PrimeSTAR GXLポリメラーゼを長鎖PCRに使います
  • P1を50%目指します(50%のZMWから使えるデータを出す)
  • 6時間Movieまたは10時間Movieで読みます(時間かかっても精度良いデータをたくさん出したければ10時間)
  • Movieをとる前に2時間シークエンスさせます(Pre-extensionと呼ぶ)
このような変更点があって、プロトコルもだいぶ変わりました。

Sequel では、RSIIで複数個のセルを使っていたIsoSeqが、1個か2個のセルで可能になりました。
今度のAACR(4/1~5)で発表があるかな。
注目してます。


Iso-Seqの新しいプロトコルはこちらから!


2016年12月31日土曜日

今年最後は・・・Quiver と Arrowの話 我ながら地味

2016年、大晦日です。
紅白見ながら書いてます。PPAP、ゴジラ、真田丸、ブラタモリ。
今年は面白いな。

さて今年最後の投稿は、地味なネタです。
QuiverとArrowの違いであまり知られていないこと
GitHubのサイトでもあまり詳しくは説明されていないので、少しお話しします。

【はじめに】
QuiverとArrowは、どちらも、CCS(Circular Consensus Sequence)を作るアルゴリズムに由来します。
QuiverはRSIIのデータ用、ArrowはSequelのデータ用の、コンセンサス配列作製アルゴリズムです。
SMRT Analysis v2.3 まではQuiverが標準搭載されていて、v3.x からはArrowになりました。
v3.xは、SMRT Linkというパッケージソフトになったのですが、引き続きSMRT Analysisという名前も解析用ソフトとして使われています。
SMRT LinkでもP6-C4のRSIIのデータは解析できるよう、Arrowも対応されました。

【QuiverよりArrowの方が精度が高い】
CCSを作るとき、Quiverベースのアルゴリズムでは、何回パスを重ねても平均QVフレッドスコア30くらいで精度に限界がありました。
また、ホモポリマーもうまく認識できないという欠点もあったそうです。
これは様々なクオリティ値を使ったエラーモデルが複雑すぎて余計ノイズになったとか。
そこで開発されたのがArrowというアルゴリズム。
トレーニングモデルやエラーモデルをより単純にし、またZMWごとの違いを考慮するようにした。(2016年アジアユーザグループミーティングより)

Arrowを使ったCCSは、パスを増やすとQVをフレッドスコア50、60に高めることが可能になりました。
Old = Quiver, New = Arrow

【QuiverよりArrowの方が使っているQV値は少ない】
普通、シークエンサーから出力されるリードの塩基には、その塩基をその塩基であろうとしたクオリティ値(QV)があります。
つまりAである塩基をAとコールしたとき、Cではなく、Gでもなく、Tでもなく、Aであったという「確からしさ」を表現する方法として、QVがあります。

RSIIは、ベースコールの結果、各塩基ごとのQVのほかに詳細QV (DeletionQV, InsertionQV, SubstitutionQV, SubstitutionTag, DeletionTag)という複数のQVを出力し、Quiverはこれらの情報も利用してコンセンサス配列を補正します。

Sequelは、これら詳細QVは出力せず、各塩基ごとの全体のQV(QUAL/FASTQ qv)のみを出力します。
(実データを見たことがあるかたは、現在のSequelリード BAMファイルではQVの情報が全て「!」になっているのに驚くかもしれません。この問題は次バージョンで改善される予定です)
ですがArrowではそもそも、塩基ごとのQVを使用しません!

ではArrowは何のデータをもとにエラー補正&コンセンサス作製をするのでしょう?
Arrowは、

  1. 各リードのシグナルノイズ比
  2. 各塩基のパルス幅の情報

この2つを使用して、マッピング後のコンセンサス配列を補正して作ります。
これらの情報は今もリードBAMファイルに記載が有ります。

P6-C4のRSIIデータも、Arrowを使えます。
このときは、RSIIデータ(bax.h5)をSequelのBamファイルに変換し、リードごとのSN比と各塩基のパルス幅情報を使って、Arrowが使われます。
結局、補正に使うデータを単純にしたほうが精度が上がったということでしょう。

今後、Arrowで塩基ごとのQV(詳細QVではなく、全体のQV)が使われるようになるかは、現在のところ何ともいえません。
精度が向上するようであれば、使われるようになる可能性はあります。


ああー、もうすぐ2016年も終わります。
しかし笑ったのは、白組の方がダントツで票が入ったのに何故か赤組が勝った、というアメリカ大統領選挙よりも摩訶不思議な紅白歌合戦。
明日の新聞で説明あるかな?

また来年も宜しくお願いしまーす!
2月7日の「PacBioセミナー@秋葉原」も宜しく

2016年11月23日水曜日

IGVでの格好いい見せ方の、もとデータ

前回、IGVでPacBioを格好良く見せる方法を紹介しました。
その時例に使ったデータは何かと言うと、Sequelでヒトゲノム NA12878 を10xくらいの深度で読んだものです。
具体的には、ここのデータ
ライブラリの長さは25kb、Blue Pippinを使って15kbにサイズセレクション

  • 使用したSMRT Cell 1M の数:10
  • トータルラン時間:60時間
  • 出力塩基数:32.8 Gb
  • リード数:340万本
  • リード長のN50 :11.823 bp

このとき使用した試薬は、旧バージョン、v.1.2 のもの
なので今ならセルあたりの出力はもっと多いはず。

とにかくこれでヒトゲノムの10倍のデータが出た。

このデータをヒトゲノムにマップするのですが、ここで使ったツールは、NGM-LR + PBHoney
PBHoneyは構造変異を検出するツールです。

NGM-LR って何? という方、これはロングリード用のマッピングツールです。
Next-Gen Mapping tool for Long Read、だったかな?何かそんな名前。
Githubにもあるので、興味のある方はここからどうぞ。

PacBioリードは1本が長いので、例えば 1kb 程度の挿入・欠損をまたいで読むことが可能。
しかし通常のマッパーでは 1kb の変異を考慮してほかの配列を綺麗にゲノムにマップすることができなかった。NGM-LRは、二箇所に分かれてマップするような、ロングリード独特な性質をフルに発揮できるマッピングツール。
BWAとNGM-LRのマッピング結果 Aaronのスライドより
さて、こうしてマッピングした結果は、もちろん参照できます。

先ず、DNAnexusのデモアカウントと作りましょう!
いえいえ、決して私はDNAnexusの手先ではありません。
仕方無いんです。ここにアクセスした方が、データ参照が楽だから。

私はアカウント持っているのですが、ロングインするとこんな感じです。

左下の、"PacBio Sequel Data" というところをクリックします。
これが例の10カバレッジのSequelデータ
"Sequel Data" を開きます
NA12878.reads.ngm.bamというファイルが、マッピングファイルですが、20Gbもあって大きいです。
そこで、indexsession ファイルをダウンロードします。
これは、IGVに取り込むと、DNAnexusのサーバにアクセスしてデータを表示してくれるインデックスファイルです。
IGVはこのように、必ずしもローカルに大きなサイズのマッピングファイルを持っておく必要がありません。

さ、IGV を開きましょう。前回のあれ、ですよ。わからないひとはちょうどこの前の記事をチェック!
ゲノム配列が "Human hg19" であることをチェックして(違ったら Human hg19 を選ぶ)

File > Open Sessions 
今ダウンロードした indexsession ファイルを選択。
何か聞かれるけどOKをする。
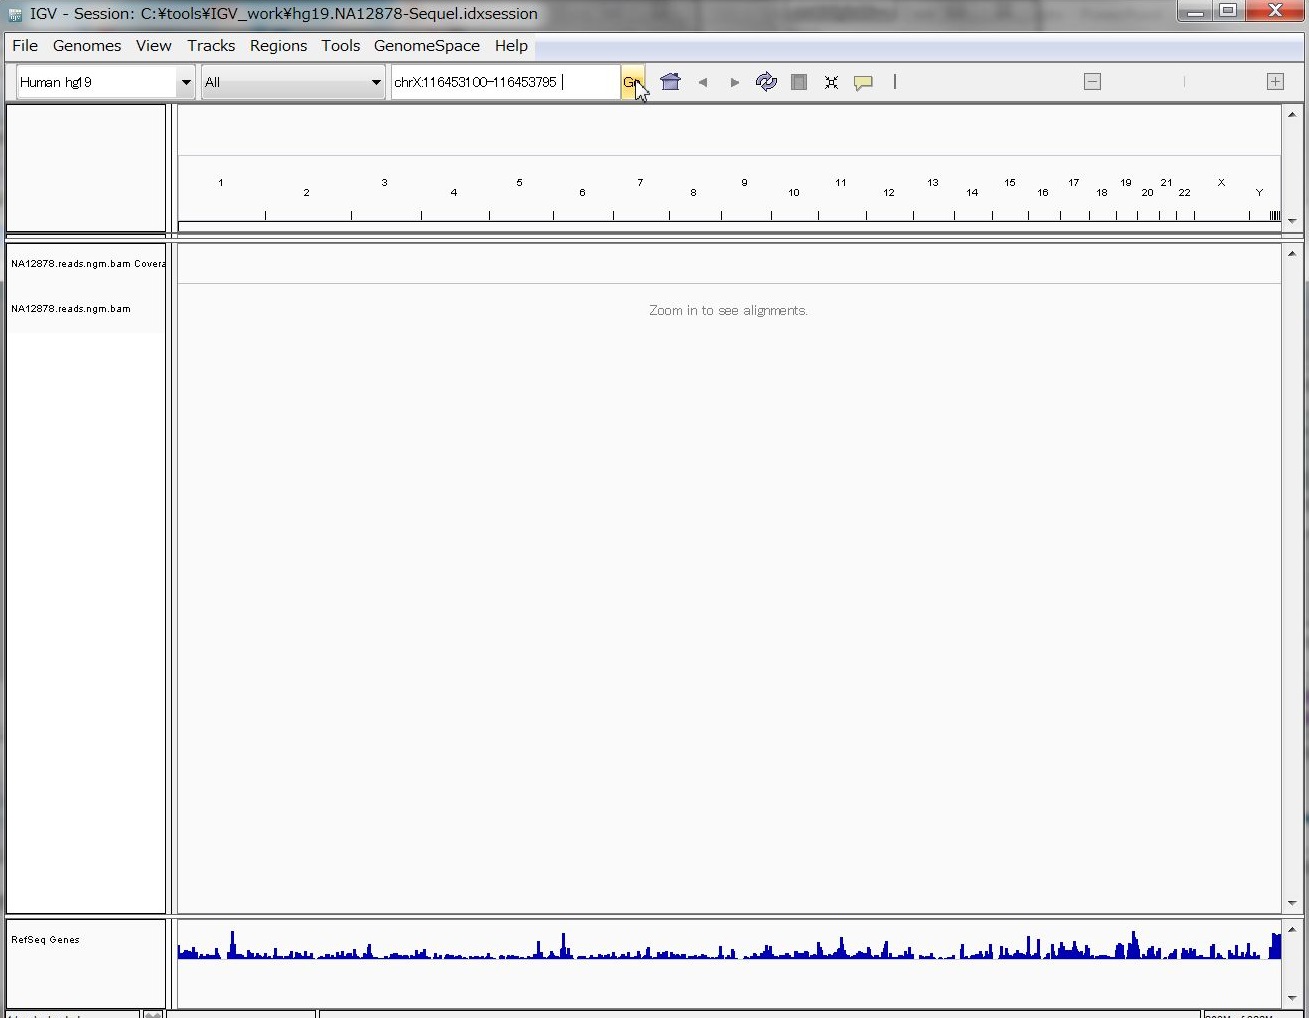
ゲノムのポジションを入力する場所に、試しに、
chrX:116453100-116453795
と入れてGo!
いぇーーーーい !!

ほかにもチラッと見てみたいポジションは、こんなところかな?
chrX:116454160-116454859
chr10:92213800-92216245

InDelの変異箇所は、先の DNAnexusのアカウントから、
NA12978_Output を選び、ここから ... del.bed  ins.bed ファイルをダウンロードしてきて、取り込むと面白いかも!

いかがだったでしょうか?


2016年11月22日火曜日

IGVでの格好いい見せ方

Integrative Genomics Viewer (IGV) といえば、NGSやっているひとなら一度は聞いたことのある、ゲノムビューワーですね。
フリーで使えてさくっと見るのにはとても便利。
先日、本社とのウェブミーティングで、このIGVを使って、PacBioのデータを格好良く見せる方法を教わりました。
皆さんも知っていると便利なツールだったのでシェアします!

まず、普通にIGV(ここではv.2.3.88)を使ってPacBioのアライメントファイルを開くとこう見えます。
ぜんぜん綺麗じゃない! 
SubreadをアラインしているのでInDelエラーが目立ってるんです。

これをある方法を使うと、このように見ることができます。
とてもすっきりしてますねえ。

これ、Development Snapshot版を使っています。

先ず、バイナリを落としてきます(上図カーソルの場所から)。
Zipを解凍して、中に作られる、igv.batファイルをダブルクリックして起動させます(テスト環境はWindows 7&10)

最初は、これまでIGVで表示していた、デフォルトで、PacBioアライメントが表示されるかもしれません。ここで、View > Preferences を選択
Alignmentsタブを開き、とりあえず以下のように数字を入れてみて下さい。
特に、
  • Label indels > 1: 2塩基以上のindelに表示が出る
  • Hide indels < 20: 19塩基以下のindelは表示されない

としてチェックを入れて、OKします。

ちなみに、普通のIGV(v.2.3.88)でも、これに似た画面はありますが、上記オプションはありませんね。
これはv.2.3.88のIGV
さてこれで、先ほどのような綺麗な表示ができるようになりました!
こんな感じに。

しかし例えば、下図のような場所があったとします。
大きなDeletionがある領域です。
そのほかにも、小さなInDelが点在するようですね。
では、Allele Frequencyが小さいものはエラーの可能性が高いので、除くことにします。
例えば、35%以上のアレルだけを残したい、そんな場合は、再び View > Preferences > Alignments から、Coverage allele-fraction threshold: を、0.35としてみる

そうするとこんなにすっきりします!
大きなDeletionがあるところの上流側に、ハプロタイプ(ここでは黄緑のA、リファレンスはT)があるのに気がつきます。
この黄緑色Aを右クリックして、Group alignments by > base at [塩基の場所] を選択
するとこうなります
大きなDeletionと上流SNV(T -> A)がリンクしているのがわかると思います。


IGVはあくまでビューワーですので、これ自体が解析するソフトではありませんが、データを見せる方法としてはとても使えるツールだと思います。

尚、この機能は、PacBioのプログラマー、Aaronさんによって作られました。

さて、次回は、この例に使用したヒトゲノムデータについてお話ししたいと思います。
多分誰でも使えるデモデータ、のはず。。

2015年9月19日土曜日

PacBioでHLAシークエンス

先日、水戸で「日本組織適合性学会大会」があり、行ってきました。
以前からPacBioでHLA遺伝子をシークエンスしている先生の発表があったのと、この業界についてはほとんど素人だったので、勉強もかねて。学会についてはこちら

この学会では、輸血・臓器・造血といった、移植全般の「組織適合性」に関して、大学研究者から医療関係者、日本赤十字、現場のティシュータイパー、といった方々が集まって最新の技術を発表したり、現場の問題点を提起したり、活発に議論が交わされていました。

企業からもタイピング受託会社や、タイピング装置やキットの輸入商社、メーカーなどが参加。
学会の規模は、そうですね、実感としては「ゲノム微生物学会」くらいの大きさかな。

さて、HLAについて、もし基礎的なバックグラウンドを知りたいかたは、先ほどの学会ホームページのここがとても詳しいです。
私もこのページで勉強しました。

ざっくり言うと、移植のときなどにドナーとレシピアントとの間で、適合するかどうか、は、HLAという遺伝子のSNPの型で決めるんです。
ひとつの遺伝子にSNPがいくつもあって、その組み合わせで、何千通りというハプロタイプができる。
HLAはA、B、C、DRB、DQB、DPBなどなどいくつかあり、タイピングに用いられる遺伝子はだいたい決まっています。

その遺伝子のSNP型を、ビーズ、PCR、またはシークエンスで判定するということ。

今、HLAタイピングの主流はビーズです。
その理由は、①簡単、②低コスト、③世界中でバリデートされている
から。
ビーズで検出すると、同じ遺伝子上でも離れた場所にある2つのSNPのハプロタイプはわからない。
これをAmbiguity問題、といいます。
シークエンス法に比べると、精度は落ちる。

GenDX社のウェブサイトから
シークエンス法の場合、先ず一旦遺伝子の全長、または変異の高い場所をPCR増幅します。
プライマーはもちろん保存された領域に設定される。
このプライマーでちゃんと増えたら、次に断片化する。
断片化した後、シークエンスする場所を濃縮するか、あるいはそのままシークエンスする。

あれ? 何で断片化するの?
と思ったかた、あなたの頭はPacBio向きです。

PCRで増幅したHLA遺伝子は、だいたい4kbから10kbかそれより少し長いくらい。
PacBioならそのまま読めますよね。
そうです。読めます。
断片化するのは、ショートリードのときだけ。

NGSとHLAタイピングをもっと詳しく知りたい!という方はこのレビューがおすすめ

Hosomichi et al., (2015) The impact of next-generation sequencing technologies on HLA research. J of Human Genetics.

HLAタイピングの方法、ソフトウェアの種類、長所短所などがまとめられています。

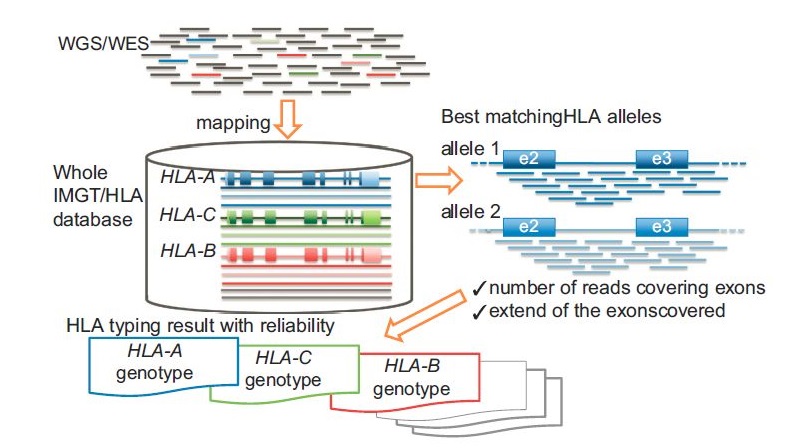
シークエンスされたデータは、IMGT/HLAデータベースに登録されている各HLA遺伝子の配列にマッピングされます。マッピングのアルゴリズムは、ツールごとにいろいろあるようです。
有償ソフトウェアなどは各社独自のマッピング方法を開発して、精度を上げています。
そして、アレルごとにコンセンサスを出して、アレルの型を決める
Hosomichi et al. (2015)

PacBioの場合も、長いリードで遺伝子全体を読みますが、そのあとデノボでクラスタリングをつくり、アレルごとにコンセンサス配列を作ります。
先にデータベースにマッピングするのではなく、アレルごとの遺伝子全体のコンセンサス配列をつくってから、データベースを参照して型を判定するのです。
(正確には、遺伝子全体を読むのはClass Iと呼ばれる比較的短い、とはいっても5kbくらい、の遺伝子。Class IIと呼ばれる遺伝子群は、10kb以上あるが、それくらい長いとPCRすること自体が難しい。そこで遺伝子の一部を増幅することが多い)


このように、NGS、特にPacBioで読めば、Ambiguity無しに、正確なHLA型を判定することが可能です。
でも、タイピングにかかるコストは若干高め。
ライブラリ作製にかかる手間は、ビーズ法に比べれば、かかる。これは認めます。

では、どういう場合に、PacBioがHLAタイピングに使用されているのか?

アメリカには、Histogenetics社という、HLAタイピングの専門会社があります。
この会社はMiSeqを47台、PacBioを1台保有し(もちろんキャピラリーはたっくさん保有)、Sequence Based Typing (SBT)をガンガンやっています。
顧客は主にNMDP(National Marrow Donor Program)のようなバンク。
MiSeqを使ったタイピングでもキャピラリーを使ったタイピングでも、データベースに合わなかったり新規の可能性があるような場合、PacBioの登場。
昨年はまだ慣れていなかったテクニシャンも、もうPacBioかんたーん!って言っているそうです(Histogenetics社のCEO曰く)。
タイピングの方法も、自分たちで作ったデータベースに独自のプログラムを使って、行なっているとのこと。
ここはPacBioでのHLAシークエンスに一番ノウハウがあると思いますが、いかんせん、企業なので情報はあまり出てこない。

では、イギリスのAnthony Nolanはどうかな?ここは公共機関。論文もあります。
Mayor et al., (2015) HLA Typing for the Next Generation. PLOS One.

新しいアレルも発見されています
Hayward et al., (2015) The novel HLA-B*44 allele, HLA-B*44:220, identified by Single Molecule Real-Time DNA sequencing in a British Caucasoid male. Tissue Antigens.

人類遺伝学会などでも関連する発表がありそうな予感。
PacBioの可能性が試されるときです!


2015年8月8日土曜日

DNANexus

「猛暑日」
日中の最高気温が35度を超えるとこう呼ばれますが、東京は今日8月7日で、1週間連続の猛暑日だそうです。
5年後の東京オリンピックは8月6日から。こんな暑い中、屋外競技は厳しいだろうなあ。
何かと話題の新国立競技場も、東京ドームみたいに、完全エアコン&屋根付きにすれば良いけど。
そうなったら建設費はいくらになるのかな?
ちなみに東京ドームができたのは1988年。バブルの真っ只中、建設費は350億円だったそうな(ここにまとめあり)

さて、私がいまバイオインフォ関連で気になっているのは、前回も紹介したDNANexusという会社。
ここはGoogle Ventureも出資しているアメリカの会社で、クラウドでの解析パイプラインがメインです。
この会社は、FalconによるPacBioデータのアセンブリパイプラインを提供しています。
先月のPacBioユーザーグループミーティングでも発表していました。
Falcon、ってインストールがとても複雑なんです。
環境依存が多くて、なかなか素人には手が出ない。
そもそもヒトゲノムレベルのゲノムサイズをFalconアセンブリするには、それなりのクラスターサーバーが必要。
でもDNANexusは、アマゾンクラウドを使っているので、理論的には世界最大級のスパコンを使うことができる、というわけ。

Falconアセンブリは、HGAPのようにエラー補正ステップが最初にあります。
このステップが一番計算量を消費する。

DNANexus社のスライドより
上記には、HGAPの最後のステップであるQuiverは含まれていません。
Quiverもそこそこ時間がかかります。

ユーザは、アセンブルに必要なPacBioの生データ(bax.h5とmetadata.xml)を、DNANexus社のツールでアップロードします。
あとは、こんなパイプラインをポチっと。

出力データは

  • エラー補正後の生リード(Pre-Assemblyリード)
  • Primary AssemblyのFASTAファイル
  • Alternative Contig(バブル)
  • 各ステージでの中間ファイル 
結果がまずければ、例えばステージ2から再開できるように、中間ファイルを保存しているそうです。

その後、Quiverをかける。
Quiverというのは、HGAPでも使っていますが、エラー補正をする前の生サブリードを、アセンブリ後のContig配列にマップして、生サブリードの持っているクオリティデータを使いながら、Contig配列を補正していくプログラムです。

さて、ここまではアセンブリの話。
もちろん、構造変異解析のパイプラインもあります。

皆さん、Parliamentというのをご存知でしょうか?

Parliamentとは、構造変異解析のツールで、BreakdancerやPBHoneyなどに広く使われているそうです。

Illuminaデータ、PacBioデータ、Irys、Nexteraなど様々なデータに対応します。
例えばイルミナデータとPacBioデータがある場合、数ある変異検出ツール(DellyやCNVator)で変異があっただろうとされる場所をまとめて、そこのみをローカルアセンブリして構造変異の場所を出力する。
「数ある変異検出ツール」というのを、DNANexus解析パイプラインでは、Parliamentひとつでまとめてしまって、簡潔なものにしています。
DNANexusのスライドより

今のところ、イルミナ用の構造検出ツールは数が多く、PacBio用にはPBHoneyのみしか無い。
なので、Parliamentを最大限生かすには、イルミナデータがあったほうが良いとのことです。
しかし今後は、PacBio用の構造変異検出ツールも増えてくるだろうから、期待したいですね。

---------------------ここまではDNANexusの話------------------------

さて、せっかく構造変異の話をしたので、ついでに宣伝です。

前にもお知らせしましたが、SNVとかIndelとかを見つけた後に、それがどのくらい意味があるものなのか、を調べるのは大変だけれども重要なこと。
データベースに照らし合わせてフィルタリングするのが普通でしょうが、このIngenuity Variant Analysisが追加で持っているデータベースはちょっと違う。
何百人ものPhDホルダーが、10年以上かけて文献から抽出した、パスウェイ・ネットワーク情報です。
これ自体でも価値のあるデータベースでしょうね。

このIngenuity Variant Analysisは、「変異情報から病態・疾患情報や機能・パスウェイとの関連性について、【短時間で、簡単に、信頼性の高い解析結果】を出力するツールです。


キャンペーンお申込みwebページはこちら

Ingenuity Variant Analysisについて詳しくはこちら
応募してみたいが、できるかどうかわからない方、IVAの概要説明をご希望の方は、下記までお問い合わせください!
トミーデジタルバイオロジー(株)
info_ap(AT)digital-biology.co.jp  (AT)の部分を@にして下さいね。


2015年4月5日日曜日

PacBio-LITS PacBioでターゲットリシークエンス 1

今日は4月5日、東京は雨が降って、せっかくの桜も散ってしまっています。
今年ほど、桜満開の時期が短いと感じたことはなかったなあ。
7月のNGS現場の会に向けて、「お花見メタゲノム」の試料採取が、全国で行なわれているみたいですね。
私のFacebookの友人も、採取の様子をいろいろアップしていまいた。
結果が楽しみです!

さて、今日は、PacBioではあまり今まで話題に出てこなかった、ターゲットリシークエンスの話

リシークエンスには大きく分けて、全ゲノムリシークエンスと、ターゲットリシークエンスの2種類あります。
前者はゲノム全体をガッツリ読む方法で、後者は例えばExomeなどのような遺伝子のエキソン領域だけを濃縮して読む方法です。
濃縮キットは(「エンリッチ」キットとも呼ばれますが)、ゲノム配列を断片化したあと、

  1. 取ってきたい(シークエンスしたい)配列領域にデザインされたプローブをハイブリして、エンリッチする方法
  2. 読みたい配列の両端にPCRプライマーを設計して、そこだけPCR増幅して、取ってくる方法
の2種類あります。
ハイブリ方式か、PCR増幅方式か

市場で良く聞く製品だと、SureSelect (Agilent社)や、SeqCap EZ (Roche社)などは、ハイブリ方式
Ion AmpliSeq(LifeTech社)は、その名の通り、Amplification(増幅)方式

これまで、どの方式、どのキットも、PacBioのロングリードには対応していませんでした。
PacBioで読むには、エンリッチした後の配列長が、そこそこ長くなくては意味が無い!
そんな中、ハイブリ方式で6kbフラグメントのターゲットエンリッチメントに成功したのが、この論文
Wang et al. BMC Genomics (2015) 16:214

Baylor College of MedicineのDr. Min Wangらは、彼らのエンリッチ方法を使って、Potocki-Lupskiシンドロームの患者に見られる、chr17p11.2の複雑な構造変異、Low Copy Repeats (LCRs; またはSegmental Duplications )のブレイクポイントを、検出することに成功しました。

そもそも何で、ゲノム全体を読まずに、特定の箇所をエンリッチして読むのか?
興味のある場所がゲノム全体の数%だったら、そこだけを濃縮(エンリッチ)してきて、PacBioの超ロングリードでがっつりカバレッジ稼いで読めば、かなり消耗品を節約できます。
ゲノム全部を読む必要が無いひとにとっては、エンリッチメントはかなり効率的な手段なのです。

彼らは、Roche NimbleGen社の、SeqCap EZ エンリッチメントキットを使用して、つまりハイブリ方式で、ターゲット領域を濃縮、PacBioで読むことに成功しています。
この方法は、PacBioのアプリケーションノートでも紹介され、今後、本格的に広まる予感がします。

通常、SeqCap EZのプローブは、200bpのフラグメントに対してハイブリするようデザインされています。
これを、彼らは、6000bpのフラグメントでも可能であることを示しました。

まず、ゲノムDNAを、G-tubeで10kbに断片化します。
その後、Blue Pippinというサイズセレクション機器を使ってゲル泳動し、5~9kbの長さのフラグメントだけを抽出します。
SeqCap EZ アダプターをつけたあと、増幅し、プローブとハイブリします。
ハイブリしなかったDNA断片(濃縮ターゲットではない部分)をWashして捨て、ハイブリした断片(濃縮ターゲット)を回収します。
もう一度、回収DNA断片を増幅し、それからSMRT Bellライブラリ作製にかかります。

このようにして、ハイブリ方式で濃縮したDNA断片から作製したライブラリを、実際にシークエンスしたデータは、かなりの数のライブラリが6kbのサイズを保っていたことを示しました。
実際にHG19ヒトゲノムリファレンスにマップしたところ、マップされたReads Of Insert(ライブラリの長さにほぼ等しい)の平均長は、4.3kb~4.7kb
これだけの長さのリードを濃縮できた例は、私は聞いたことがありません。

論文に出ているとはいえ、まだこのプロトコルはPacBio公式ではありません。
もし試してみたい方は、うまく行かない可能性も無くは無い、ということを頭に入れて、お試し下さい。

どんな遺伝子でもエンリッチできるのか?
SeqCapEZ のプロトコルにはどんな工夫があるのか?
データ解析ツールはどんなふうに使ったら良いのか?

などなど知りたいことはありますが、またフォローしていきますのでお楽しみに!


2015年3月31日火曜日

Structural Variant - 構造変異 PacBioでヒトを読んだら

PacBioのリードは長い
これはもうわりきっていることですが、長いリードを使ってできること、のひとつ
「Large InDel, Structural Variantの検出」を、ヒトゲノムでやるのはなかなかチャレンジングなテーマです。
なぜかと言うと、昨年(2014年)まで、
  1. デノボアセンブリするにはものすごい計算量が必要だった
  2. 平均リード長が、長いといっても5Kb(P4)、7Kb(P5)で、長いリードでゲノムカバレッジ上げるのにセル数がたくさん必要だった

もちろん、今(2015年)でも、PacBioでヒトゲノムやるにはバイオインフォの専門家が必要です。
誰でも簡単に楽チン解析!というわけにはいかんのです。

そんな中、韓国では、Macrogenという会社が、PacBio RSII を2台、HiSeq X10を、大人買いして、韓国人ヒトゲノム解析を行いました!
PacBioを買った、というプレスリリースが昨年10月だったから、たった5ヶ月余りで結果を出した、スピード感が半端無い。

以下、画像はPacBio AGBT 2015のYou Tubeからスライドキャプチャー
(その場面から観たいひと向けに時間も表示しておきます)

PacBioRSIIとHiSeqX10を使って、Blood Cell lineとGerm CellのBACを読んでいます
が、デノボアセンブリのメインはあくまでPacBioのデータ
281個のSMRT Cellでゲノムサイズの72X分のデータをP6C4で出力
Falconを使ったDiploid デノボアセンブリを行い、N50が7.3MbのContigを記録!
まあ、アセンブル結果は、PacBioすごい!の一言になるのでもう聞き飽きているひともいるでしょうね

デノボアセンブルの結果は、BACのアセンブル結果と共に、GapをFilling
BioNanoのIrysも使われたそうです
でもこれについては、本プレゼンでは軽く触れる程度です
IrysとPacBioRSIIは、親和性が高いと個人的には思っています
今度機会があったら、両方持っているユーザに聞いてみようっと

さて、本題のStructural Variant
先ずPacBioで作ったContigを、GRCh38リファレンスゲノムに対して、Symapでアンカリング
次に、アンカリングされたContigと、染色体配列を、アライメント
構造変異があったところは当然アライメントされないでしょうから、そういう箇所を "In-House Tools" を使って検出
だそうです。
In-House Toolsが知りたい!
まあ、そのうち論文になるのでしょう。そのときを楽しみに
SyMAPというのは、 比較ゲノムで用いられるツールのひとつです。
異なる種のゲノム(Contigも)配列を比較して、どこが一致しているのかをビジュアルで見せてくれるプログラム サイトはここ
フリーツールですよ

彼らはこうして、ヨーロッパ人には無い、アジア人特異的な構造変異、InDelなどを次々に発見!
おそらく、今年のアメリカ人類遺伝学会ではもっと、エキサイティングな発表があるでしょう。
韓国以外のユーザからも、もちろんね


で、Structural Variant関連でもうひとつ
こちらは前回も紹介した、CSHLのMcCombie博士らのHer2陽性乳がんセルラインのデノボシークエンスの発表

SMRT Cellのパフォーマンス、こちらはオンタリオがん研究所のデータですが、どんどん長くなっているのがわかります。
で、今は平均11kb、1セルあたり1Gbを出力していますね
きれいなデータです
これくらい、出ることもあります

 ここでももちろん、構造変異を見ています

Lumpyというプログラムは、恥ずかしながら知らなかったのですが、論文になっているようです。
ソフトクリップアライナーでアライメントされたBAMファイルをインプットとして、ゲノム位置が離れてマップされているリード情報から、構造変異の箇所を特定するツールです。
アライナーは、NOVOALIGN、BWA-MEM、YAHAなど、"Long Read" でもアライメントできるもの(PacBio用という意味ではないことに注意)を使用
LUMPYは、Illumina用に開発されたようで、ここでも彼らはIlluminaデータを使って、BWA-MEM+LUMPYで、大まかなマップ位置を確認
その後、(あまり詳しく述べていませんが)PacBioを使ったローカルアセンブリ


Her2(Human Epidermal Growth Factor Receptor type 2)遺伝子は、ヒト上皮細胞増殖因子受容体と良く似たタンパクを作ります。
このHer2タンパクは、正常細胞にも存在し、細胞増殖に関わっています。
乳がんの患者さんのがん細胞では、正常細胞に比べて、過剰に発現・活性していることがわかってきたそうです。 ここにくわしい
Her2と言えば、これを狙った分子標的約、ハーセプチン(これは商品名、正式名はトラスツズマブ)が有名です。

薬学部卒でもない私が何でこんなこと知っているかと言うと、前職で扱っていたパスウェイソフトウェアで、薬とタンパクのパスウェイをいくつか作っていたからです!
こんなときに役立つとは。

ま、話を戻すと、Her2陽性乳がん細胞で、17番染色体上のHer2遺伝子が過剰増幅したときのメカニズム、
8番染色体との転座による増幅、
Her2周辺の遺伝子と共に増幅、
部分的にInversionなどされて増幅、
などの様子が、今回PacBioを使ったシークエンスで確認できた。

この乳がんセルラインは、もともとHer2が過剰発現している細胞株だとわかっているから、これをシークエンスレベルで確認できただけ、と言ってしまえばそうなんだけど、
今あるテクノロジーでここまではっきり確認できるのはPacBioのロングリードがあればこそ、でしょう!

オンタリオがん研究所は、カナダでもトップのがん研究機関。
ここにPacBioが入ったのは2011年とかなり初期です。
当初、ヒトゲノムに挑戦するのはかなり大変だったけれど、今ではこのように現実味が出てきた。
まだまだセル数はたくさんいるけれど、これでがんの遺伝子メカニズム・構造変異が発見できるなら、決して高価なプロジェクトではないのでは?
これまでのテクノロジーでは隠れていた、大発見があるかも知れませんね。