2012年2月29日水曜日

ターゲットリシークエンスと変異 2

どれくらいのカバレージがあればSNPを検出できるのか、というのは興味のあるところだと思います。
以下はPacBioテクニカルノートに記載している方法です。 (うまく説明できていないかも)
同じゲノム位置の、ベースコールの集合(どれも同じQV)を2つ考えてみます。 1つは100%ワイルドタイプで、もう1つの集合は(50:50または80:20の)変異を持っているとします。 ランダムに2つの集合からベースコールをピックアップするとき、その数はそのゲノム位置でのカバレージと同じ意味です。 
2つのピックアップしたサンプルを、Fisherの正確度検定にかけて、どれだけ有意に変異を検出できるか(帰無仮説は、ワイルドタイプの集合からのサンプルも変異がある集合からのサンプルも、差はない)検定をします。

p-valueが0.05未満のとき、有意に検出できるとし、ピックアップする数を1から50に増やしながら(つまりカバレージが1から50のときまで)1000回繰り返します。
このようにしてシュミレーションした結果、(p-valueが0.05未満になるときの数)/1000 = 検出率とすると、0.95以上になるには、
50:50のサンプルでは、CCS-3パス(Q17)のとき17X、CLRフルパス(Q8.24)のとき29X必要で、
80:20のサンプルでは、CCS3-パスのとき55X、CLRフルパスのとき135X以上必要であることがわかりました。 
この数値はもちろん理論値です!

さて、以上をふまえて、ターゲットサイズ(アンプリコンのサイズ、インサートのサイズ)ごとに、SNP Detectionに必要なSMRT Cellの数を計算した表があります。
計算式はこちら

で、tはターゲットの数、cは最低必要なカバレージ(先の理論値より若干高めに設定)、βはサンプルバイアス(N倍くらい多めに読まないと期待される変異は取れないんじゃないか、という値)で3に設定。 tcβで必要リード数が計算されますので、それを前回の書き込みで紹介した、Cellごとの、ある程度クオリティが期待される「使える」リード数=rで割ると、必要Cell数が計算されます。
CLRフルパスの場合、500bp、1000bp、2000bp、の3パターンで、ターゲットの数はそれぞれ500、2000、1000です。 CCS-3パスの場合は、500bpと1000bpの2パターンでターゲットの数は500と2000です。 両方とも変異の割合を50:50と80:20で出しています。
(Table4の20% variantの500bpの、Estimated # SMRT Cellは2ではなくて3が正しい)
この2つの表からわかることは、500bpのターゲットでは、ターゲットの数が500のときCLRとCCSはどちらも1つくらいしかCellを必要としない、ということ。
でも、この表には無いですが、ターゲットの数を500から1000、1500、2000と増やしていったらどうなるのか、上記の式に代入して計算してみました。
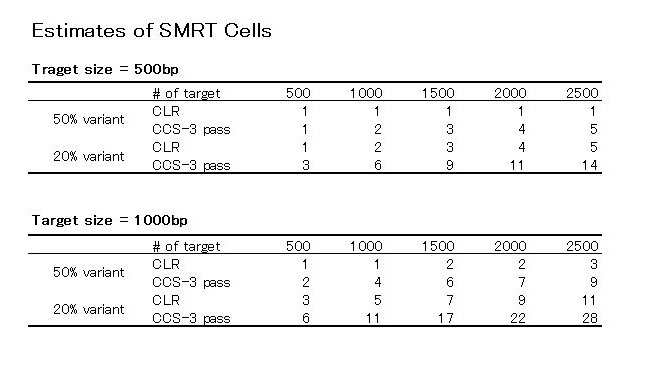
ターゲットサイズ500bpのときと1000bpのときの2パターンでCLRとCCSのどちらがコスパがいいか?
ターゲット数が増えるほど、CLRでやったほうが、変異割合が50%のときも20%のときも少ないCell数で済む、と言えそうです。 
Again, あくまで理論値です!

では実験値ではどうなのか。
Agilent SureSelectを使ったターゲットエンリッチメントの例があります。

続く

2012年2月21日火曜日

ターゲットリシークエンスと変異 1

ゲノムの変異、広い意味での変異を見つけることは、次世代シーケンサーならではのテーマでしょう。

オーソドックスなのものでは一塩基変異(Single Nucleotide Variant)を見つけること。
ショートリードの世界では例えば、BWAでリードをゲノムにマッピングしてからSAMToolsでSNVを検出する、というようなパイプラインがほぼ確立されているので、多くの研究者の方がチャレンジしているのではないでしょうか。

SNVがコーディング領域のアミノ酸を変えればタンパク質の機能を、遺伝子の転写制御領域にあればmRNAの転写を、直接変化させます。

他にも、遺伝子や重要配列をごっそりDeleteしてしまう変異もありますし、何コピーもAmplifyしてしまう変異もあります。

あとは、染色体単位でのTranslocation、転写・遺伝子レベルではキメラRNAやFusion Gene、新規のAlternative Splicingなんかも変異になるのでしょうか。

ショートリードでは、SNVはそのまま検出可能ですが、大きなDeletion / Insersion、Amplificationは難しいでしょう。 
リードは長くても100-150bp(HiSeq、MiSeqなど)です。
マッピングアルゴリズムにもよりますが、10塩基以上のInDelを検出できるツールを私は知りません。(あったら教えて) 

そのSNVですが、ショートリードの世界では良く、カバレージは最低何X必要などと言われます。
これについてはいろいろな意見があると思いますが、以前学会や展示会で聞いて回ったところ、普通のDiploidのジェノタイプ(つまり50:50)には20X、ちょっとレアなSNV(80:20)には100~120Xは必要だと言われた記憶があります。
根拠が薄くてすみません。 でも今のHuman Exomeなどでは、HiSeqやSOLiDを使えば普通にこれくらいのカバレージは「平均で」出ますね。


では、PacBioのシーケンスではどうでしょうか?
SNVを見つけるには、どれくらいのカバレージが必要なのでしょう?


このテクニカルノートは最近出されたものです。
面白かったのでサマリーを紹介します。

まずは最初に単語の説明から
Continuous Long Read (CLR): 長いインサートを一本で読んだ時のリード
Circular Consensus Sequencing Read (CCS): 短いインサートを数回読んだ時のリード

CLRとCCSにはどんな特徴があるのでしょうか?

フルパスで一回読んだだけのCLRは、精度85-90%、塩基あたりのQVは8.25-10で、平均リード長は2kb、これを10XのカバレージにするとQVは30以上(99.9%以上)になるそうです。 

一方CCSは、2回パスを読んだものでリードの精度が97%、3回パスで98%、5回パスで99%ということになっています。 5回読めば1kbあたりのエラーは10塩基未満に抑えられるということ。
塩基のQVも、2パスで13、3パスで17、5パスで20以上となり、なんとか耐えられます。
10XのカバレージにするとQVは50以上になるそうです。

これと、重要なのが、SMRT Cell 1つで出力される「使える」リード数です。
「使える」リードとは、CLRでは1回のフルパスサブリード、CCSでは3回以上のパスで出力されるリード、と定義してみます。
45分のムービーを2回撮ったとき(C2ケミストリー)の設定です。
CLRは、500bpインサートで250,000本、1kbインサートで100,000本、2kbインサートで50,000本。
CCRは、500未満bpインサートで40,000本、500bpで30,000本、1kbで15,000本。


ここで問題: あれあれCLRの500bpインサートが25万本を出力しています! ZMWは15万/Cellしかないのに。

答え: サブリードですので、1 SMRT Cell あたり2以上を出力している(かもしれない)のです。
CLRで500bpのインサートを完璧に1周したら2本のサブリードが出ます。
45分のムービーなので十分ありえます。

続く・・・


2012年2月18日土曜日

以前のコメント

以前のMovieってという記事にて、コメントがありました。 ありがとうございます。
気づくの遅すぎですね。 すみません。 今度からコメントもチェックしようっと。


①何故1度の撮影でZMWは75,000ウェルしか観測できないのか、照明系かCMOSサイズの問題だろうか。
A: なぜでしょうね。 もっと大きなSMRT CELLをつくればいいのに。 
そういう仕様だと聞いて今まで納得していました。 
カメラサイズの問題だと思いますが、今度Pacのエンジニアに聞いてみます。

②ポリメラーゼの合成速度について、ポリメラーゼ改変体を使っているとのことだが、ポリメラーゼの基質として蛍光ラベルdNTPを使っているため、通常のdNTPより合成速度が遅くなると思うだが、その速度への影響はどの程度なのか、また蛍光ラベルdNTPを用いたことによってDNA合成の正確性は変化するのか。
A: 蛍光ラベルdNTPも確かに速度に影響しますが、私が聞いた説明ですと、カメラの性能が追い付いていないため、わざとポリメラーゼを遅くしている、ということでした。 ここも確認が必要ですね。
蛍光dNTPがDNA合成の正確性に影響を及ぼすか、というのは特に聞いていません。 ゼロではないでしょうが。

一つ前の記事について
③下記表現について
>「ポリメラーゼによって合成される1本のリードに含まれる塩基が、平均して85%は正しく読まれる」 
この15%の高いミスリーディングは何に由来するものか、また欠失・重複等はどの程度含まれるのか。
A: Hybrid Assemblyの記事 にも書きましたが、挿入エラーが多いのがPacの特徴です。 パルスデータがはっきりと正しい数の塩基に変換されないのでしょう。 
どこに原因があるのか、ムービーからトレースデータに変わるところでそもそもエラーが起きるのか? 
トレースデータからパルスデータに変わるときにエラーが起きるのか?
何か特定の配列が読みづらいのか?
これは私も前から興味を持っていたのでいつか書きます。 


>確率的には1/3の割合(厳密にはポアソン分布)で、正しく合成が行われる状態のZMWができるわけです。
場合の数が3通りあるだけで、その3通りが等確率とは限らないと思うだが、この値は理論値か、それとも実験値か。
A: 理論値です。 仰る通り、実験すると33%よりずっと低い値になることもあります。 

今日はもう遅いので。ここまで。

2012年2月17日金曜日

New Chemistry ! - C2 とは

PacBioのシーケンスアプリケーションについて報告です!

現在、インストールしているシーケンサーは、C2という新しいバージョンです。
これからインストールされるものは全て、C2バージョンになります。
世界的にも、すべてのマシンが次々にアップグレードされていく計画です。

今までのC1バージョンとどこが変わったのかというと、
  1. より長く読める(10Kb のライブラリーを読むことができる)
  2. より多く読める(ZMWの穴に1つちゃんと入る「DNA‐ポリメラーゼ」が多くなった)
  3. 解析ソフトウェアがちょっと良くなった
  4. ソフト上でデータのグループ管理ができるようになった
ポリメラーゼ酵素がより安定するように改善されましたので、より長く、より安定して読めるようになったのです。
それに伴って、今までStrobeという、長いライブラリーを飛び飛びに読むプロトコールが無くなりました。 
ショートリードでいう、メイトペア、のかわりにStrobeがあったのですが、もうそのまま10キロ読んじゃえ!ってことでこれは無くなったのです。
実際どれくらい長く読めるのか? というのが気になるところでしょう。
10Kbのライブラリーを作って読んでも、すべてのリードが10Kbというわけではありません。
平均は数Kb、何割かが10Kbいくかどうか。
正確な数値を伏せているのはまだオフィシャルになっていないかもしれないので。
近くお知らせします。

解析ソフトについては、細かい機能がちょこちょこアップデートしたり、バグが直ったりと、いまいち地味ですが、使い勝手はいいと思います。
各セルごとに、塩基ごとのシグナル:ノイズ比がわかるようになりました。
使ったことはまだありませんが、GATKとのインテグレーションができるようになったそうです。

もう少ししたら、カタログもプレゼンも、すべてC2用に変わります。
今までC1で覚えたことが、C2ではいろいろ変わっていて大変ですが、すぐ慣れるでしょう。

そんなところで、明日も頑張ります。

2012年2月8日水曜日

de novo Hybrid Assembly

参照配列が無い生物の配列決定や、転座などの構造変化を見つけるために欠かせないのが、de novo Assembly です。
NGSでde novo Assembly といえば 定番中の定番かもしれませんね。

異なるプラットフォームのリードデータを合わせてアセンブることを Hybrid Assembly と言います。
例えばRoche FLXのロングリードと、イルミナGAIIxのショートリードを一緒にするAssembly のことです。
なぜこんなことをするかというと、ロングリードとショートリードにはそれぞれ一長一短があって、合わせることでそれぞれの短所を補いつつ、長所を生かしてより長い、より正確なContig を作れるからです。


先日、The Plant and Animal Genomes Meeting というのがサンディエゴでありました。 実際行ってはいませんが、そこで Cold Spring Harbor Laboratory の Michael Schatz 博士が、PacBioを使ったHybrid Assembly の講演をしましたので紹介します。
プレゼンのスライドは、Schatz博士のサイトにアップされていますので興味のあるかたはどうぞ(ここをクリック!)。

Schatz博士は、PacBio だけで酵母ゲノムを読んだところ、エラーに特徴があることがわかりました。
それは、
ミスマッチエラー(1.4%)よりも挿入(11.5%)や欠損(3.4%)が多いということでした。
全体的なエラーは83.7%で、Pacとしてはまあまあの値です。
ちなみに65個のSMRT Cellを使用して、734,151本のリード(フィルタリング後)を得ています。
12メガbpのゲノムで、です。
Schatz博士のプレゼンより引用


Pacのリードの特徴は、ご存じの通り、長く読めることです。 最新バージョンでは運が良ければ最高10kbまで読める!? かも。
長く読めるということは、大きなギャップやリピート配列も読める、という利点があります。
GCバイアスが無いということも相まって、読める場所と読めない場所に偏りが少ない、という利点もあります。

しかーし、出力される本数が少ないですし、エラー率がちょっと高め? なので、そこはハイスループットのショートリードシーケンサーたちの出番となるわけです。

そこでHybrid Assembly が必要になります。

では、Schatz博士の話に戻ります。
昨年、他のポスターにも発表していましたが、Schatz博士は以下の手順でパイプラインを組んでいます。
  1. ショートリード配列をトリムし、フィルタリングする
  2. きれいになったショートリードをPacBioのロングリードにマッピングする
  3. カバレージとギャップに基づいて、明らかに読み間違いと思われる場所はトリムする
  4. それぞれのロングリードw/ショートリードマッピングをもとにコンセンサス配列を作成し
  5. エラーが無くなったリードを使ってアセンブルする
近いうちに詳細は論文で明らかになりますが、面白いのは、アセンブラーに、Celera Assembler というクラシカルなもの(の改良版)を使っていることです。
Sanger からNGS に行き、また戻ってきた懐かしい感がしました。
また、上記、エラーを除去しているステップは、pacBioToCAというオープンソースで公開されています。

Schatz博士は講演の最後に、高等生物のde novo Assembly についても触れています。
ゲノムサイズ1.23Gbpのオウムです。
3パターンのアセンブルを試していました。
  1. Illumina の194X (インサート長が220、500、800bpのペアエンドと、同じく2K、5K、10Kbpのメイトペア)
  2. Roche 454 の15.4X(FLXとFLX Plus、3K、8K、10Kbpのペアエンド)
  3. Roche 454 の15.4X とPacBio 3.75X
IlluminaのみだとContig数が24,181で、N50が47,383bp、最長Contigは1,050,202bp
RocheのみだとContig数が16,574で、N50が75,178bp、最長Contigは75,729bp
PacとRocheだとContig数が15,081で、N50が99,573bp、最長Contigは1,238,843bp
(個人的にはPacとIlluminaがほしかった・・・)

PacとRocheの組み合わせで、他と比べて、より長いContigが多く作られたことがわかります。
とはいっても、ゲノムサイズ1.23Gのうち、1.07Gしか読めていませんでした。
それにまだ、15,000以上のContigがつながらずにできてしまうのですね。
de novo Assembly は大変です。
他の生物(バクテリアとか)でも試されているようですので、詳しくは先程のリンクからSchatz博士のプレゼンPDFの最後の方のテーブルを参照のほど。

これはその一部


2012年1月31日火曜日

とりあえず装置について

最近特に寒いですね。
うちの近所の雪がまだ融けません。 もう1週間近く経つのに。

今日は、PacBio RSの装置について書きます。


左の少し小さい黒い箱が、Blade Centerという名のサーバーです。
ここではシーケンサーからでてきたデータの一次解析を行います。
一次解析については別の日に詳しく書きます。
実際は、このBlade Centerと隣のシーケンサーはLANケーブルでつながれています。
そしてシーケンスデータは、Blade Centerからユーザの用意した二次解析用サーバーに転送されます。

このBlade Centerは、ユーザは直接触ることはできません。
PacBioの人間か、私たちDistributorの人間が、機械の調整を行ったり、ログを取ったり、通信試験をしたりするときにPCをつなげることはあります。
ちなみにこのBlade Centerは、アメリカのPac本社から遠隔で操作することができます。 何か不具合があったときの原因究明のため、ログだけは取れるようになっているのです。(ユーザの協力が必要)


シーケンサー本体の、上のタッチパネルはRS Touchという操作画面です。
ランを設定するときに使います。 
ランが動いているときは、あとどれだけ時間がかかるか、という情報が、SMRT Cellの蛍光のきれいなネオンと共にが表示されます。


シーケンサー下の左から順に、Wasteボックス、試薬・サンプルローダー、SMRT Cell・チップローダー、水タンク、があります。

試薬プレートとサンプルを格納する引出し、SMRT Cellとチップ(Tip)をのせる引出し、はボタンを押すと厳かに開閉されます。
たまに、ちゃんと閉じないでランプが点滅していることがあるそうなので、そういうときは再度閉めましょう。
この試薬プレートやチップは純正品を使います。代替品では収まりません。
全ては専用のキットを用いるのです。

PacBioのYouTubeより


Wasteボックスには使用した後のSMRT Cellが捨てられます。
このボックスは閉めるときに真ん中あたりを押してしっかり閉めましょう。

水タンクは適度な湿気を維持するために必要です。
ボタンを押すと扉が開いて、中に1リットルのペットボトルみたいな容器があり、そこに水が入っています。
個人的には、ここを開け閉めする扉のスピードが好きです。
スターウオーズに出てくる宇宙船内の扉を連想させます。 エンジニアのこだわりでしょうか?

と、まあ、ユーザーが目にする場所の装置の説明でした。

今後は、
  1. PacBioはどんな研究に用いられるべきか
  2. 論文ではどのように使用されているか
  3. ライブラリーはどうやって作るか
  4. IT関連はどれくらいのスペックが必要か
  5. 一次解析はどうやって行われるか
  6. PacBioに付属する解析ソフトウェアにはどんなものがあるか
  7. PacBioデータを扱える他のソフトウェアにはどんなものがあるか
  8. その他苦労話(これは書けないか!?)
ということを中心に紹介していこうと思います。(順不同になりますが)

スクリーンショットは主に、PacBio社のサイトやYouTube、プレゼンテーションから引用します。
当たり前ですがConfidentialなものは一切ありませんので、ご安心ください。

2012年1月24日火曜日

Movie って?

前回、45分とか75分とか、Movieの時間を最後に書きましたが、説明が足りなかったので付け足します。

PacBioは、ほかの次世代シーケンサーと違って、DNA合成の様子をビデオで撮ります。
SMRT Cellの中には150,000のZMWがあり、この中でDNA合成が行われるわけです。
ヌクレオチドが取り込まれるときに、リン酸についた蛍光が自動的に切り離され、そのときCellの下からあてているレーザーの波長に励起して、A、T、C、Gに特徴的な波形データが得られます。

「自動的に切り離される」ので、Real Timeなわけです。
Wash & Detect ではないので、反応は止めません。
そこで、カメラによる撮影ではなく、ムービーなのです。

150,000のZMWは、ポリメラーゼが入っていなくても、とりあえずMovieは撮られます。

例えば2kbくらいのインサートの場合、それほど長く撮影しなくても良いので、30分くらい読むとします。
この設定にすると、150,000のZMWは2回に分けて撮影されます(各75,000ZMW)。
1回目のムービーと、2回目のムービーで撮影されるZMWは別々で、それぞれ30分間撮影されます。

今は例として30分にしましたが、長いインサートの場合、最高75分まで撮影することができます。
しかし、75分では1回のムービーしか撮られません。
1回のムービーで撮影できるZMWは75,000なので、75分のムービーではCellの半分のZMWしか実際は読んでいないことになりますね。

なぜ長い時間のムービーは1回しか撮られないのでしょうか。

30分を2回撮る場合は、1回目のムービーの時、読まれている75,000ZMW以外の、2回目のムービーで読まれるはずの75,000ZMWでも反応は行われているのです。
2回目のムービーでに読まれるZMWでは、もうすでに30分以上、反応が進んでいるので、ポリメラーゼが弱っています。
したがって、1回目のムービーで読まれるZMWのデータより、2回目のムービーで読まれるZMWのデータの方が、「若干弱気」です。

75分も読んだら、2回目のムービーはもうすでに75分以上経っているのでポリメラーゼはかなりヘタっていることは想像できるでしょう。
他にも理由はありますが、これも長い時間のムービーは1回しか撮られない理由です。

ちなみに、ZMW内のポリメラーゼは、1秒間に1~3くらいの塩基を合成しています。
WTのポリメラーゼはもっと高速でしょうが、それでは機械の検出技術が追い付かないので、わざと遅いMutantを作って使っているのです。